Назад
19 сентября 2026 г. в 13:55 AI LLM Apple Silicon LM Studio Qwen Источник

LM Studio добавила Splash — быстрый движок для локального Qwen на Mac
LM Studio добавила Splash — быстрый движок для локального Qwen на Mac

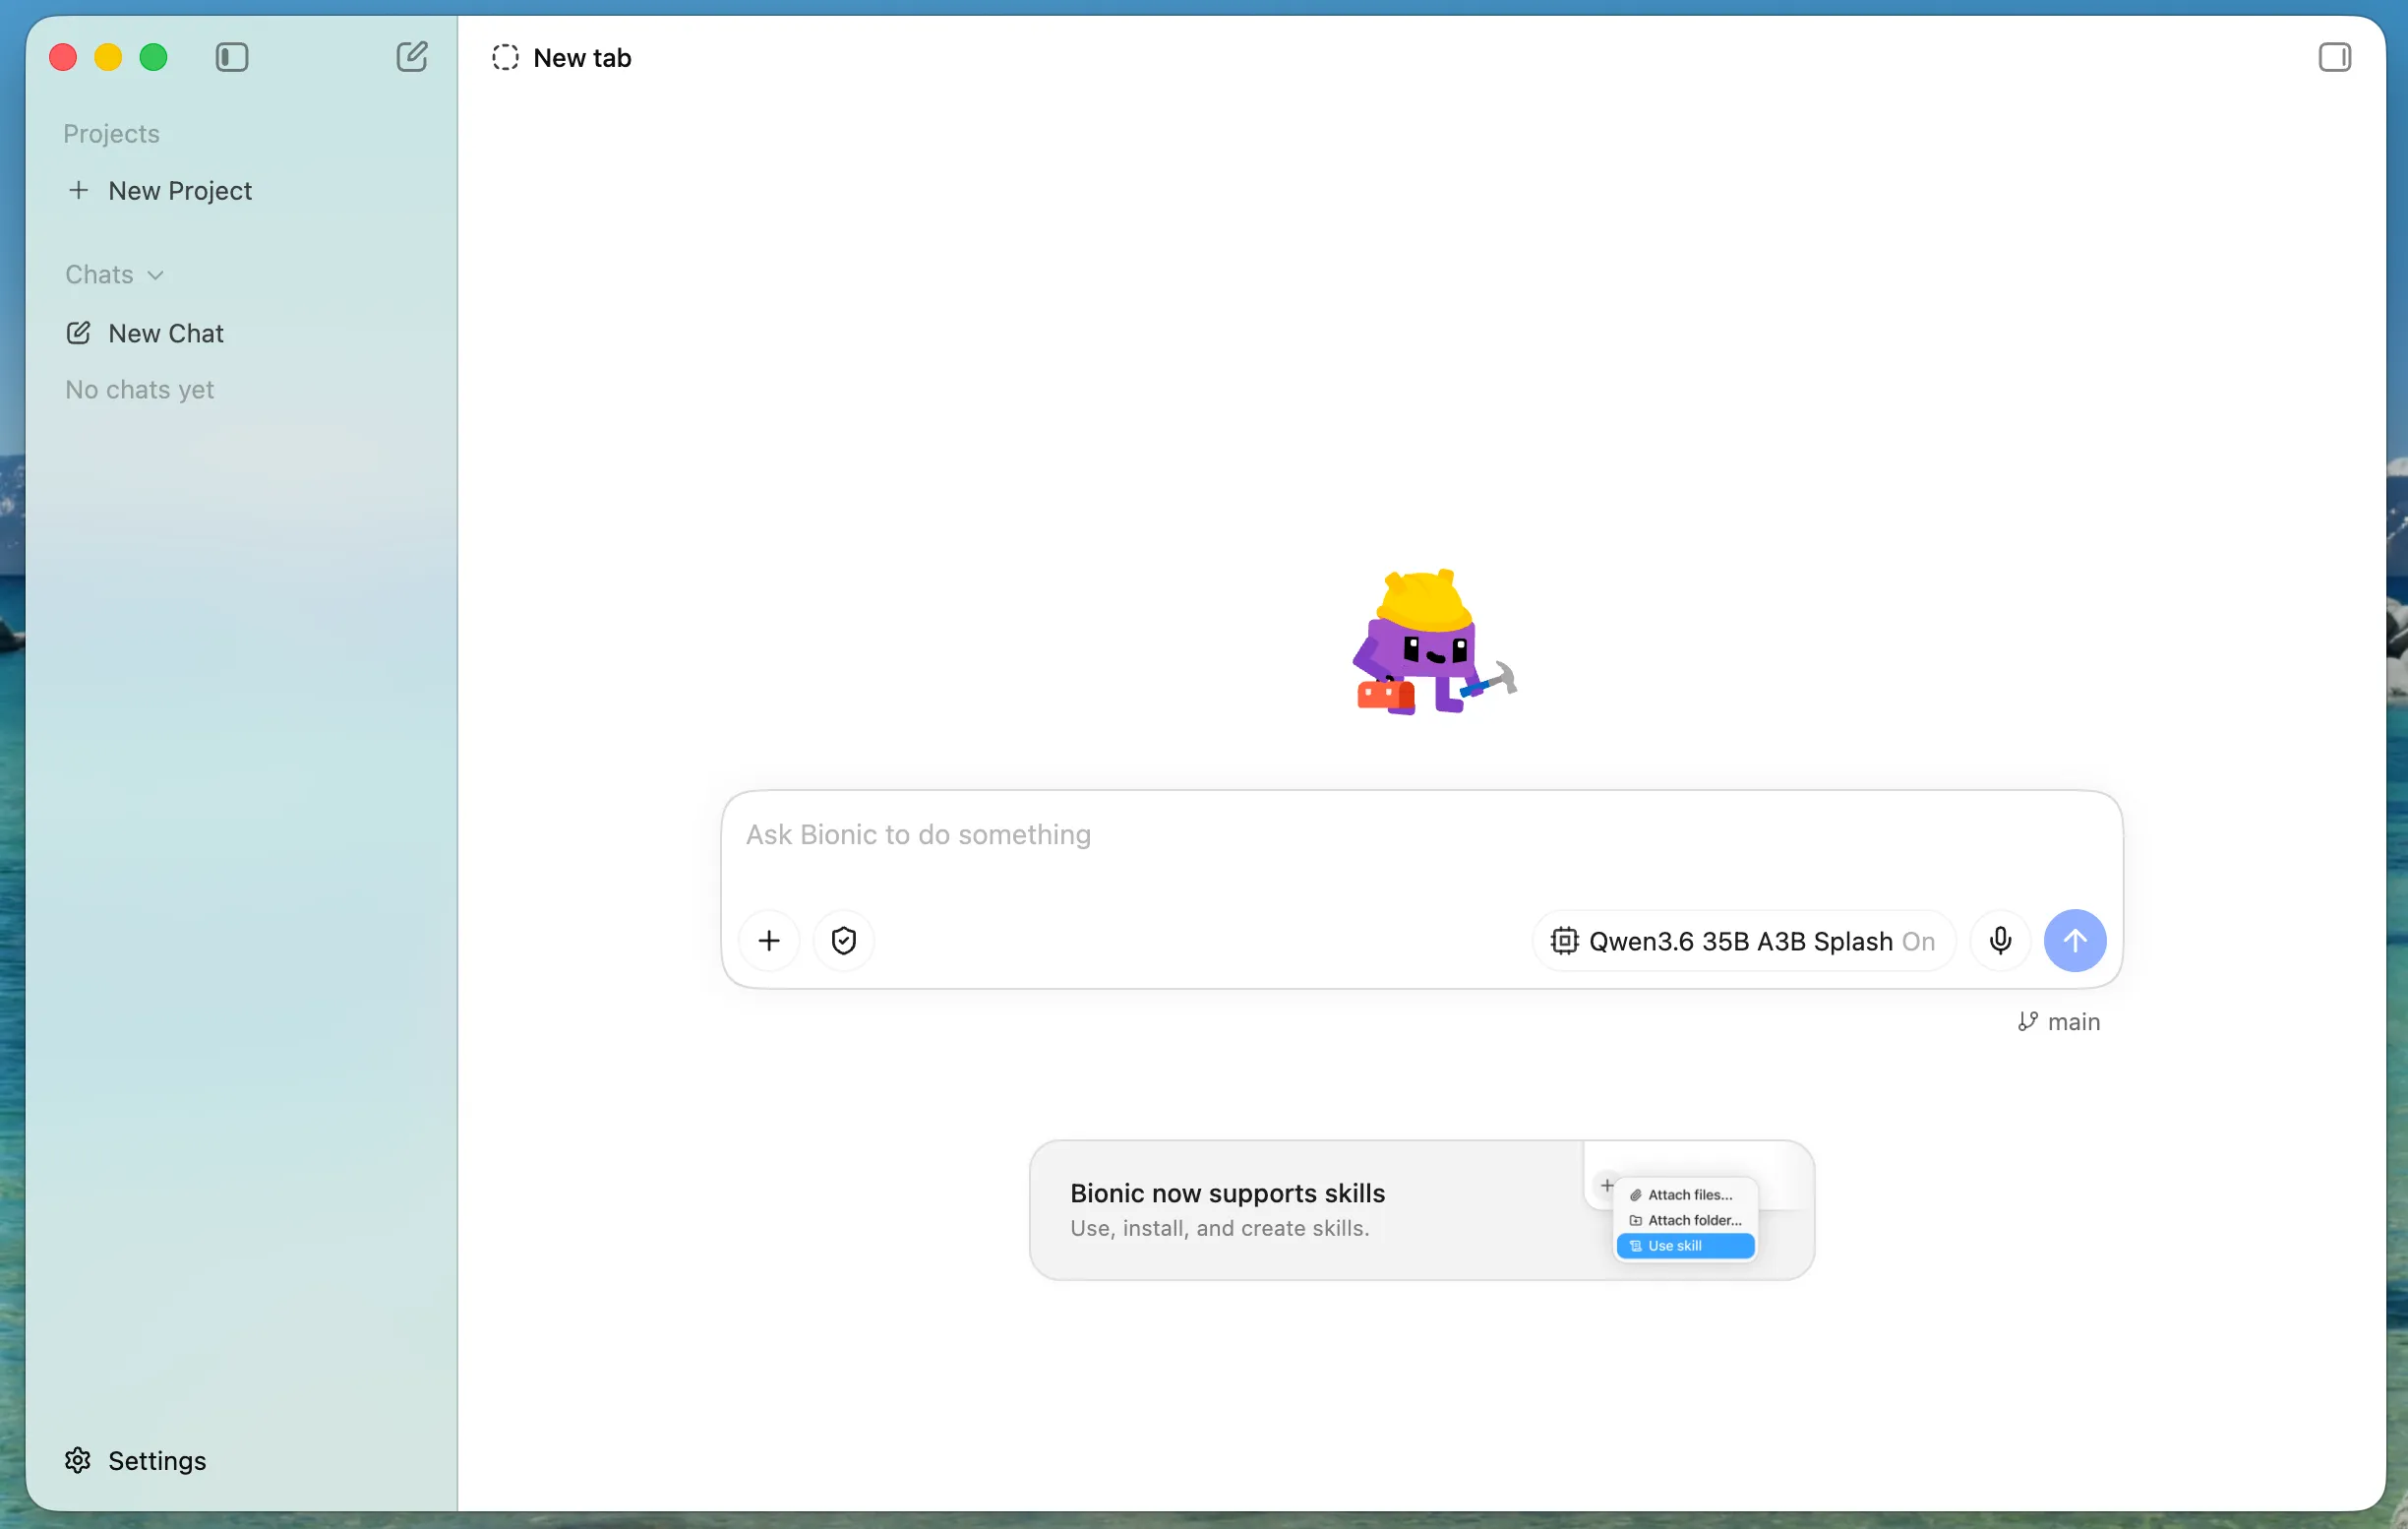
У локальных моделей на Mac появился ещё один способ стать быстрее — но не для любого железа и не для любого Qwen. LM Studio 18 сентября добавила в версию Bionic экспериментальный движок Splash от Inco AI. Он предназначен для запуска моделей прямо на Apple Silicon и пока заточен под Qwen3.6-35B-A3B и Qwen3.8-27B.

Главная деталь здесь не «новый бэкенд», а узкая оптимизация. Splash использует отдельные GPU-ядра и схему работы с памятью для этих моделей, а также draft-модель DFlash 2 для speculative decoding: маленькая модель предлагает продолжения, а основная быстро их проверяет. Это может сократить время между ответами, не превращая ускорение в бесплатный апгрейд для всех локальных LLM.

Что обещают цифры

По данным Inco AI, на Mac с M5 Pro и 48 ГБ памяти Splash выдал около 74 токенов в секунду на коротких запросах для Qwen3.8-27B и 54 токена в секунду при контексте 32K. При четырёх параллельных запросах суммарная производительность достигла 170 токенов в секунду. Это результаты разработчика, а не независимый бенчмарк: реальная скорость будет зависеть от Mac, длины контекста и нагрузки.
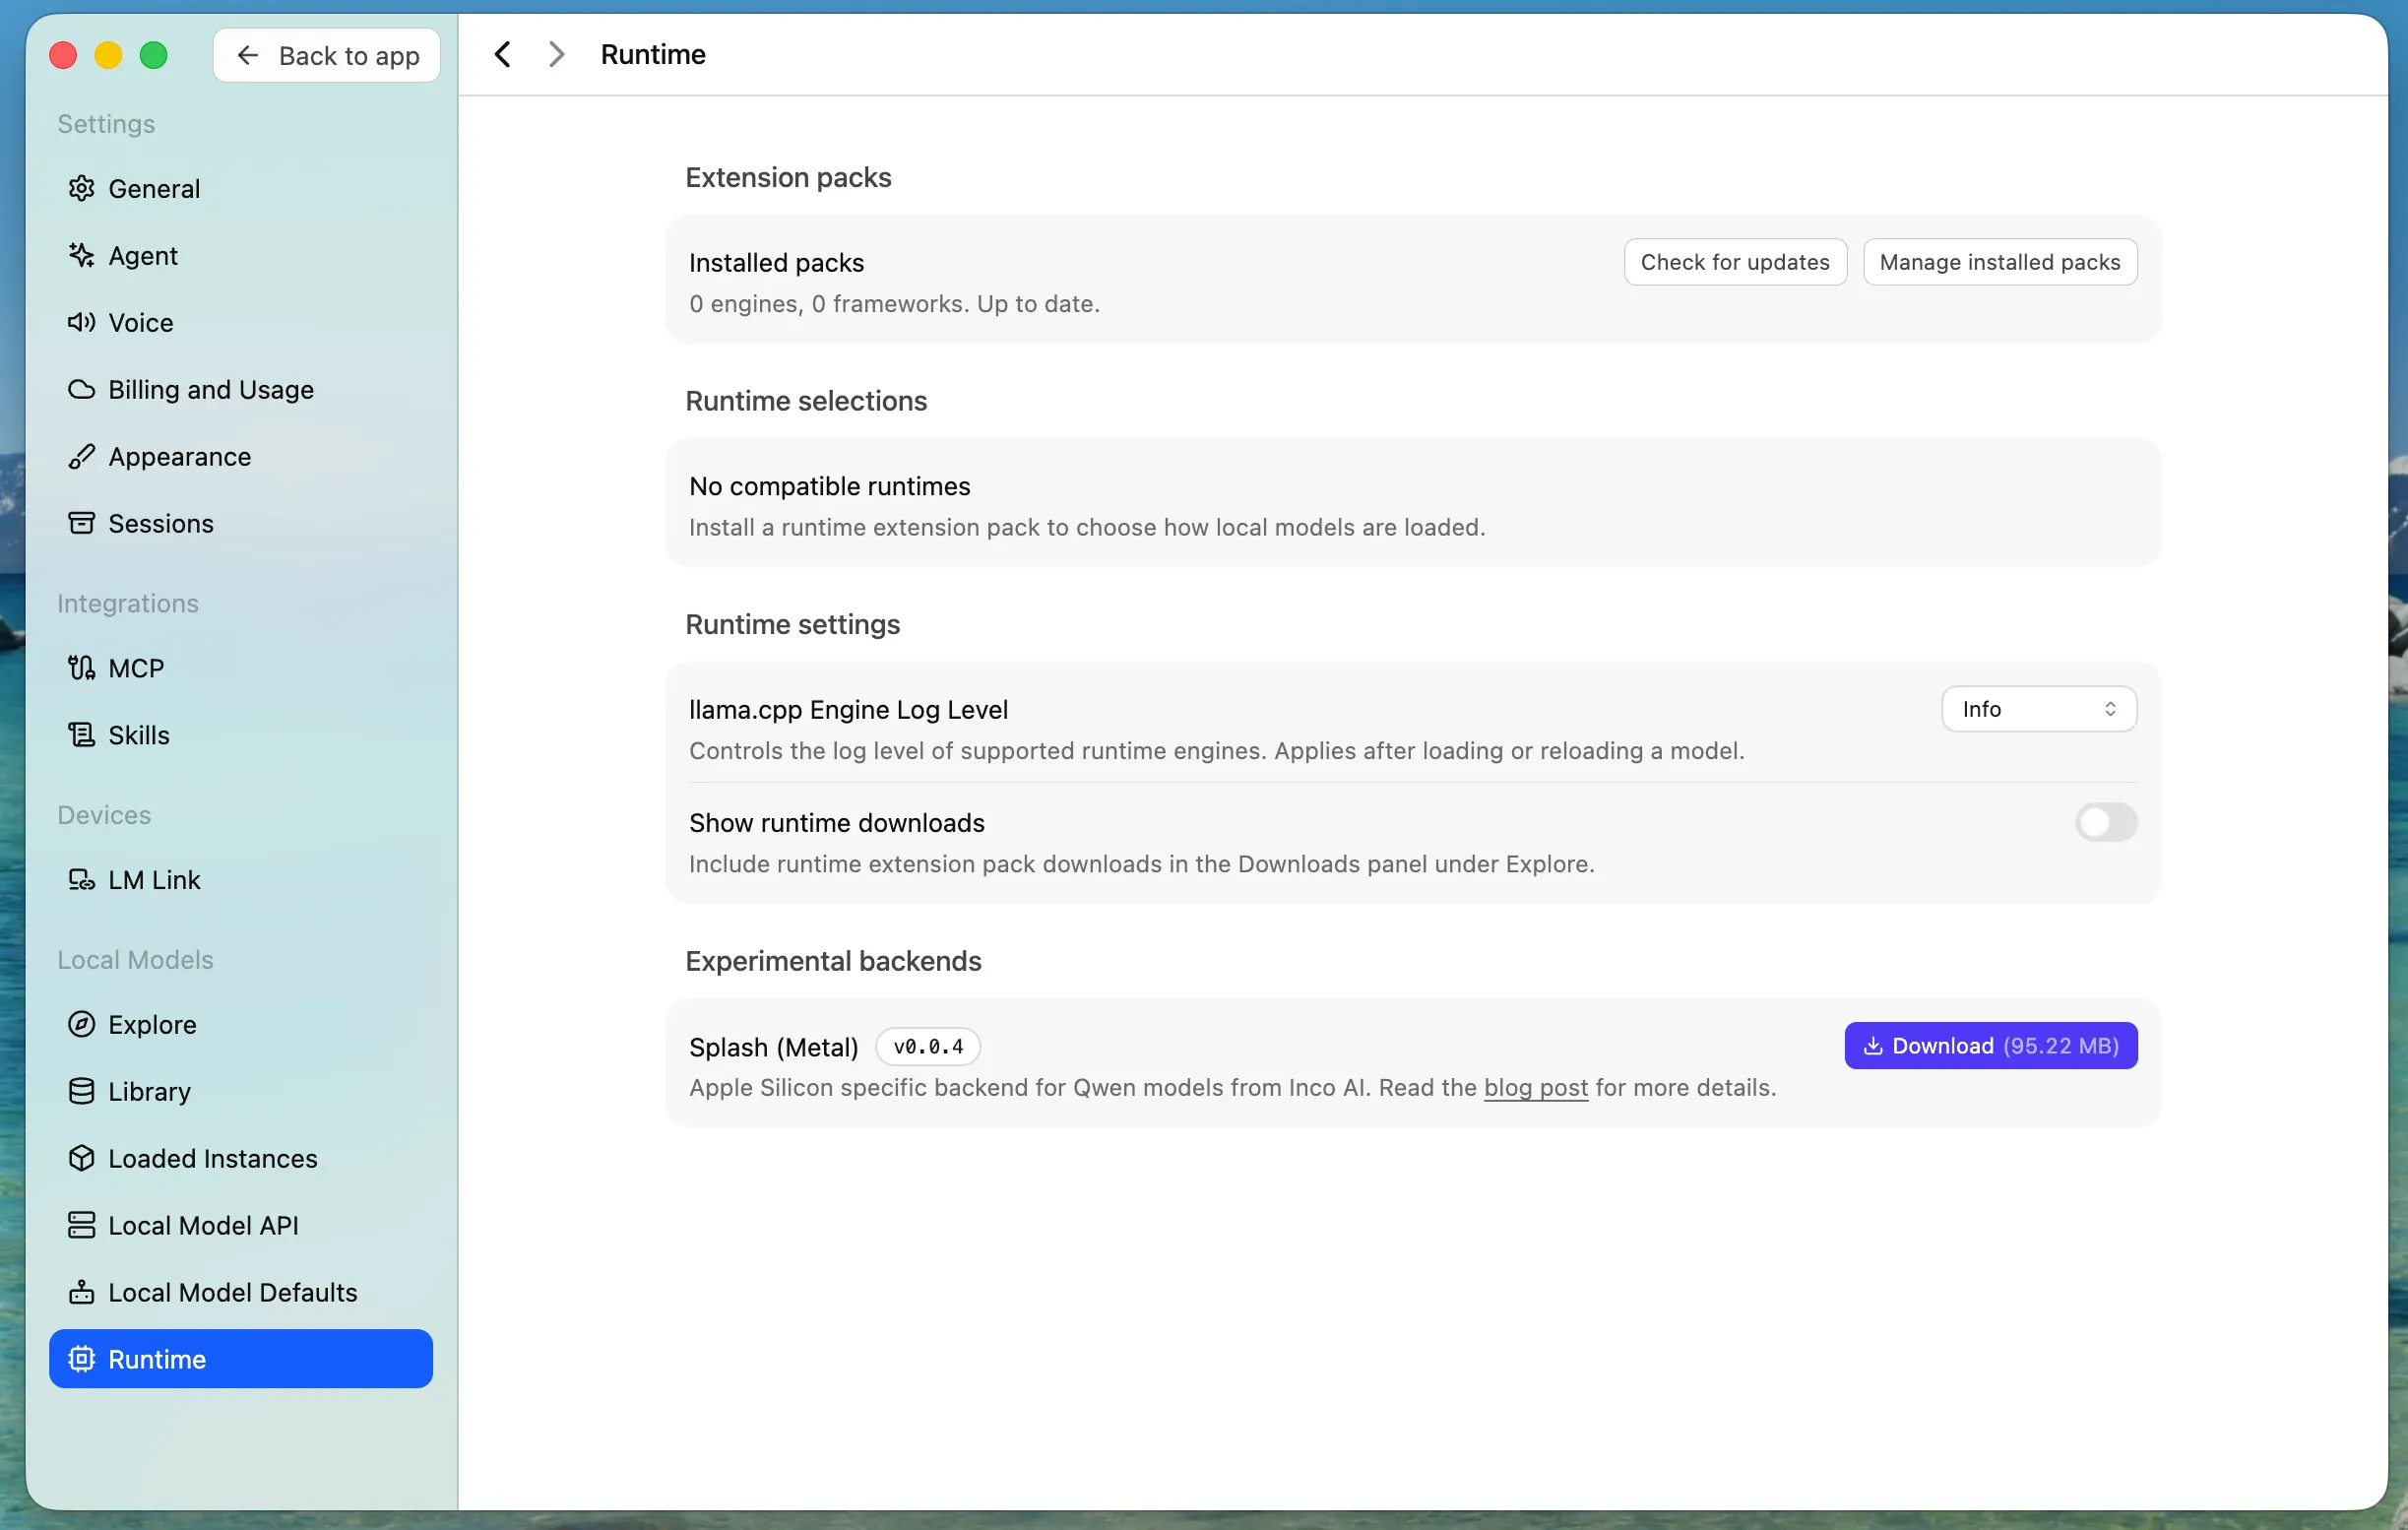
Настройки Runtime в LM Studio Bionic с кнопкой загрузки Splash (Metal) в разделе экспериментальных бэкендов

Скриншот: LM Studio.

Кому это действительно доступно

В LM Studio нужно открыть Settings → Runtime и загрузить Splash (Metal), затем выбрать поддерживаемую Qwen в разделе Explore. Ограничения существенны: нужен Mac на M3 или новее, macOS 26.4 или новее и как минимум 36 ГБ объединённой памяти; Inco рекомендует 48 ГБ и больше.

Это важнее громкой цифры «вдвое быстрее». Для владельца MacBook с 16 ГБ новость не добавляет производительности — движок просто не предназначен для такой конфигурации. Зато разработчикам с мощным Apple Silicon он показывает более практичный путь: ускорять локального агента можно не только сменой модели, но и точной связкой движка, памяти и конкретного семейства весов.
Полное описание и инструкция — в блоге LM Studio.

Ещё новости

Google вынес Guided Learning в Classroom: что показали тесты
3 ноября 2026 г.
Google вынес Guided Learning в Classroom: что показали тесты

Google начинает глобально разворачивать Guided Learning в Classroom. В контролируемом исследовании с более чем 300 студентами доступ к инструменту совпал с более высоким приростом результатов, но это ещё не доказательство для всех школьных сценариев.

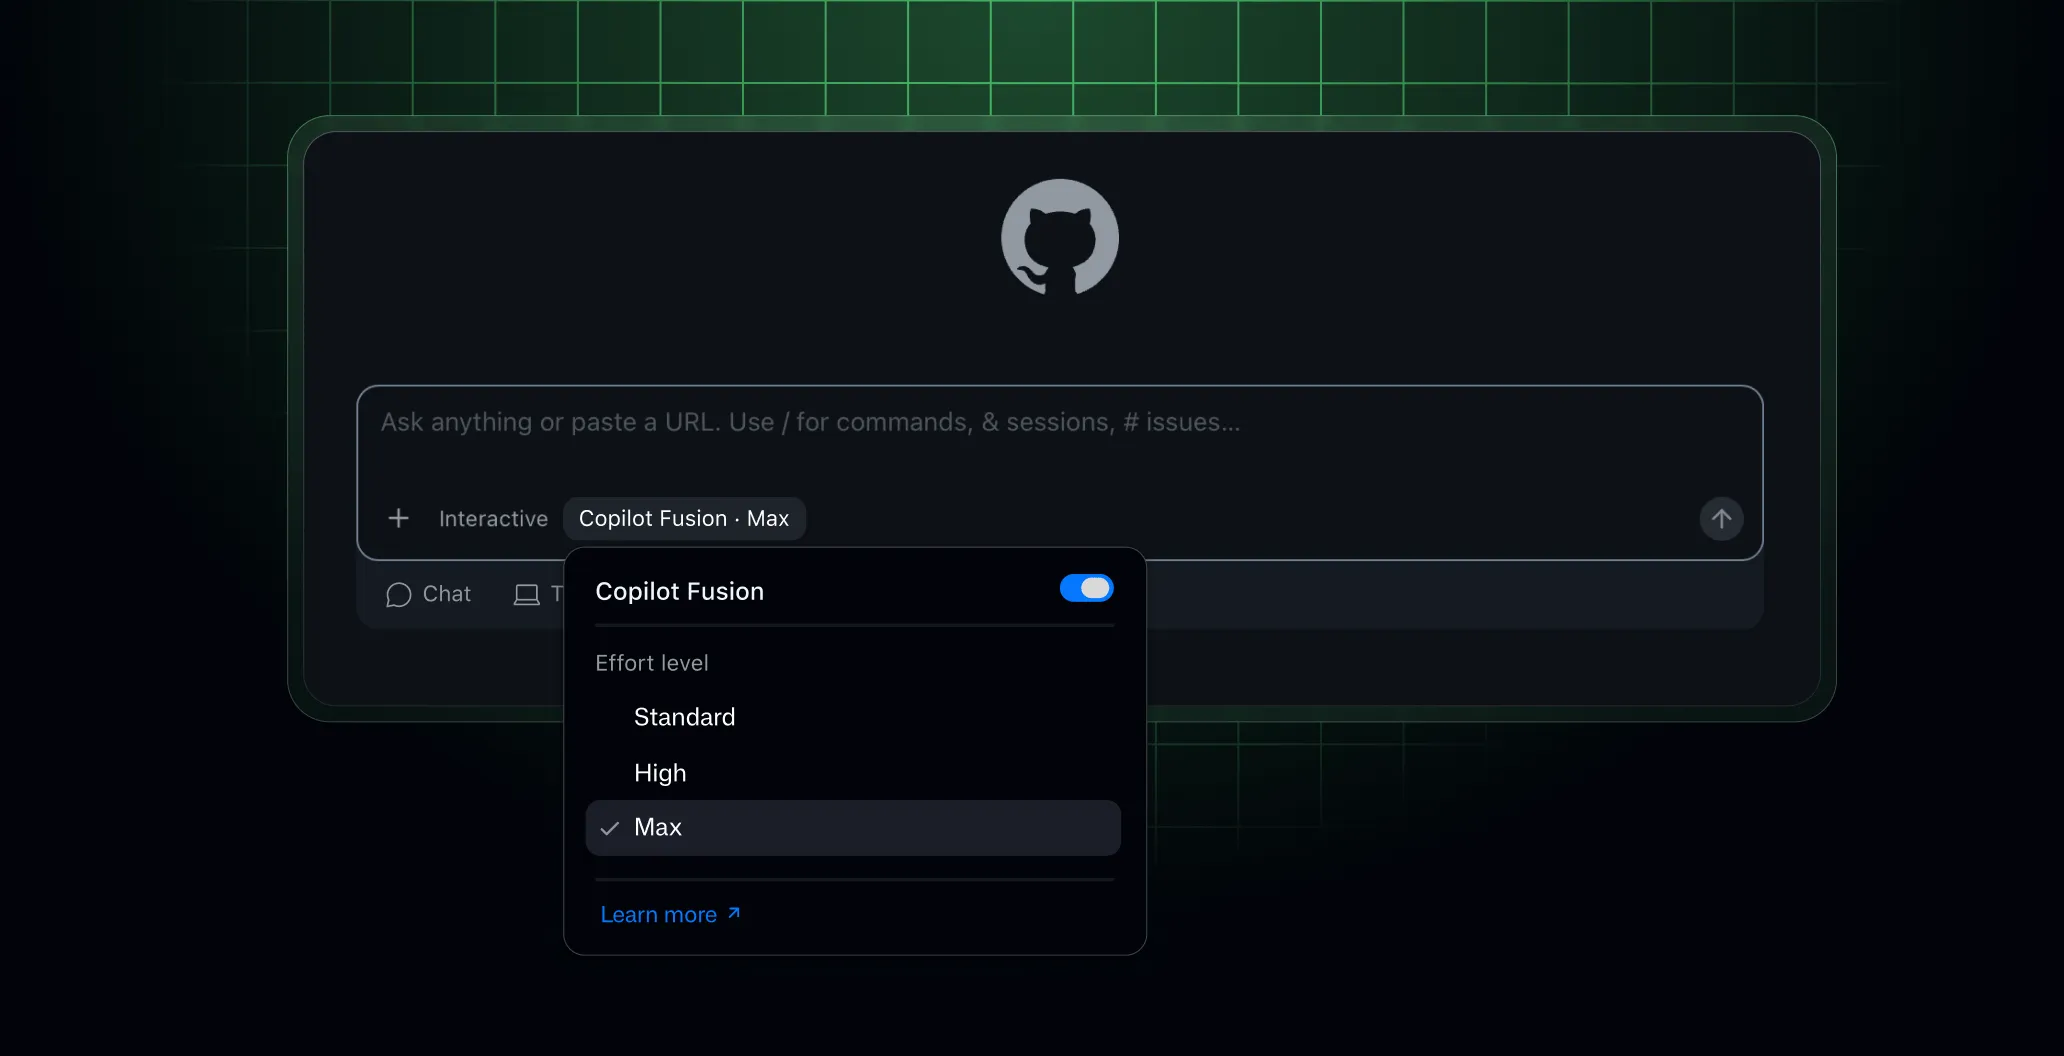
GitHub Copilot Fusion сам выбирает модели для задачи
3 ноября 2026 г.
GitHub Copilot Fusion сам выбирает модели для задачи

GitHub вывел Copilot Fusion в общую доступность: режим сам подбирает и комбинирует модели для задачи. Для разработчика это уменьшает ручной выбор модели, но не отменяет контроль расходов и корпоративных политик.

Пенсильвания ввела правила для обманной AI-рекламы
3 ноября 2026 г.
Пенсильвания ввела правила для обманной AI-рекламы

Новый закон Пенсильвании требует заметно раскрывать использование синтетического контента, когда он создаёт ложное впечатление о товаре или услуге.

Кибератака на Selver: в холодильной системе выставили +50 °C
2 ноября 2026 г.
Кибератака на Selver: в холодильной системе выставили +50 °C

В одном из эстонских магазинов Selver атаковали систему охлаждения: по сообщению Postimees, в ней попытались установить температуру +50 °C. Selver заявляет, что партнёр быстро обнаружил инцидент, магазин не понёс ущерба, а товары и покупатели не пострадали.

Gemini Notebook открыл сотни бесплатных учебников
2 ноября 2026 г.
Gemini Notebook открыл сотни бесплатных учебников

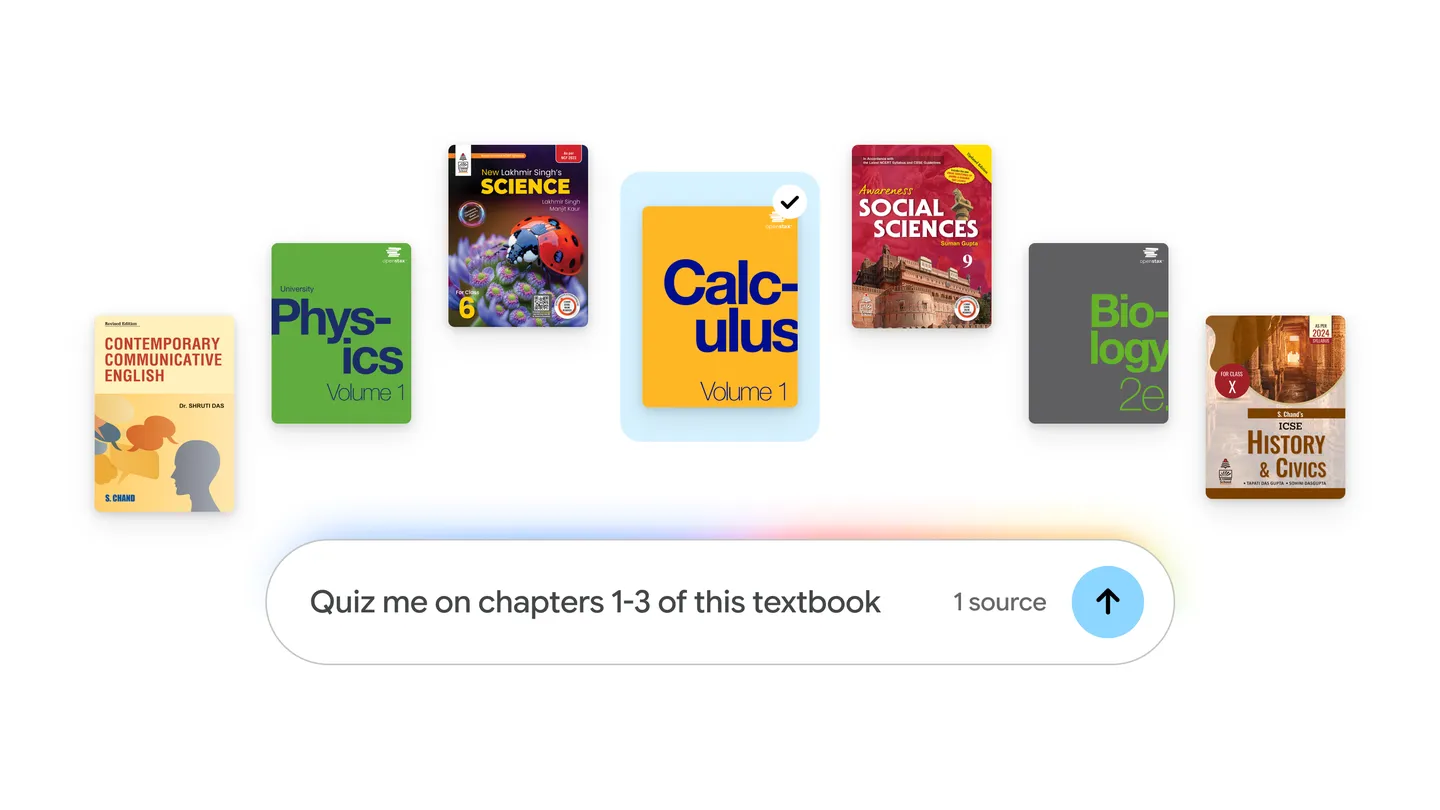
Google добавила в Gemini Notebook каталог из сотен учебников от OpenStax, Open Textbook Library и S Chand Publishing. По каждому подключённому учебнику сервис обещает ответы с привязкой к тексту и ссылками на исходные фрагменты. Это делает ИИ удобнее для подготовки, но не отменяет проверку его выводов.

GPT-6 Astra изменила 0,016% весов Qwen и подняла MATH-500 с 7,9% до 48,1%
2 ноября 2026 г.
GPT-6 Astra изменила 0,016% весов Qwen и подняла MATH-500 с 7,9% до 48,1%

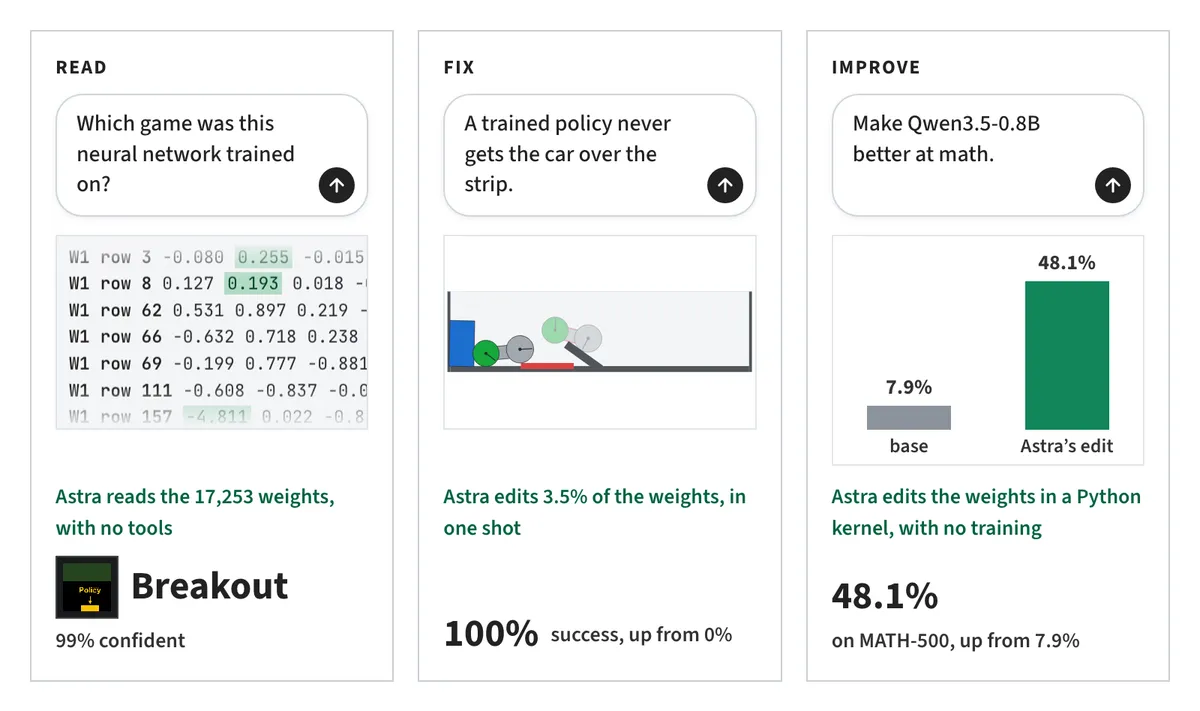
Исследователи, связанные с MIT CSAIL, выложили открытые логи эксперимента, в котором GPT-6 Astra напрямую изменила небольшую часть весов Qwen3.5-0.8B. После одной из правок авторы зафиксировали рост на математических тестах и IFEval, но это ранняя работа с оценкой в собственной экспериментальной среде.

Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач
2 ноября 2026 г.
Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач

SemiAnalysis запустила GDPx — бенчмарк агентных моделей на задачах из 11 дорогих для бизнеса областей. По данным авторов, лучший результат пока составляет лишь 12%: эффектные демо ещё не равны надёжной автономной работе.

Google получила первый ответ ИИ с орбитального TPU
1 ноября 2026 г.
Google получила первый ответ ИИ с орбитального TPU

Google получила первый ответ от модели Gemma 4, запущенной на TPU на спутнике Project Suncatcher. Это подтверждает работу вычислительной нагрузки на орбите, но не доказывает жизнеспособность космического дата-центра.

DeepSeek показал прототип «суперагента» для GitHub
1 ноября 2026 г.
DeepSeek показал прототип «суперагента» для GitHub

DeepSeek опубликовала исследовательский прототип dsh-superagent: он следит за событиями в одном репозитории GitHub, запускает отдельные агентные сессии и возвращает результат в исходный диалог.

Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять
1 ноября 2026 г.
Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять

В ядре Linux исправили критическую CVE-2026-98432: ошибка в IPv4/TCP при неблагоприятных условиях может дать удалённому неаутентифицированному атакующему выполнение кода. Владельцам серверов стоит проверить статус ядра у своего дистрибутива и запланировать обновление, особенно если система принимает соединения из недоверенных сетей.

ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям
31 октября 2026 г.
ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям

Sakana AI и исследователи из Оксфорда показали The AI Scientist: LLM-агент генерирует гипотезы, меняет код, запускает эксперименты и пишет отчёты по задачам машинного обучения. Работа — проверяемый пример того, как модели участвуют в поиске улучшений для других моделей, но сами авторы фиксируют критические ошибки и не призывают верить результатам без перепроверки.

StepSecurity начала учитывать плагины Claude Code и Codex
31 октября 2026 г.
StepSecurity начала учитывать плагины Claude Code и Codex

StepSecurity добавила инвентаризацию плагинов AI-агентов на машинах разработчиков и в репозиториях GitHub. Инструмент показывает, откуда пришёл плагин, что в нём находится и где он включён — то есть закрывает новую дыру в цепочке поставки кода.