Назад
2 ноября 2026 г. в 05:00 AI Agents AI Benchmark Claude OpenAI Gemini Источник

Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач
Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач

Новый бенчмарк GDPx от SemiAnalysis звучит отрезвляюще: даже лучший участник проходит лишь 12% набора задач, которые авторы считают важными для «фронтирных» ИИ-агентов. Это не тест на красивый ответ в чате, а попытка проверить, доводит ли модель до конца работу с инструментами и реальными рабочими артефактами.

GDPx охватывает 11 областей: проектирование чипов, кибербезопасность, биологию, финансы, право, количественную торговлю, разработку ПО, hardware design, materials science, alignment и задачи самосовершенствования. Для набора SemiAnalysis работала с 14 профильными партнёрами; на сайте указаны 206 задач.

Не путать рейтинг с готовым сотрудником

Авторы называют Claude Opus 5.5 лучшей универсальной моделью в их таблице: она лидирует в quantitative trading, hardware design и chip design. Gemini 4 Carbon, по их данным, лучше справляется с биологией и немного опережает конкурентов в разработке ПО; GPT-6 Astra лидирует в задачах самосовершенствования и материаловедения.
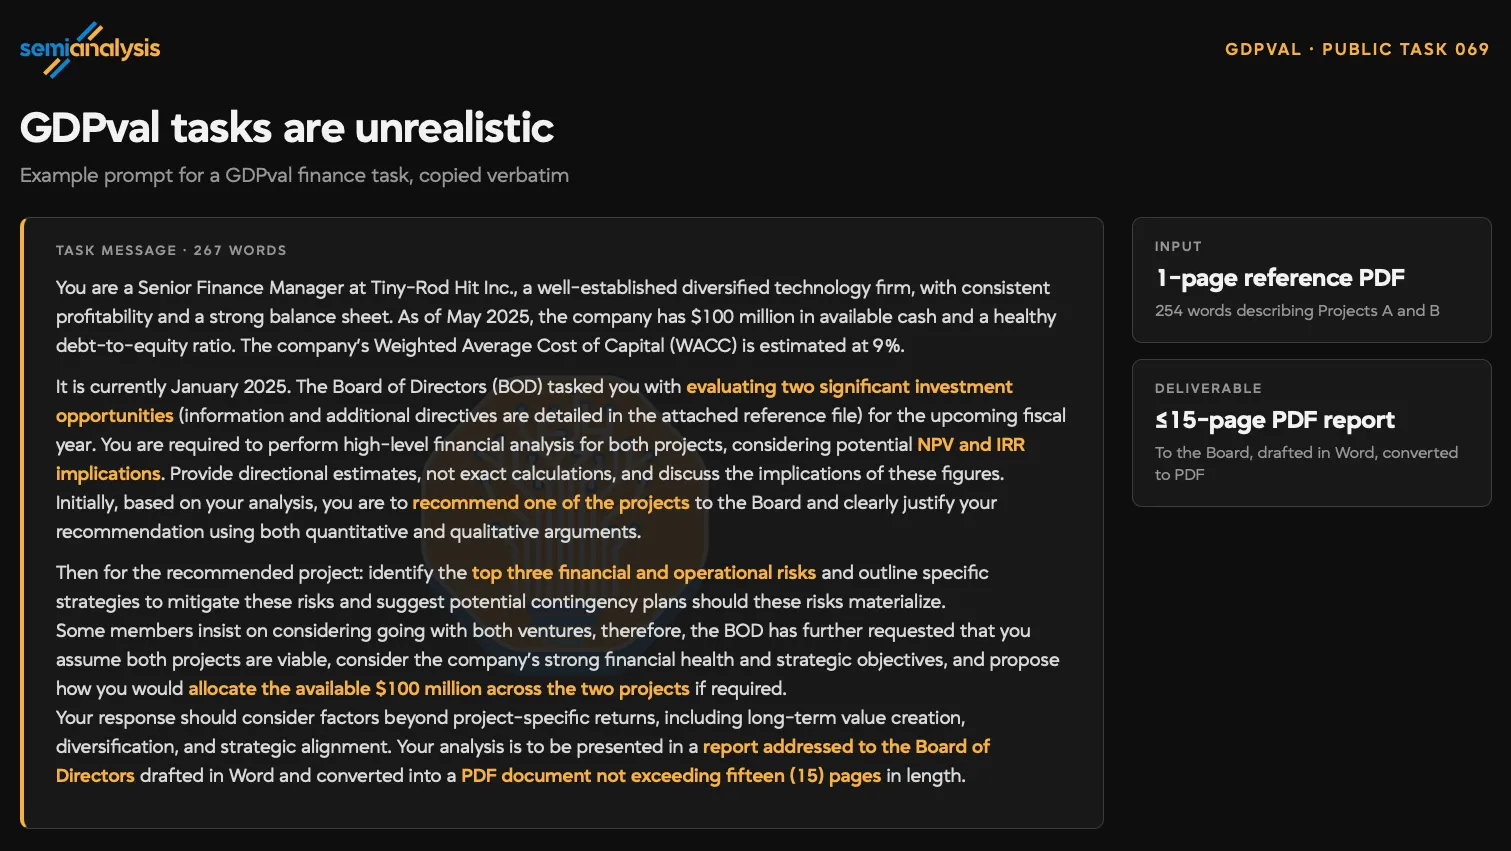
Сравнение моделей в GDPx показывает различия результатов по прикладным агентным задачам

График: SemiAnalysis / GDPx.

Но важнее не спор за первое место, а потолок результатов. В финансах и праве все модели в этом наборе получили ноль. В разборе авторы приводят типичные сбои: модель может правильно посчитать число, но пропустить устаревший документ, неверно понять договорное условие или не заметить последствия собственного решения.

Почему это важно для внедрения

GDPx — исследовательский продукт SemiAnalysis, а не нейтральный государственный стандарт, поэтому его результаты нельзя превращать в окончательный вердикт о моделях. Авторы также отмечают, что встроенные фильтры безопасности могут понижать итоговый балл в кибербезопасности, биологии и alignment.

Однако практический вывод полезен уже сейчас. Если агент получает доступ к таблицам, коду или документам, его стоит внедрять как исполнителя с проверкой результата, а не как автономного сотрудника. Хороший балл в одной области не гарантирует надёжность в соседней: для реальной команды важнее тест на собственных данных, журнал действий и человек, который может остановить ошибку.

Редакционная QA: использован официальный график из публикации SemiAnalysis — он показывает предмет статьи, результаты сравнения моделей. Дополнительный embed не добавлен: интерактивный live-лидерборд уже доступен по ссылке GDPx, а статичный график рядом с объяснением даёт читателю достаточный контекст.
Ещё новости

Google получила первый ответ ИИ с орбитального TPU
1 ноября 2026 г.
Google получила первый ответ ИИ с орбитального TPU

Google получила первый ответ от модели Gemma 4, запущенной на TPU на спутнике Project Suncatcher. Это подтверждает работу вычислительной нагрузки на орбите, но не доказывает жизнеспособность космического дата-центра.

DeepSeek показал прототип «суперагента» для GitHub
1 ноября 2026 г.
DeepSeek показал прототип «суперагента» для GitHub

DeepSeek опубликовала исследовательский прототип dsh-superagent: он следит за событиями в одном репозитории GitHub, запускает отдельные агентные сессии и возвращает результат в исходный диалог.

Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять
1 ноября 2026 г.
Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять

В ядре Linux исправили критическую CVE-2026-98432: ошибка в IPv4/TCP при неблагоприятных условиях может дать удалённому неаутентифицированному атакующему выполнение кода. Владельцам серверов стоит проверить статус ядра у своего дистрибутива и запланировать обновление, особенно если система принимает соединения из недоверенных сетей.

ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям
31 октября 2026 г.
ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям

Sakana AI и исследователи из Оксфорда показали The AI Scientist: LLM-агент генерирует гипотезы, меняет код, запускает эксперименты и пишет отчёты по задачам машинного обучения. Работа — проверяемый пример того, как модели участвуют в поиске улучшений для других моделей, но сами авторы фиксируют критические ошибки и не призывают верить результатам без перепроверки.

StepSecurity начала учитывать плагины Claude Code и Codex
31 октября 2026 г.
StepSecurity начала учитывать плагины Claude Code и Codex

StepSecurity добавила инвентаризацию плагинов AI-агентов на машинах разработчиков и в репозиториях GitHub. Инструмент показывает, откуда пришёл плагин, что в нём находится и где он включён — то есть закрывает новую дыру в цепочке поставки кода.

Фейковые ChatGPT и Claude прячут майнер рядом с подписанными программами
31 октября 2026 г.
Фейковые ChatGPT и Claude прячут майнер рядом с подписанными программами

Исследователи Check Point описали кампанию Yoba: поддельные проекты на GitHub выдают себя за приложения ChatGPT и Claude, а вредоносный код запускают рядом с настоящими подписанными файлами.

Gemini научился редактировать PDF и документы прямо в чате
30 октября 2026 г.
Gemini научился редактировать PDF и документы прямо в чате

В приложении Gemini теперь можно создавать, просматривать и править PDF, документы, таблицы, презентации и код внутри диалога. PDF работает в вебе и на мобильных устройствах; остальные форматы пока доступны только в веб-версии.

Alphabet ушла в минус по свободному денежному потоку, хотя Cloud удвоилась
30 октября 2026 г.
Alphabet ушла в минус по свободному денежному потоку, хотя Cloud удвоилась

Alphabet показала рекордный рост Google Cloud и поиск, но квартальные капзатраты на ИИ превысили операционный денежный поток. Для Google это уже не спор о спросе на ИИ, а проверка того, окупятся ли огромные обязательства по вычислительной инфраструктуре.

OpenAI переписала правила поведения GPT вокруг намерений человека
30 октября 2026 г.
OpenAI переписала правила поведения GPT вокруг намерений человека

OpenAI опубликовала новую версию Model Spec — публичного документа о желаемом поведении GPT. В центре новой структуры пять ценностей: от следования намерению человека до сохранения его самостоятельности.

Binance оценила последствия инцидента в $6,3 млрд: проверяют ноутбук DevOps-инженера
30 октября 2026 г.
Binance оценила последствия инцидента в $6,3 млрд: проверяют ноутбук DevOps-инженера

Binance называет возможную компрометацию ноутбука DevOps-инженера одной из версий инцидента, после которого были отправлены несанкционированные транзакции на вывод. Компания оценивает общий эффект примерно в $6,3 млрд, заявляет о заморозке около $3 млрд активов и обещает покрыть потери из SAFU и собственных средств.

OpenAI обещает больше лимитов Pro, но публичных цифр пока нет
30 октября 2026 г.
OpenAI обещает больше лимитов Pro, но публичных цифр пока нет

Тибо Соттьё из OpenAI заявил, что лимиты ChatGPT Pro и Business Premium выросли вдвое. Публичная справка компании подтверждает изменения линейки и расширенное использование Work и Codex, но не публикует численные квоты — поэтому заявление нельзя выдать за независимо проверенную математику.

Pipedrive планирует сократить в Эстонии 267 человек — 70% местных сотрудников
29 октября 2026 г.
Pipedrive планирует сократить в Эстонии 267 человек — 70% местных сотрудников

Pipedrive объявила о масштабной структурной перестройке. По данным ERR, под сокращение в Эстонии могут попасть 267 из 380 сотрудников; компания подчёркивает, что это не программа прямой замены людей ИИ.