GPT-6 Astra изменила 0,016% весов Qwen и подняла MATH-500 с 7,9% до 48,1%
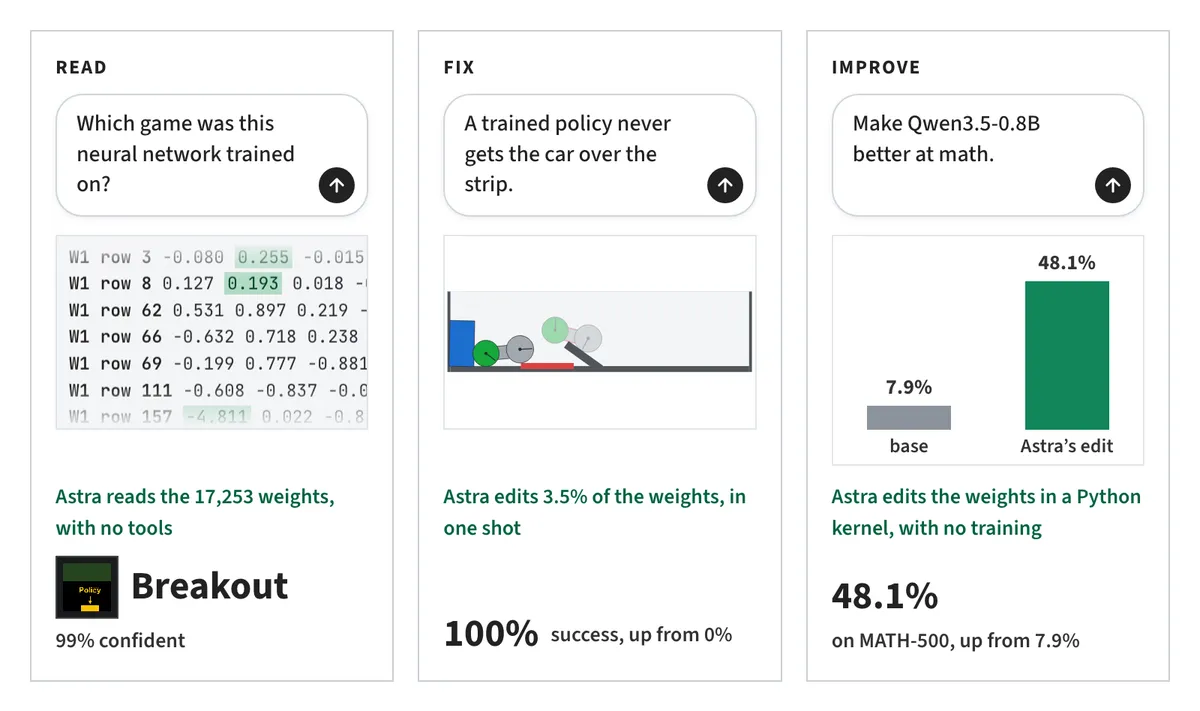
Исследователи Рикия Такэхи и Джейден Теох, указанные в публикации как связанные с MIT CSAIL, сообщили о необычном опыте: GPT-6 Astra получила доступ к весам Qwen3.5-0.8B и без обучения внесла правку, затронувшую около 0,016% параметров. Авторы называют подход «программированием в пространстве весов».
Речь не о новом релизе Qwen и не о доказанной универсальной технике улучшения моделей. Это ранняя публикация авторов с открытыми логами, кодом оценки и сохранёнными изменениями весов.
Две матрицы вместо дообучения
В лучшем запуске Astra работала с Qwen3.5-0.8B в режиме рассуждений. Ей запретили градиентный спуск, обратное распространение ошибки, оптимизаторы и доступ к интернету. Вместо этого она могла изучать тензоры в Python-песочнице и запросить до 50 прямых проходов модели на тренировочных задачах, не входивших в тестовые наборы.
Астра связала слабые результаты с повторяющимися длинными рассуждениями и изменила 64 выходных столбца в MLP-матрицах 15-го и 19-го слоёв. Всего правка затронула 131 072 значения; после округления в bfloat16 от исходной модели отличались 130 188. Это соответствует примерно 0,016% от 0,8 млрд параметров.
Какие цифры получили авторы
На MATH-500 точность выросла с 7,9% до 48,1%, на GSM8K — с 13,8% до 67,1%. На IFEval, который проверяет следование формальным инструкциям, результат поднялся с 21,0% до 62,3% — почти втрое. Авторы также приводят рост на AMC23 с 0,5% до 23,4%, на Minerva Math с 1,5% до 25,4% и на OlympiadBench с 1,3% до 21,8%.
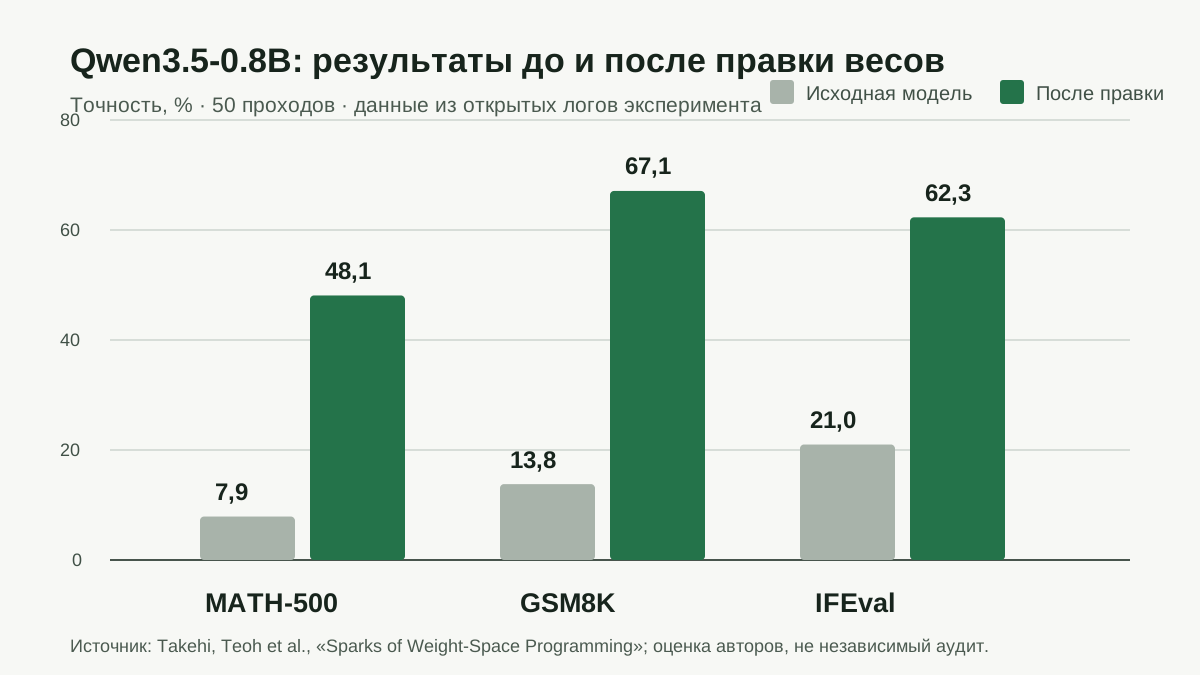
Источник: открытые логи эксперимента; оценка авторов.
В более общих тестах эффект был скромнее, но положительным: MMLU-Pro вырос с 40,3% до 45,5%, GPQA Diamond — с 22,7% до 36,6%. Для базовой GPQA в иллюстрации статьи оставлено промежуточное 24,5%, тогда как завершённые логи дают 22,7%.
Почему к выводу стоит относиться осторожно
Авторы публикуют не только итог, но и каждый экспериментальный ход: промпты, ограничения, файлы оценок и точные диффы весов. Это позволяет проверить заявленные числа и отличает работу от обычной демонстрации в соцсети.
Но независимой репликации и рецензирования пока нет. Все результаты относятся к одной малой модели, одному набору условий и собственной инфраструктуре авторов. Если метод выдержит проверку на других моделях и командах, он может стать новым инструментом отладки: не только переобучать модель на данных, но и искать конкретную неисправность прямо в её весах.