Назад
20 сентября 2026 г. в 09:00 Anthropic AI Safety AI Governance Accenture Источник

Anthropic пустит внешних оценщиков внутрь лаборатории — первым станет Accenture
Anthropic пустит внешних оценщиков внутрь лаборатории — первым станет Accenture

Anthropic хочет, чтобы проверка безопасности передовых ИИ-моделей происходила не только после релиза и не только по материалам, которые компания решила показать сама. Первым партнёром для такого эксперимента станет Accenture: её подразделение Faculty будет работать внутри Anthropic как независимый оценщик.

Это заметно меняет саму идею аудита. По описанию Anthropic, встроенные оценщики получат доступ, сопоставимый с доступом сотрудника: смогут наблюдать обучение моделей, следить за решениями об их создании и выпуске и разговаривать с командой напрямую.

Не аудит после инцидента

Accenture будет заниматься оценками и red teaming — контролируемыми попытками найти опасное или нежелательное поведение модели, — а также проверять меры защиты и подходы к alignment, то есть согласованию поведения ИИ с заданными ограничениями.

Компания рассчитывает, что практический опыт Accenture в корпоративных и государственных внедрениях поможет замечать риски, которые не видны в лабораторных тестах. Обе стороны намерены вложить в развитие этой области не менее $1 млрд каждая в ближайшие пять лет.

Но слово «независимый» здесь пока требует осторожности. Anthropic прямо пишет, что единых стандартов доступа, формата публикации выводов и финансирования таких проверок ещё нет. Работу Accenture на первом этапе оплатит сама Anthropic. Одновременно компания обсуждает пилоты с некоммерческой METR и другими организациями, у которых может быть собственное финансирование.

Проверять обещания, а не презентации

Партнёрство не даёт оценщикам права снять с Anthropic ответственность за безопасность. Зато оно потенциально позволяет проверить более важную вещь: совпадают ли внутренние решения лаборатории с её публичными обязательствами, пока модель ещё создаётся, а не после громкого сбоя.

Для пользователей и компаний-покупателей полезный критерий будет простым: появятся ли у таких оценок понятные, сопоставимые и публичные результаты. Доступ «внутрь» ценен лишь тогда, когда неудобные выводы нельзя тихо оставить внутри той же комнаты.
Ещё новости

Google вынес Guided Learning в Classroom: что показали тесты
3 ноября 2026 г.
Google вынес Guided Learning в Classroom: что показали тесты

Google начинает глобально разворачивать Guided Learning в Classroom. В контролируемом исследовании с более чем 300 студентами доступ к инструменту совпал с более высоким приростом результатов, но это ещё не доказательство для всех школьных сценариев.

GitHub Copilot Fusion сам выбирает модели для задачи
3 ноября 2026 г.
GitHub Copilot Fusion сам выбирает модели для задачи

GitHub вывел Copilot Fusion в общую доступность: режим сам подбирает и комбинирует модели для задачи. Для разработчика это уменьшает ручной выбор модели, но не отменяет контроль расходов и корпоративных политик.

Пенсильвания ввела правила для обманной AI-рекламы
3 ноября 2026 г.
Пенсильвания ввела правила для обманной AI-рекламы

Новый закон Пенсильвании требует заметно раскрывать использование синтетического контента, когда он создаёт ложное впечатление о товаре или услуге.

Кибератака на Selver: в холодильной системе выставили +50 °C
2 ноября 2026 г.
Кибератака на Selver: в холодильной системе выставили +50 °C

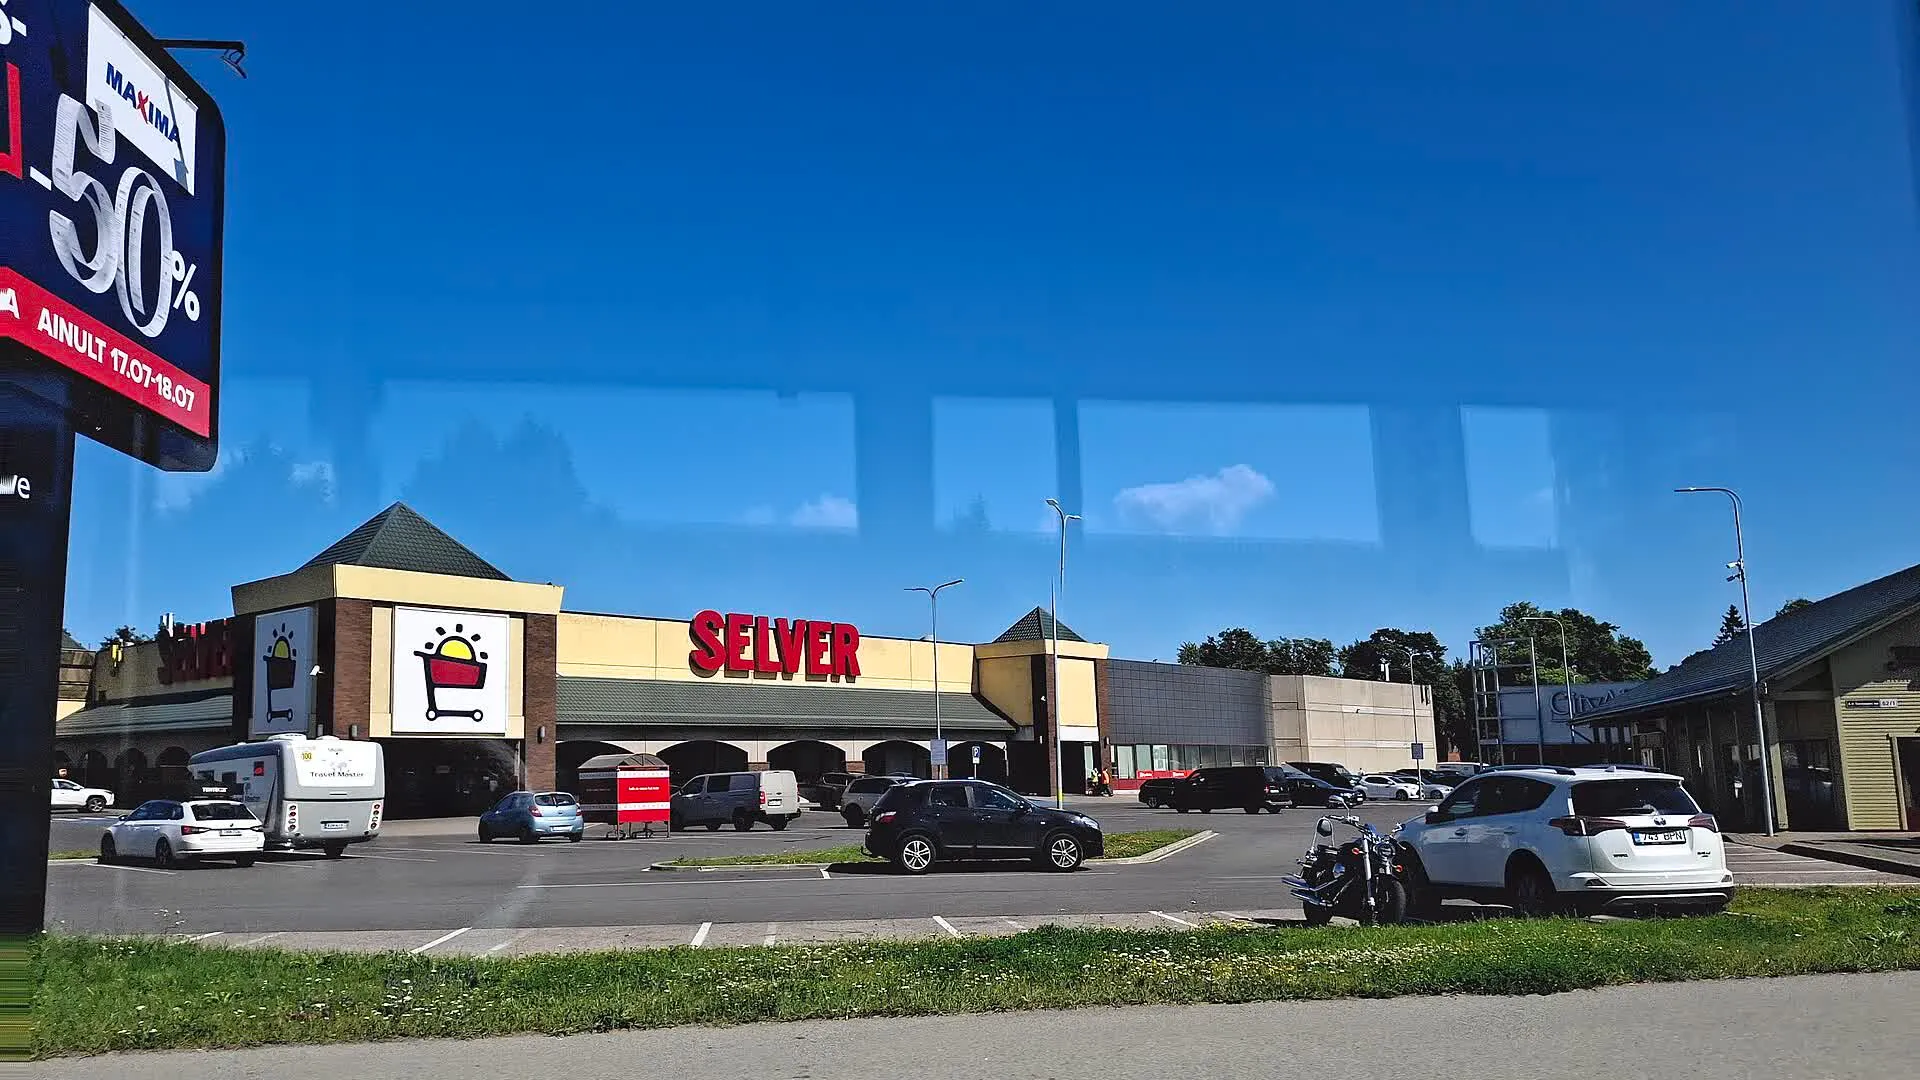
В одном из эстонских магазинов Selver атаковали систему охлаждения: по сообщению Postimees, в ней попытались установить температуру +50 °C. Selver заявляет, что партнёр быстро обнаружил инцидент, магазин не понёс ущерба, а товары и покупатели не пострадали.

Gemini Notebook открыл сотни бесплатных учебников
2 ноября 2026 г.
Gemini Notebook открыл сотни бесплатных учебников

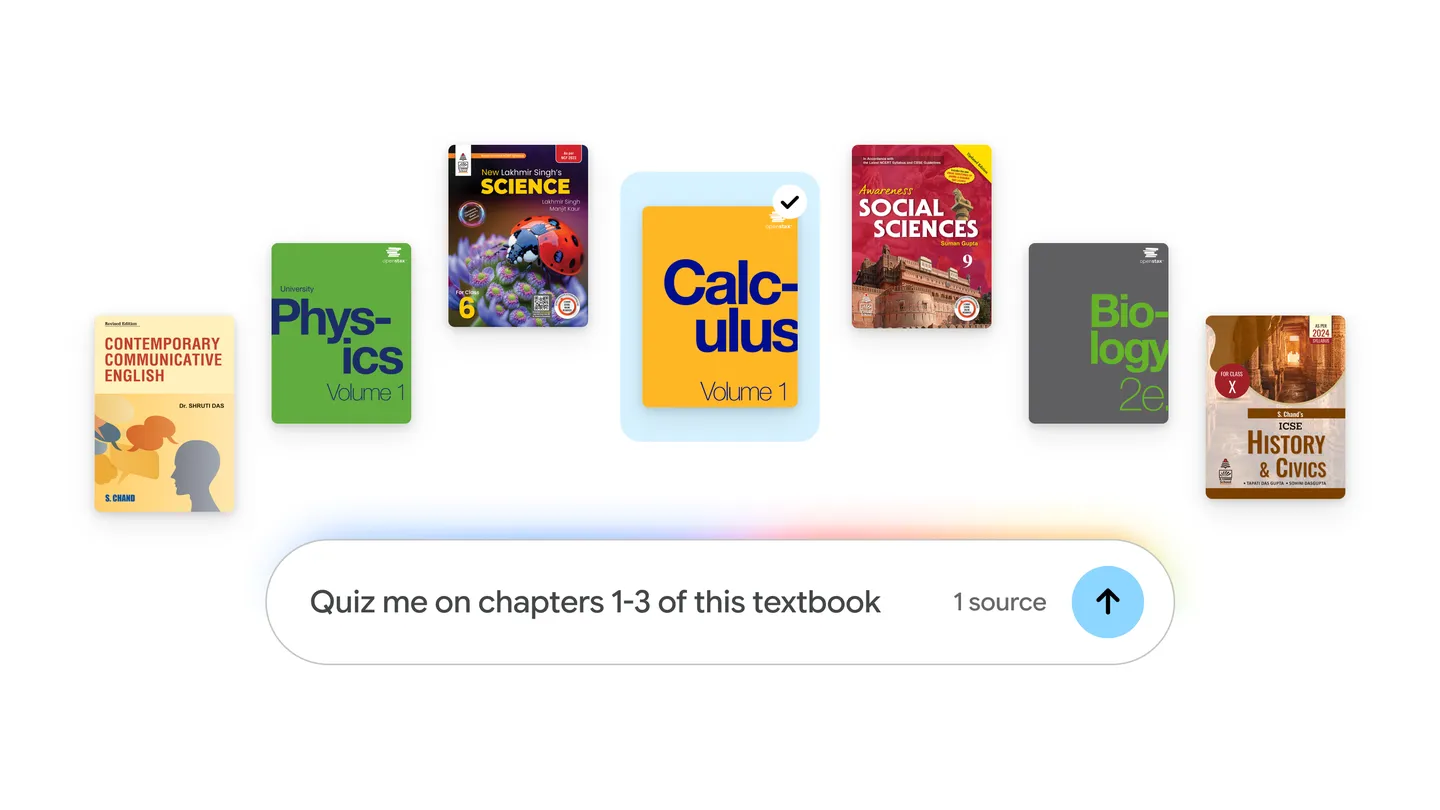
Google добавила в Gemini Notebook каталог из сотен учебников от OpenStax, Open Textbook Library и S Chand Publishing. По каждому подключённому учебнику сервис обещает ответы с привязкой к тексту и ссылками на исходные фрагменты. Это делает ИИ удобнее для подготовки, но не отменяет проверку его выводов.

GPT-6 Astra изменила 0,016% весов Qwen и подняла MATH-500 с 7,9% до 48,1%
2 ноября 2026 г.
GPT-6 Astra изменила 0,016% весов Qwen и подняла MATH-500 с 7,9% до 48,1%

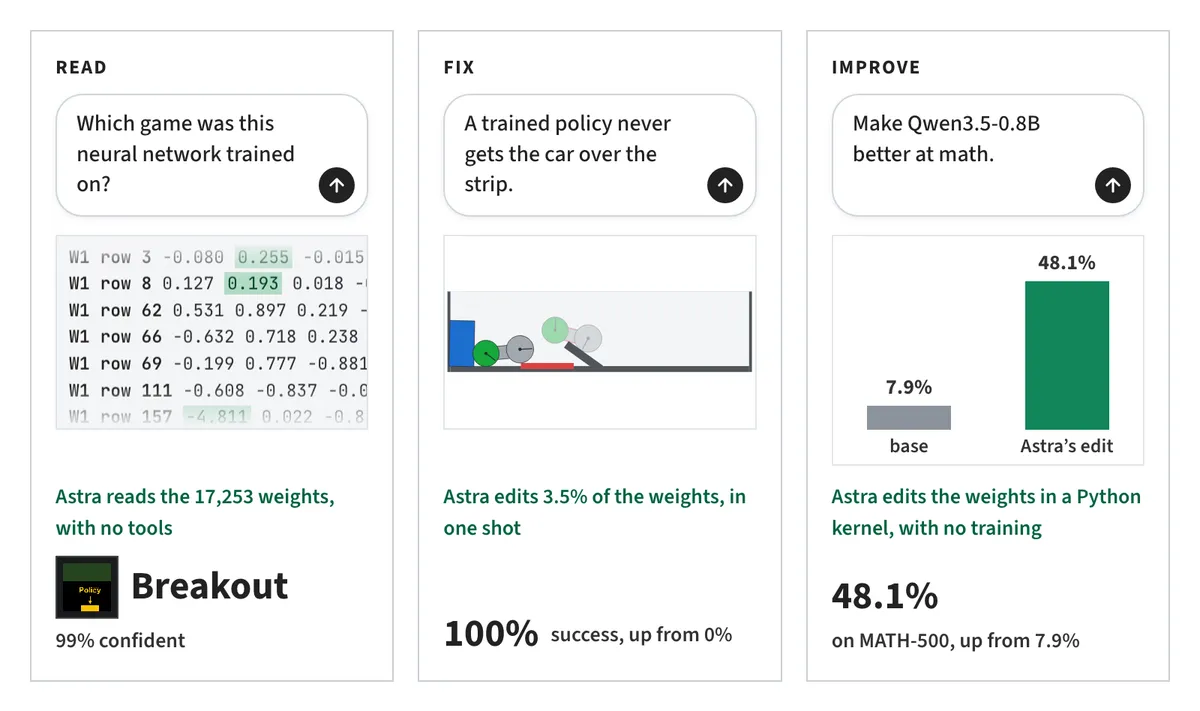
Исследователи, связанные с MIT CSAIL, выложили открытые логи эксперимента, в котором GPT-6 Astra напрямую изменила небольшую часть весов Qwen3.5-0.8B. После одной из правок авторы зафиксировали рост на математических тестах и IFEval, но это ранняя работа с оценкой в собственной экспериментальной среде.

Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач
2 ноября 2026 г.
Новый тест агентов: лучший ИИ решил лишь 12% рабочих задач

SemiAnalysis запустила GDPx — бенчмарк агентных моделей на задачах из 11 дорогих для бизнеса областей. По данным авторов, лучший результат пока составляет лишь 12%: эффектные демо ещё не равны надёжной автономной работе.

Google получила первый ответ ИИ с орбитального TPU
1 ноября 2026 г.
Google получила первый ответ ИИ с орбитального TPU

Google получила первый ответ от модели Gemma 4, запущенной на TPU на спутнике Project Suncatcher. Это подтверждает работу вычислительной нагрузки на орбите, но не доказывает жизнеспособность космического дата-центра.

DeepSeek показал прототип «суперагента» для GitHub
1 ноября 2026 г.
DeepSeek показал прототип «суперагента» для GitHub

DeepSeek опубликовала исследовательский прототип dsh-superagent: он следит за событиями в одном репозитории GitHub, запускает отдельные агентные сессии и возвращает результат в исходный диалог.

Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять
1 ноября 2026 г.
Критическая дыра в Linux: удалённый запуск кода грозит серверам — ядро пора обновлять

В ядре Linux исправили критическую CVE-2026-98432: ошибка в IPv4/TCP при неблагоприятных условиях может дать удалённому неаутентифицированному атакующему выполнение кода. Владельцам серверов стоит проверить статус ядра у своего дистрибутива и запланировать обновление, особенно если система принимает соединения из недоверенных сетей.

ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям
31 октября 2026 г.
ИИ уже предлагает улучшения для ИИ — но проверять их всё ещё приходится людям

Sakana AI и исследователи из Оксфорда показали The AI Scientist: LLM-агент генерирует гипотезы, меняет код, запускает эксперименты и пишет отчёты по задачам машинного обучения. Работа — проверяемый пример того, как модели участвуют в поиске улучшений для других моделей, но сами авторы фиксируют критические ошибки и не призывают верить результатам без перепроверки.

StepSecurity начала учитывать плагины Claude Code и Codex
31 октября 2026 г.
StepSecurity начала учитывать плагины Claude Code и Codex

StepSecurity добавила инвентаризацию плагинов AI-агентов на машинах разработчиков и в репозиториях GitHub. Инструмент показывает, откуда пришёл плагин, что в нём находится и где он включён — то есть закрывает новую дыру в цепочке поставки кода.