Назад
17 мая 2026 г. в 06:00 AI Open Source Local LLM llama.cpp Qwen Inference GitHub / Reddit r/LocalLLaMA

Локальные ИИ-модели получили ускоритель: llama.cpp добавил MTP и сделал Qwen заметно быстрее
Локальные ИИ-модели получили ускоритель: llama.cpp добавил MTP и сделал Qwen заметно быстрее

Локальные ИИ-модели получили ускоритель: llama.cpp добавил MTP и сделал Qwen заметно быстрее

В llama.cpp влили поддержку MTP — Multi Token Prediction. Для людей вне локального ИИ это может звучать как очередная аббревиатура из недр GitHub, но смысл довольно земной: модели учатся отвечать быстрее без отдельной маленькой draft-модели, которую раньше часто приходилось добавлять к speculative decoding.

Обычная LLM пишет ответ по одному токену: предсказала следующий кусок текста, добавила его в контекст, пошла дальше. MTP позволяет модели заранее предложить несколько следующих токенов. Потом основная проверка решает, какие из них действительно подходят. Если прогноз удачный, генерация перескакивает через несколько шагов сразу. Если нет — лишнее отбрасывается, и модель продолжает обычным темпом.

Главная новость не в теории, а в том, что это теперь появилось в llama.cpp — одном из самых важных инструментов для запуска open-weight моделей на локальных компьютерах, рабочих станциях и небольших серверах. Через него живут домашние ассистенты, локальные чат-интерфейсы, эксперименты с кодовыми моделями и корпоративные сборки, где данные не хотят отправлять в облако.

Что именно добавили

Поддержка пришла через PR #22673. Автор тестировал механизм на Qwen3.6 27B и Qwen3.6 35B-A3B. В описании PR указано, что MTP-модель загружается из того же GGUF-файла. Это важная деталь: пользователю не нужно отдельно искать маленькую модель-помощник, синхронизировать её с основной и надеяться, что вся связка не развалится на настройках.

По сути, черновой контур для предсказания следующих токенов находится внутри самой поддерживаемой модели или рядом с ней в одном файле. Поэтому MTP выглядит удобнее для массового локального запуска, чем классическая схема с двумя моделями. Скачал правильный GGUF, включил нужные параметры, получил шанс на ускорение без лишней инженерной кухни.

Но это не магический турборежим для всех старых весов. Модель должна быть обучена или собрана с MTP-головами. Если у архитектуры их нет, один только новый llama.cpp не заставит её внезапно писать вдвое быстрее. Нужны подходящие сборки, корректные параметры и дальнейшая оптимизация в рантайме.

Насколько быстрее

Первые цифры выглядят заметно. В бенчмарках из PR девять тестовых задач на Qwen3.6 без MTP заняли около 201 секунды, а скорость держалась примерно на уровне 7 токенов в секунду. С MTP и максимумом в три draft-токена те же задачи уложились примерно в 84 секунды. В отдельных сценариях скорость поднималась до 16–22 токенов в секунду.

Автор также пишет о 72–75% принятых предсказанных токенов в устойчивом режиме. Это как раз та часть, от которой зависит выигрыш: чем чаще черновые токены совпадают с тем, что основная модель готова принять, тем меньше шагов приходится делать последовательно.

Ограничения тоже названы прямо. Результат зависит от модели, железа, длины ответа, настроек и параллельности. В PR отдельно отмечено, что обработка промпта при включённом MTP может проседать из-за переносов эмбеддингов с устройства на хост, а параллельное декодирование ещё не полностью оптимизировано. Поэтому честная формулировка такая: не «всем стало в три раза быстрее», а «для подходящих моделей появился реальный путь к двукратному ускорению генерации».

Почему это важно

Локальные модели часто проигрывают облачным не только качеством, но и ощущением скорости. Пользователь может быть готов терпеть более сложную установку ради приватности, цены или контроля, но медленный ответ быстро превращает полезный инструмент в игрушку для энтузиастов.

MTP бьёт именно в это слабое место. Если 27B или 35B-модель на локальном железе начинает отвечать ближе к облачному чату, меняется набор практических сценариев: код-ассистент на рабочей машине, приватный разбор документов, локальный агент для автоматизации, внутренний помощник компании без передачи данных внешнему провайдеру.

Отдельно показательно, что тесты идут на Qwen3.6. Китайские open-weight модели уже давно не выглядят экзотикой для бенчмарков: Qwen, DeepSeek и соседние семейства используются для кода, анализа, перевода и локальных агентов. Если MTP хорошо приживётся именно там, выиграет не один репозиторий, а заметная часть локальной экосистемы.

Большая гонка ИИ обычно видна по релизам новых моделей. Но в реальной жизни не менее важна гонка инференса: сколько стоит ответ, сколько он занимает времени и можно ли запустить всё без облачного API. Поддержка MTP в llama.cpp — не финальная победа локального ИИ, а полезный инженерный шаг к тому, чтобы сильная модель на собственном компьютере отвечала не «когда-нибудь», а сейчас.
Ещё новости

Gemini 4 Hydrogen появился в GitHub Copilot
14 ноября 2026 г.
Gemini 4 Hydrogen появился в GitHub Copilot

GitHub добавил Gemini 4 Hydrogen в Copilot как общедоступную модель. Для разработчиков это ещё один быстрый вариант для агентных задач и многошаговой работы с инструментами — но выбор доступен не во всех тарифах и средах.

OpenAI открыла ранний доступ к агентам для проверки и исправления уязвимостей
14 ноября 2026 г.
OpenAI открыла ранний доступ к агентам для проверки и исправления уязвимостей

OpenAI представила ранний доступ к Daybreak Red Team и Defense Factory: первая система проверяет веб-приложения на уязвимости, вторая готовит исправления для ревью инженера. Обе части требуют контроля области проверки и не заменяют ответственность команды за код.

Эстонский FleetFox с ИИ-проверкой по фото готовится к банкротству
14 ноября 2026 г.
Эстонский FleetFox с ИИ-проверкой по фото готовится к банкротству

Эстонская FleetFox, которая заявляет об ИИ-проверке качества по фотографиям в обслуживании автопарков, намерена подать заявление о банкротстве. Компания говорит о сорванной инвестсделке и нехватке денежных средств после сокращения заказов крупных клиентов.

ChatGPT Wallet: агентам дали оплату без номера карты
13 ноября 2026 г.
ChatGPT Wallet: агентам дали оплату без номера карты

OpenAI запускает ChatGPT Wallet для покупок через агентов dots: пользователь подтверждает каждую оплату биометрией, а продавец и агент не получают данные его карты. На старте функция доступна только подписчикам ChatGPT Pro в США с подходящими американскими картами.

Сбой Microsoft 365 затронул Outlook, Copilot и инструменты защиты
13 ноября 2026 г.
Сбой Microsoft 365 затронул Outlook, Copilot и инструменты защиты

Microsoft сообщила о масштабной деградации Microsoft 365: у части пользователей не работали почта Outlook и Exchange Online, а также связанные с ними корпоративные сервисы. В статусе компании перечислены проблемы с Copilot, Defender XDR, Purview, Teams и другими продуктами; потребительский OneDrive и Outlook.com вынесены в отдельное уведомление.

VS Code 1.146 добавил inbox для ИИ-агентов и сравнение моделей
13 ноября 2026 г.
VS Code 1.146 добавил inbox для ИИ-агентов и сравнение моделей

В стабильной версии VS Code 1.146 появился inbox для сессий агентов, отдельные окна чата и расширенное сравнение моделей. Одновременно Microsoft объявила, что Local harness будет удалён в феврале 2027 года.

Google выпустила Gemini 4 Hydrogen: миллион токенов за $1,50
13 ноября 2026 г.
Google выпустила Gemini 4 Hydrogen: миллион токенов за $1,50

Google представила Gemini 4 Hydrogen — более быстрый и дешёвый вариант для агентных задач. Модель получила контекст в миллион токенов и стала доступна в API, AI Studio, приложении Gemini и поиске; условия доступа зависят от продукта и тарифа.

Anthropic выпустила Claude Fable 5.2 и Mythos 5.2: обычным пользователям доступна только одна модель
12 ноября 2026 г.
Anthropic выпустила Claude Fable 5.2 и Mythos 5.2: обычным пользователям доступна только одна модель

Anthropic представила Claude Fable 5.2 и Claude Mythos 5.2 для сложных технических задач. Fable доступна всем пользователям, а Mythos для кибербезопасности и биомедицины остаётся по заявке; базовая цена API — $8 за миллион входных и $40 за миллион выходных токенов.

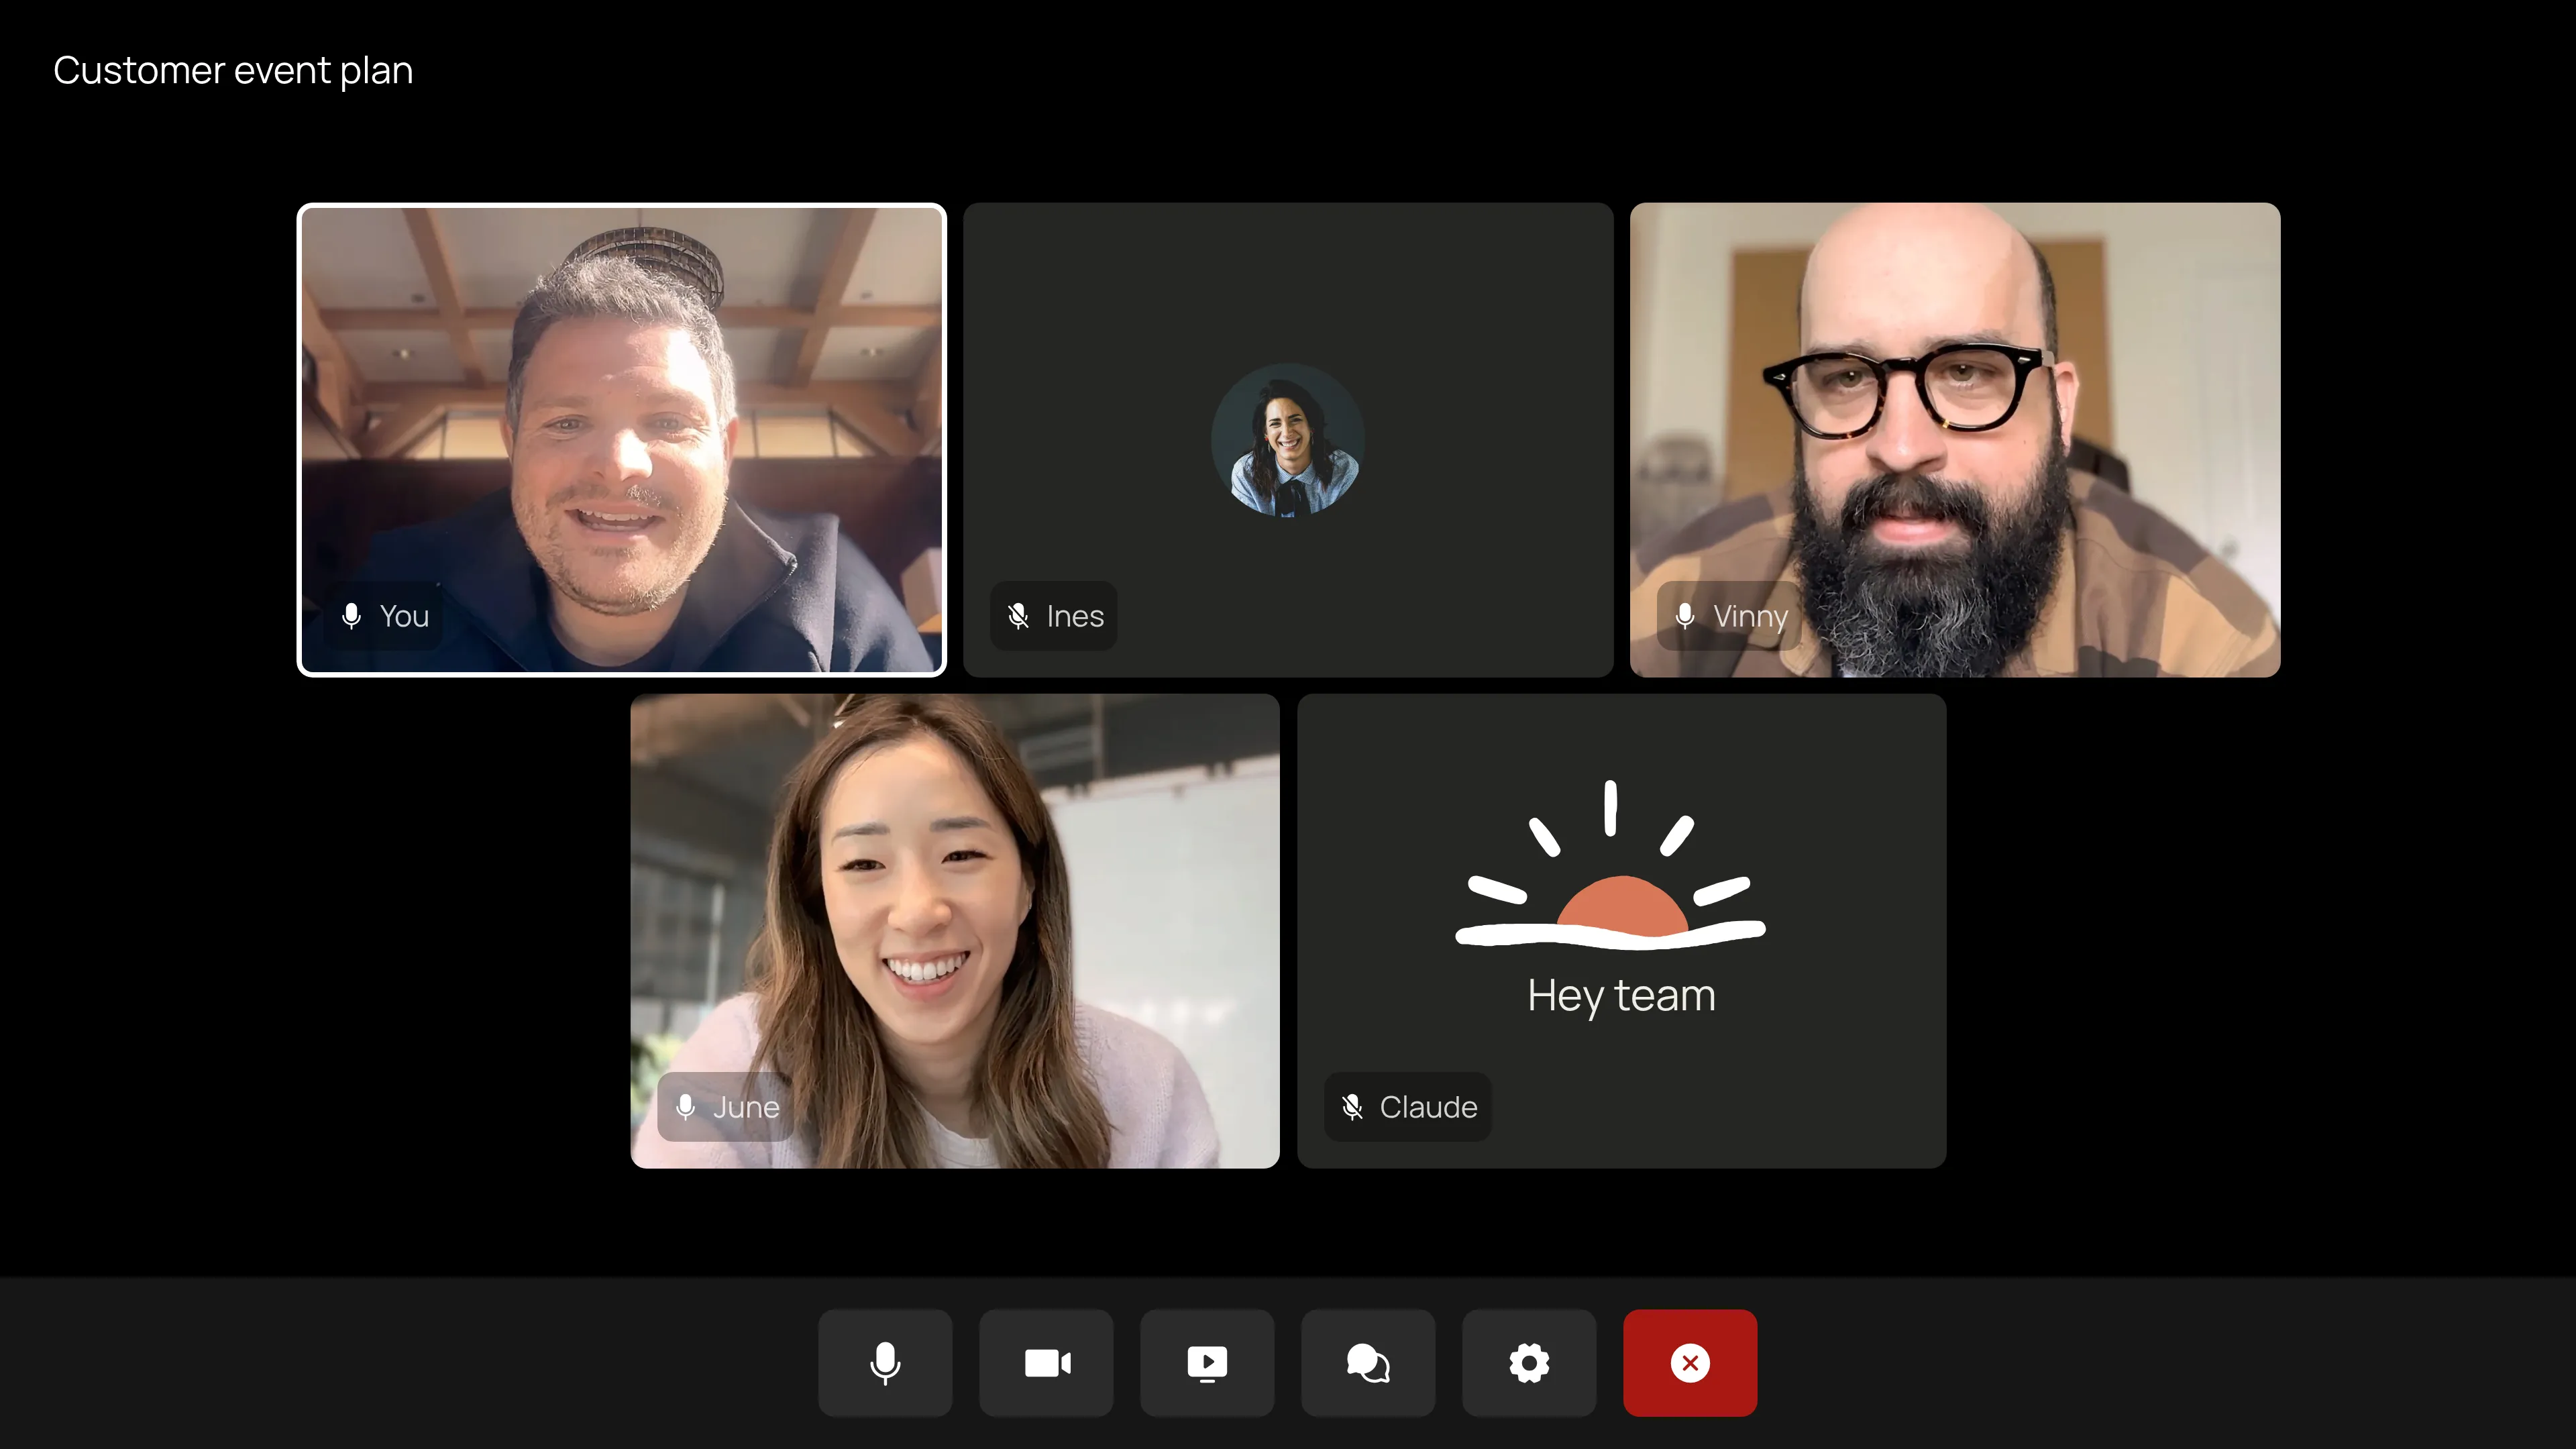
Anthropic пустила Claude на встречи в Google Meet — и ограничила бета-доступ
12 ноября 2026 г.
Anthropic пустила Claude на встречи в Google Meet — и ограничила бета-доступ

Anthropic начала бета-раскатку Claude Meetings для Team и Enterprise: видимый участник Google Meet ведёт стенограмму, отвечает на вопросы и прямо во время разговора собирает документы и доски. Это шире обычного ИИ-конспекта, но функция недоступна организациям с ZDR, HIPAA-ready и CMEK-конфигурациями.

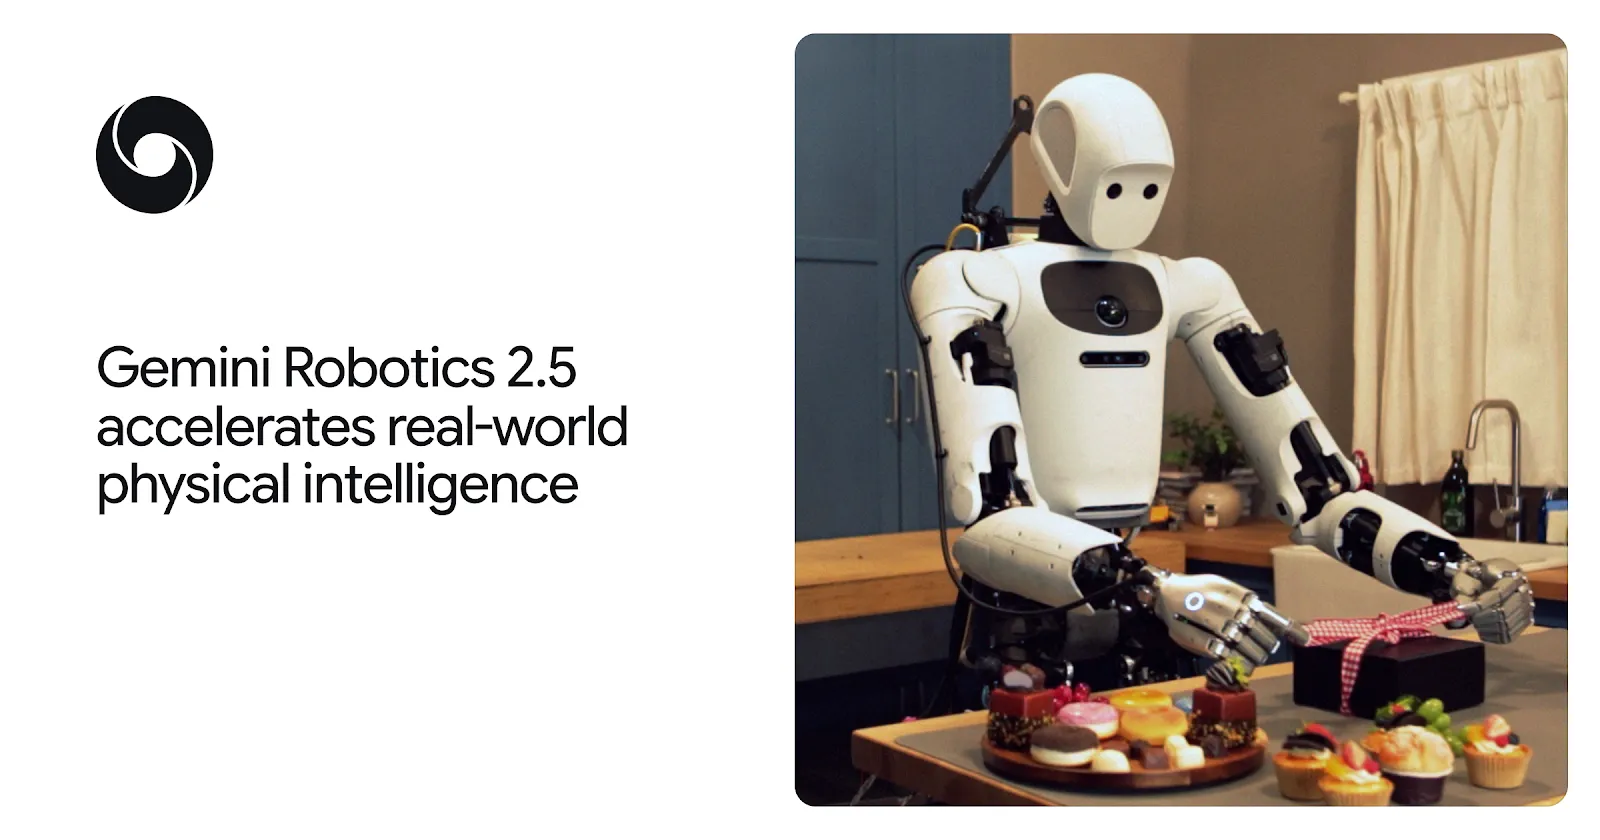
Gemini Robotics 2.5: гуманоид Apollo показал 96% в цехе Mercedes
12 ноября 2026 г.
Gemini Robotics 2.5: гуманоид Apollo показал 96% в цехе Mercedes

Google DeepMind представила Gemini Robotics 2.5 — VLA-модель для управления роботами. В пилоте на линиях Mercedes-Benz гуманоид Apollo 2 сортировал автодетали с заявленным успехом 96%.

Gemini Live появился в Apple CarPlay
12 ноября 2026 г.
Gemini Live появился в Apple CarPlay

Google начала глобально разворачивать Gemini Live в Apple CarPlay. Голосовой помощник может продолжать диалог с iPhone, но часть персонализированных функций недоступна пользователям в ЕЭЗ.

Google выпустила Gemini Decision 1: ИИ для выбора без генерации текста
12 ноября 2026 г.
Google выпустила Gemini Decision 1: ИИ для выбора без генерации текста

Google открыла Gemini Decisions API и модель Gemini Decision 1 — инструмент для быстрых проверок, маршрутизации и оценок по тексту, изображениям, аудио, видео и PDF. Вместо генерации ответа модель возвращает вероятности вариантов.