Назад
25 мая 2026 г. в 04:55 AI Google DeepMind Mathematics Lean Science Agents arXiv; Google DeepMind GitHub

После прорыва OpenAI — новый удар по задачам Эрдёша: AI-агент Google решил ещё 9 открытых проблем
После прорыва OpenAI — новый удар по задачам Эрдёша: AI-агент Google решил ещё 9 открытых проблем

После прорыва OpenAI — новый удар по задачам Эрдёша: AI-агент Google решил ещё 9 открытых проблем

Google DeepMind, Google и академические партнёры выложили на arXiv работу об AlphaProof Nexus — системе, которая ищет математические доказательства с помощью агентов на базе больших языковых моделей и проверяет результат в Lean. Самый сильный вариант агента автономно решил 9 из 353 формализованных открытых задач из каталога ErdosProblems, а также доказал 44 из 492 открытых гипотез из OEIS, энциклопедии целочисленных последовательностей.

Новость легко спутать с недавним прорывом OpenAI по задаче единичных расстояний, но это разные истории. У OpenAI речь шла об одном громком результате в дискретной геометрии. У Google — о проверяемом поиске доказательств для набора уже формализованных исследовательских задач.

Как работает AlphaProof Nexus

Исследователь даёт системе Lean-файл с формальной постановкой теоремы и пустым местом для доказательства. Дальше подагенты на Gemini 3.1 Pro улучшают черновик, получают ошибки компилятора Lean и используют их как обратную связь. Полная конфигурация также подключает AlphaProof для отдельных подцелей и эволюционный механизм, где разные попытки оцениваются критиками и снова используются в следующих запусках.

На задачах Эрдёша авторы запустили систему не на ручной подборке красивых примеров, а на всех Lean-формализациях, доступных в репозитории Formal Conjectures на момент эксперимента: 353 постановки из более чем 1200 задач каталога. После каждого успеха эксперты проверяли соответствие исходной задаче. Доказательства опубликованы в репозитории google-deepmind/alphaproof-nexus-results, а результаты занесены на вики Теренса Тао.

Почему это важно

Формальная проверка не превращает LLM в безошибочного математика. В статье прямо описаны провалы: агент мог прятать трудность в вспомогательную лемму с заглушкой или ссылаться на несуществующее «известное» утверждение. Но такие ошибки не проходят финальный барьер. Успех засчитывается только тогда, когда Lean принимает доказательство без sorry, то есть без незакрытых мест.

Ограничения тоже существенные. Выборка смещена к задачам, которые сообщество уже успело записать в Lean. В OEIS авторы дополнительно проверяли первые члены последовательностей через тестовые леммы, чтобы снизить риск неверной формализации. Даже в списке Эрдёша агент закрыл 9 задач из 353, а не «решил математику».

Зато масштаб уже другой, чем у единичной демонстрации. Авторы пишут о стоимости вывода в несколько сотен долларов на задачу, а базовый агент, который чередует генерацию LLM и проверку Lean, позже смог повторить все 9 успехов, хотя на сложных задачах обходился дороже. AlphaProof Nexus уже применяется или тестируется в нескольких областях математики и физики.

Что меняется для науки

Главный вывод не в том, что математики становятся лишними. Людям всё ещё нужно выбирать задачи, формализовать постановки, проверять соответствие Lean-кода исходному вопросу и понимать ценность найденного доказательства. Но роль ИИ заметно сдвигается: это уже не только помощник по тексту и не только олимпиадный решатель, а инструмент поиска проверяемых фрагментов нового знания.

После результата OpenAI это выглядит как ускорение одной линии: крупные лаборатории начинают показывать не просто рассуждающие модели, а рабочие связки «агент плюс формальная проверка». Если такой подход станет дешевле и удобнее, следующий прорыв может прийти не из одной эффектной задачи, а из регулярного потока маленьких доказательств.

Ещё новости

Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле
7 октября 2026 г.
Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле

Anthropic представила Claude Haiku 5.5 — малую модель для быстрых и недорогих задач: от классификации и суммаризации до субагентов и работы в браузере. Для запросов до 100 тысяч токенов вход и выход стали в десять раз дешевле, чем у Haiku 4.5.

Google запустил Playground: игры по текстовому запросу
7 октября 2026 г.
Google запустил Playground: игры по текстовому запросу

Google открыл экспериментальную платформу Playground: пользователь описывает игру текстом, тестирует её в браузере и делится ссылкой. На старте сервис доступен совершеннолетним пользователям из США, а возможности создания зависят от подписки Google One.

OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены
7 октября 2026 г.
OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены

OpenAI открыла каталог результатов внутренней модели: 722 рукописи в 372 связанных семействах. Компания подчёркивает, что материалы находятся на разных стадиях проверки, а часть результатов без формализации в Lean может содержать ошибки.

Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой
7 октября 2026 г.
Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой

Georgia Tech получила одобрение на новую онлайн-магистратуру по искусственному интеллекту. Старт намечен на 2027 год: программа обещает шесть направлений и обязательный проект с компанией или организацией, но детали приёма и стоимости пока не раскрыты.

Mistral Large 4: API уже доступен, веса — в конце октября
6 октября 2026 г.
Mistral Large 4: API уже доступен, веса — в конце октября

Mistral открыла public preview Mistral Large 4 — мультимодальной модели с 1 трлн параметров, из которых активно 49 млрд. В API её уже можно попробовать, но обещанные open weights появятся лишь в конце октября.

Reflection показала Beam на 501 млрд параметров — но веса выйдут позже
6 октября 2026 г.
Reflection показала Beam на 501 млрд параметров — но веса выйдут позже

Reflection представила Beam — открытую по весам MoE-модель для кода, рассуждений и агентов. Пока это ранний доступ: веса, model card и технический отчёт обещаны лишь позднее в октябре.

OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС
6 октября 2026 г.
OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС

OpenAI сообщила, что будет добавлять невидимую маркировку в тексты ChatGPT и Codex для пользователей из ЕС. Метка должна помочь выполнять требования AI Act, но компания признаёт: после существенной правки текста её будет труднее обнаружить.

GitHub открыла API для запуска проверок кода Copilot
5 октября 2026 г.
GitHub открыла API для запуска проверок кода Copilot

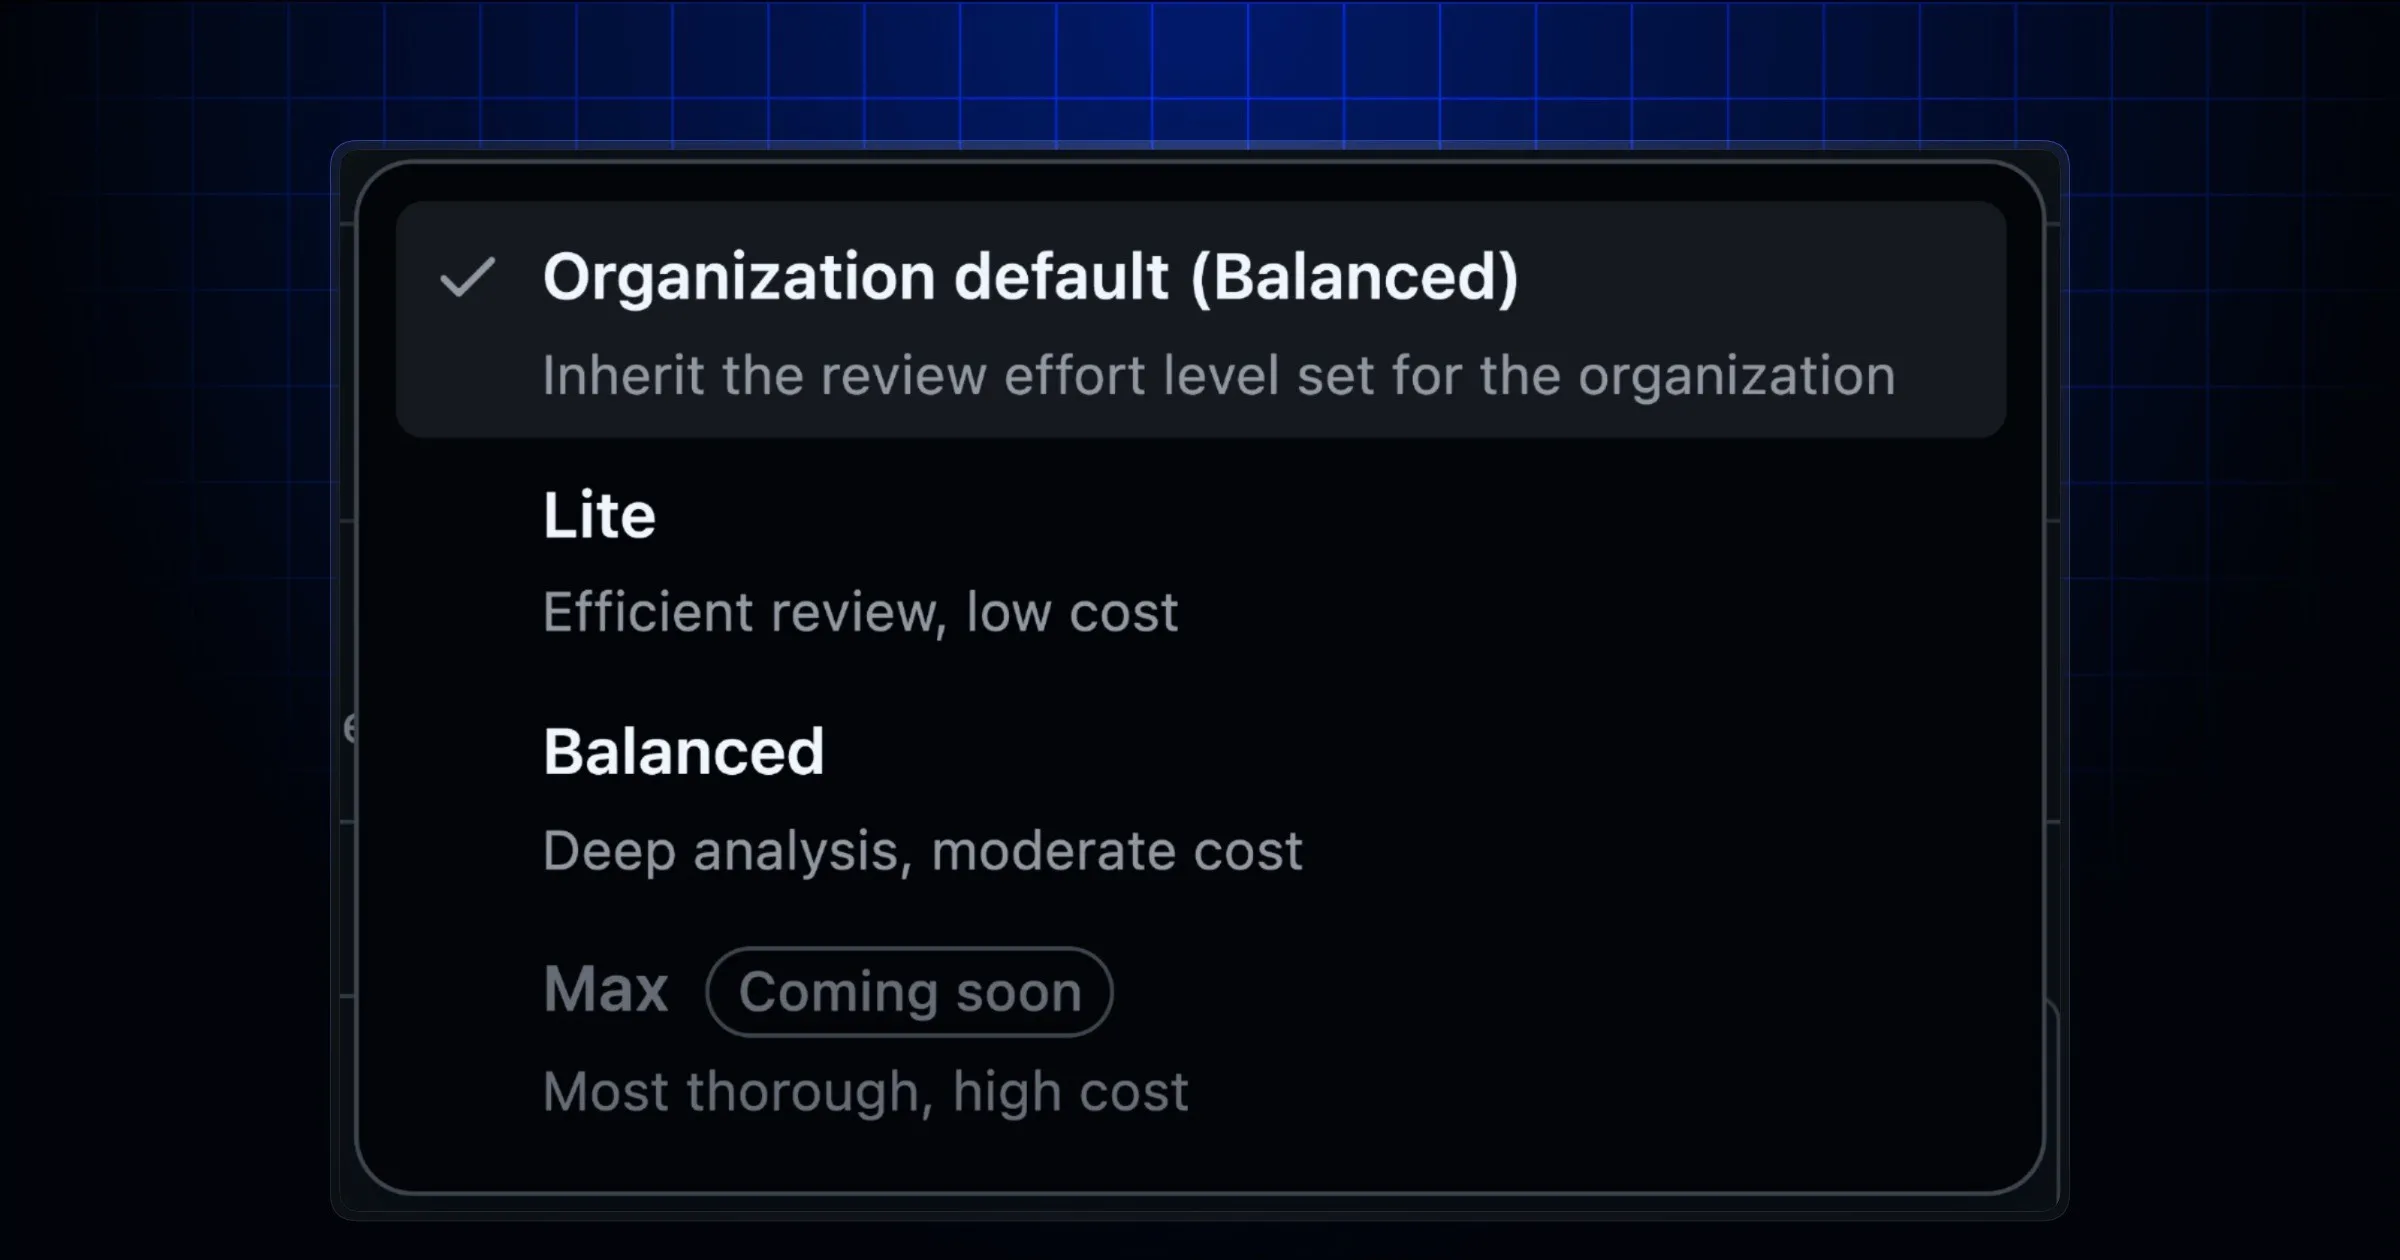
GitHub разрешила запускать проверку pull request’ов Copilot через REST и GraphQL API. Одновременно для новых и уже существующих репозиториев стандартным уровнем тщательности стал Balanced.

AWS показала Well-Architected Agent: ИИ-ревизор для облака, но с правами и проверкой человеком
5 октября 2026 г.
AWS показала Well-Architected Agent: ИИ-ревизор для облака, но с правами и проверкой человеком

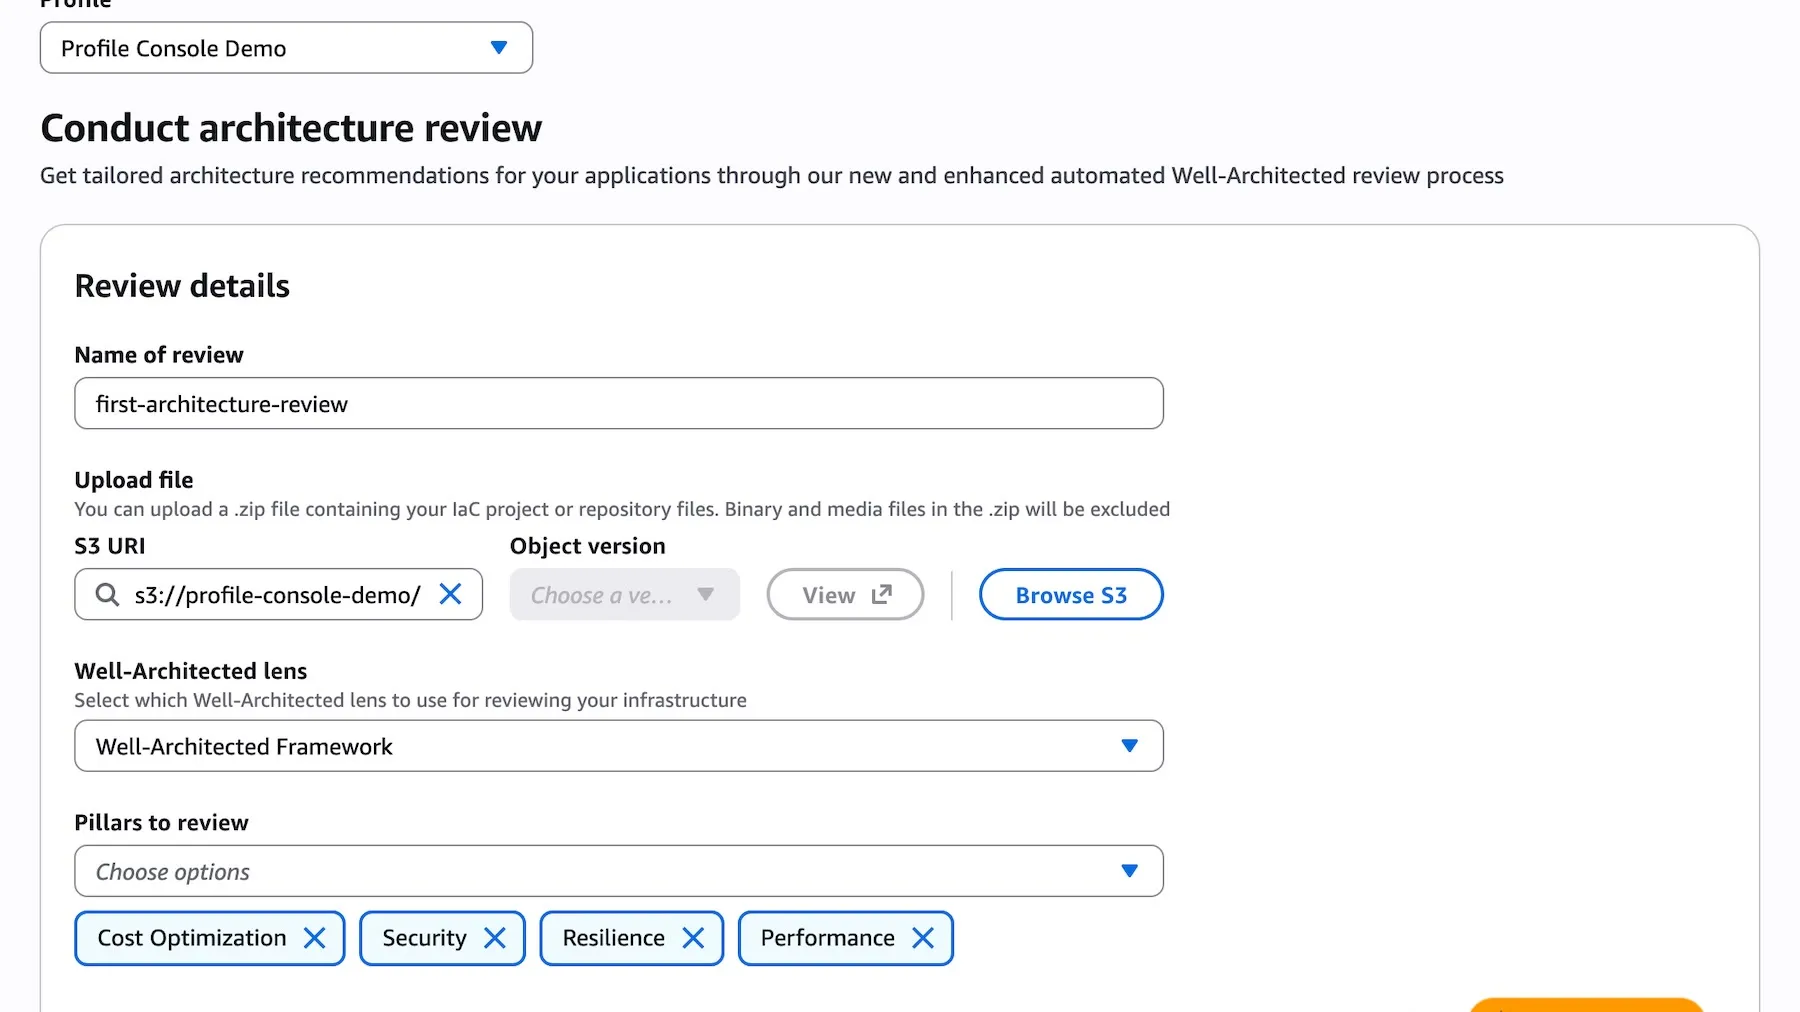
AWS открыла предварительный доступ к Well-Architected Agent — сервису, который анализирует инфраструктуру и предлагает исправления для стоимости, производительности, устойчивости и безопасности. Рекомендации могут включать изменения IaC, но AWS отдельно предупреждает: генеративный ИИ способен ошибаться.

Google урезает доступ к Gemini: бесплатным оставят Flash-Lite
4 октября 2026 г.
Google урезает доступ к Gemini: бесплатным оставят Flash-Lite

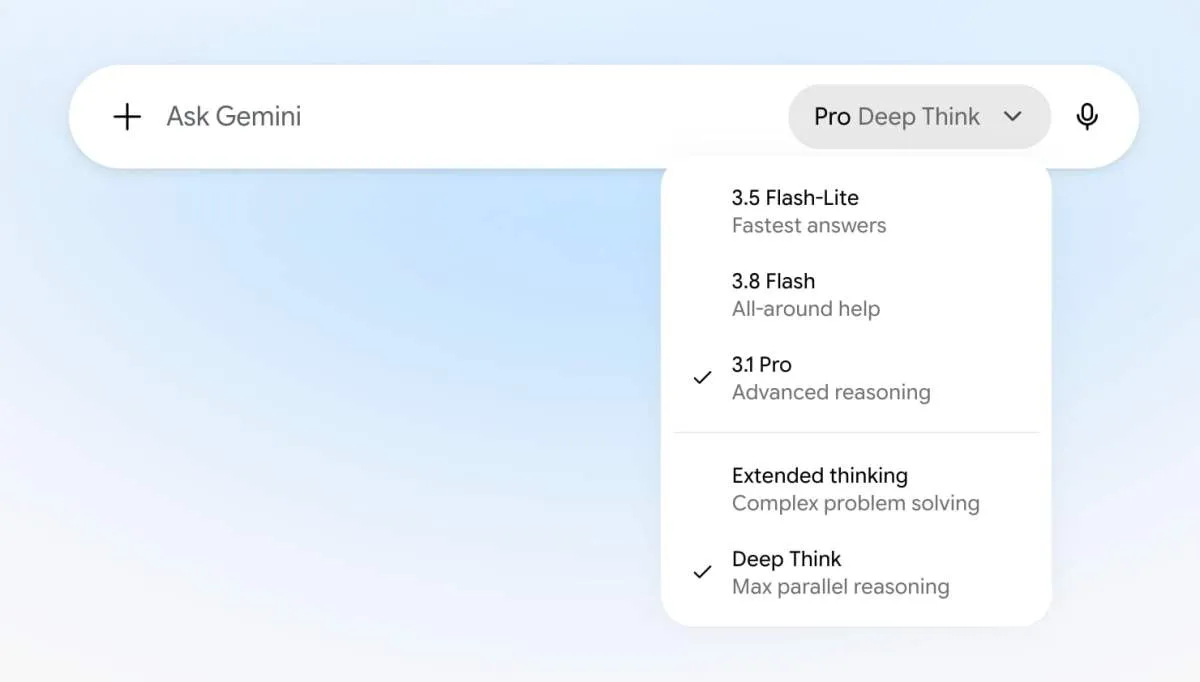
Google меняет набор моделей Gemini для бесплатных пользователей и подписки AI Plus. С 9 октября доступ к Pro исчезнет у обоих уровней, а платный AI Pro получит Deep Think.

Руководитель по безопасности OpenAI ушёл, назвав культуру компании сломанной
4 октября 2026 г.
Руководитель по безопасности OpenAI ушёл, назвав культуру компании сломанной

Дэвид Робинсон, руководивший подготовкой отчётов по безопасности к релизам OpenAI, покинул компанию. В эссе он заявил, что темп запусков не оставляет ей достаточной осторожности; OpenAI ответила, что продолжает усиливать практики безопасности и при необходимости замедляет обучение или выпуск моделей.

PFNYC: в Нью-Йорке сжимаются стартовые вакансии в профессиях, уязвимых для ИИ
4 октября 2026 г.
PFNYC: в Нью-Йорке сжимаются стартовые вакансии в профессиях, уязвимых для ИИ

В Нью-Йорке с 2022 года заметно сократилось число стартовых вакансий в нескольких офисных профессиях с высокой подверженностью ИИ, сообщает Partnership for New York City. Данные PFNYC и отдельная работа Stanford фиксируют совпадающие ранние паттерны, но не доказывают, что их причиной стал именно ИИ.