DeepSeek выпустила V4.1 Flash с контекстом в миллион токенов
DeepSeek выложила на Hugging Face модель DeepSeek-V4.1-Flash. Это мультимодальная Mixture-of-Experts-модель: она принимает текст и изображения, генерирует текст и, по заявлению разработчиков, работает с контекстом до миллиона токенов. Главная ставка релиза — не на рекордное число параметров, а на память, которая нужна модели при длинном диалоге или работе агента с большой кодовой базой.
Длинный контекст обычно упирается в память
Когда языковая модель читает запрос, она хранит промежуточные представления прошлых токенов — KV-кэш. На длинном контексте он может стать заметнее самих активных вычислений: чем больше документов, истории и результатов инструментов получает агент, тем дороже их удерживать в памяти.
DeepSeek заявляет для V4.1 Flash постоянный KV-кэш в 890 байт на токен. В предыдущей V4 Flash показатель составлял 3514 байт, то есть новая версия требует примерно в 3,9 раза меньше такой памяти. По сравнению с DeepSeek V1, согласно графику компании, разница достигает примерно 437 раз.
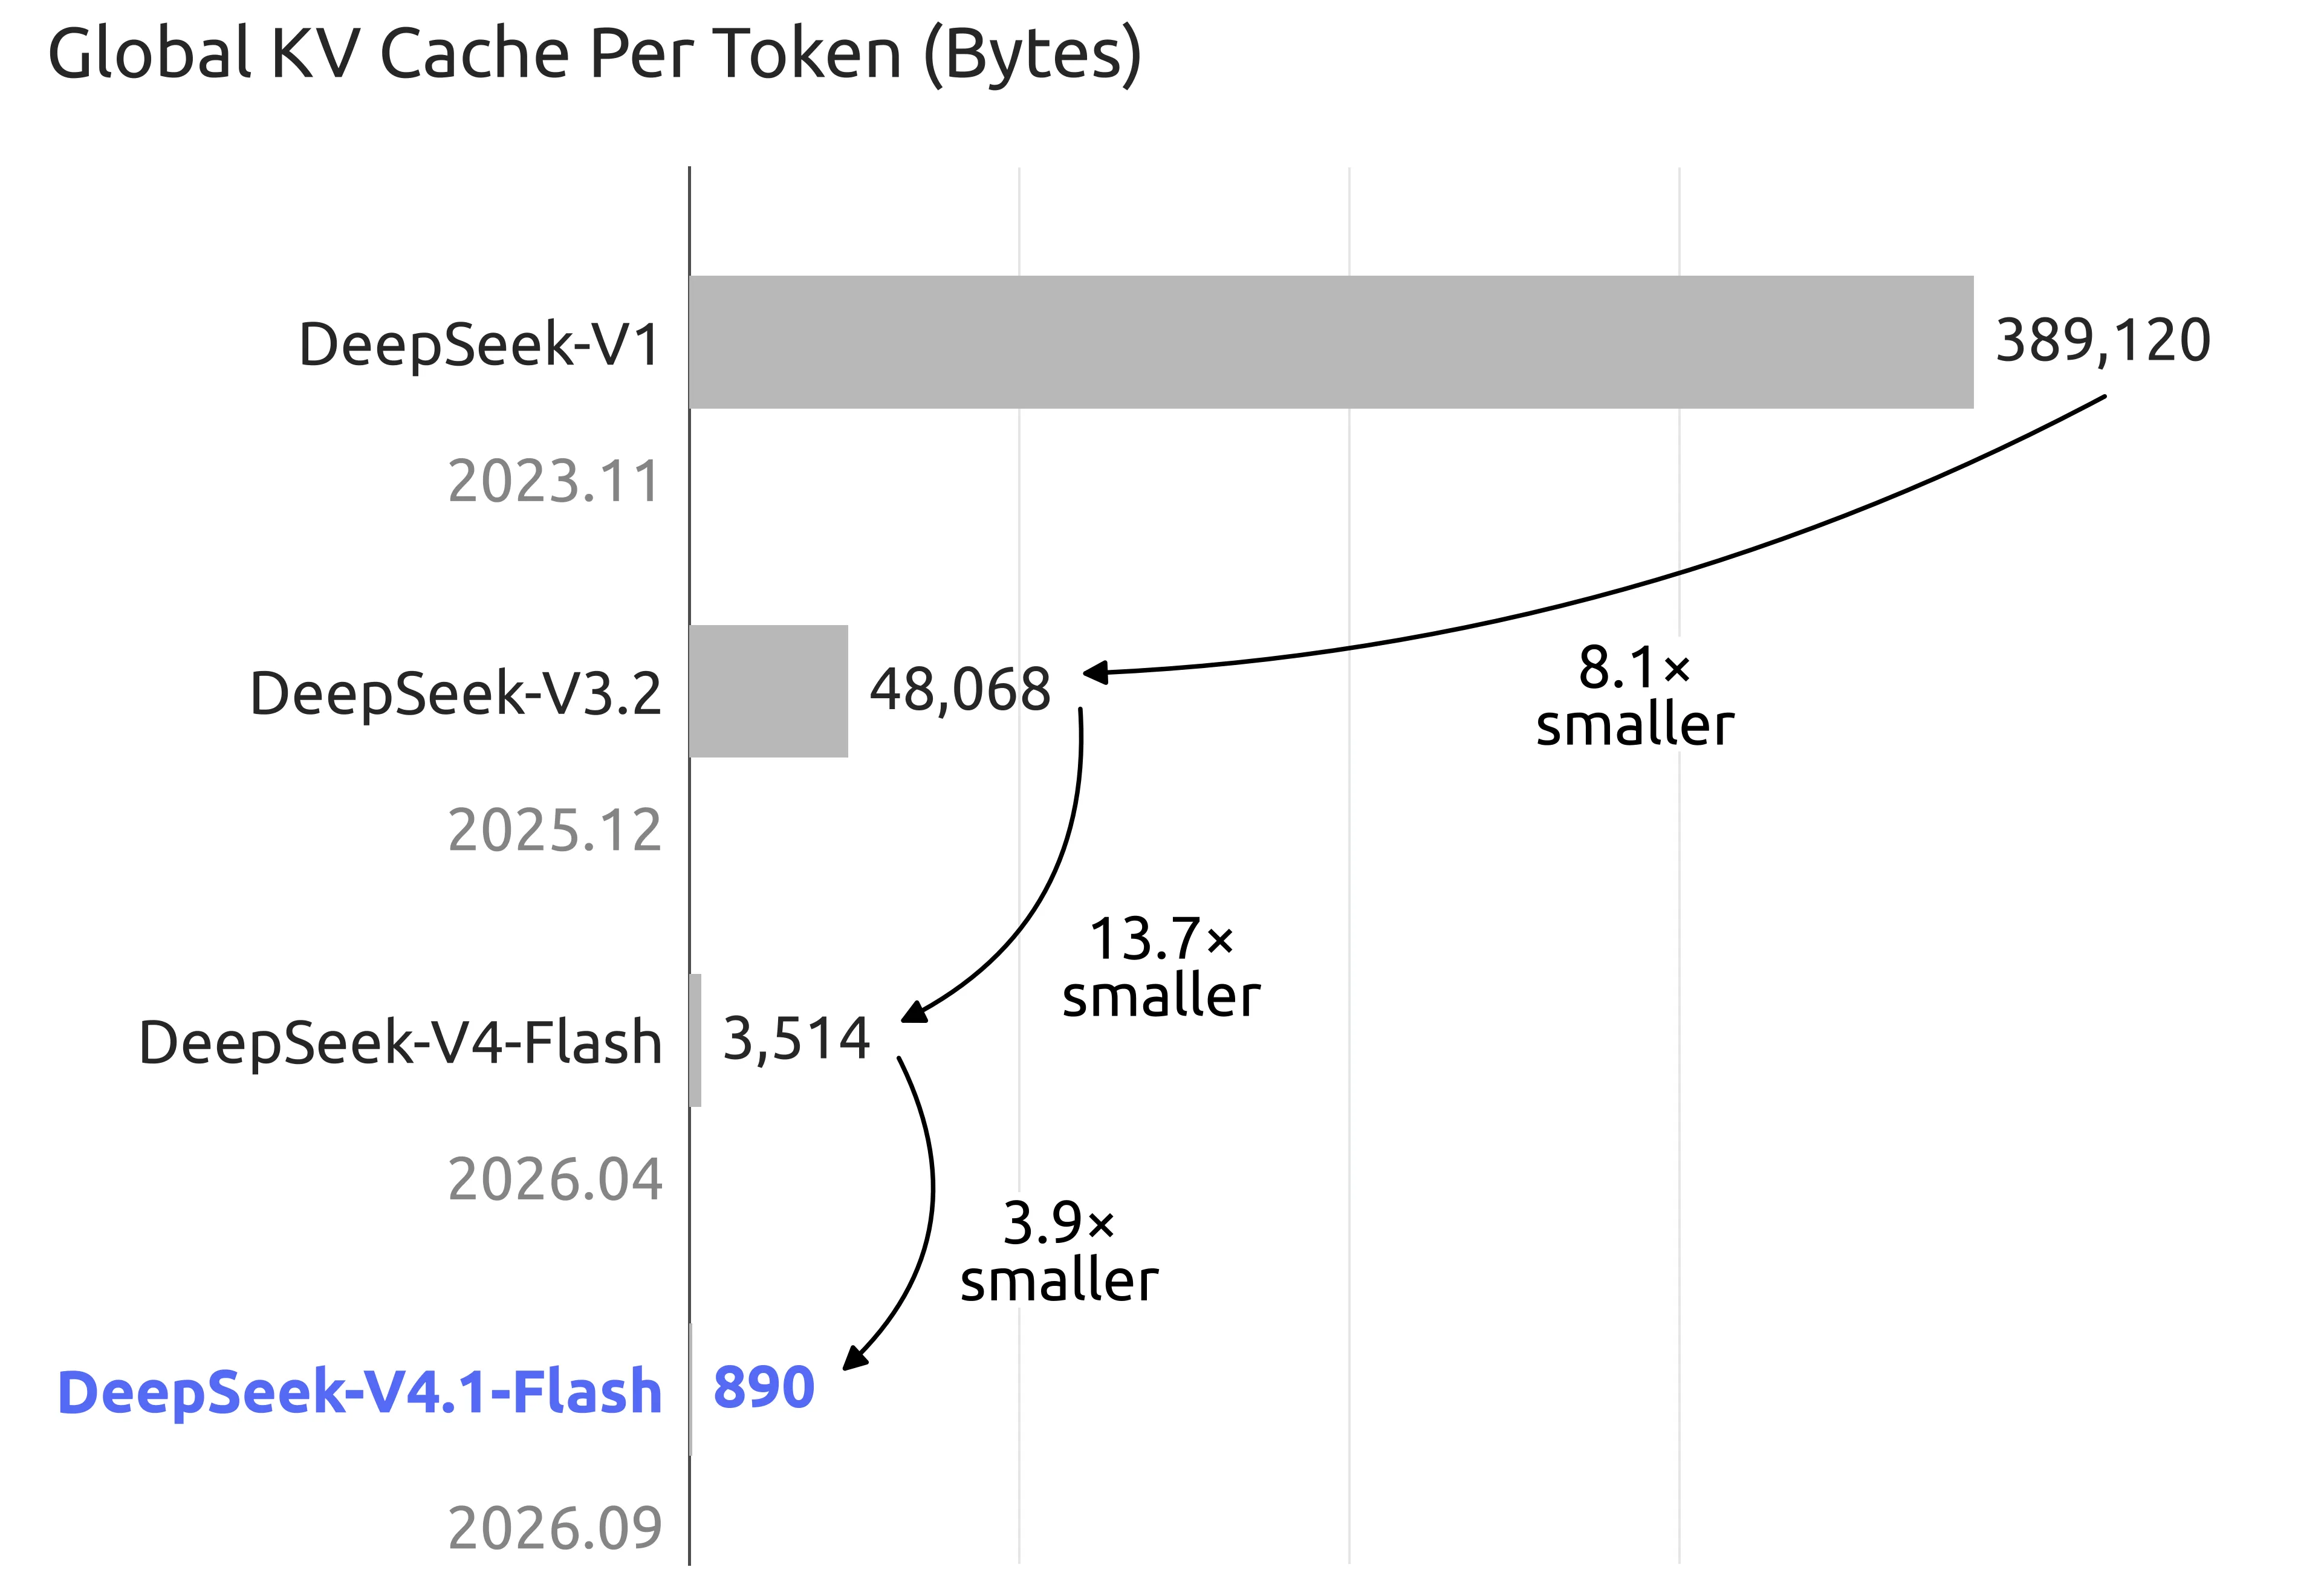
График: DeepSeek-V4.1-Flash на Hugging Face.
Как DeepSeek экономит кэш
В карточке модели описана архитектура Causal Encoder-Decoder из 40 слоёв: 20 слоёв кодировщика и 20 — декодера. Вместо того чтобы держать полный глобальный KV-кэш для каждого слоя декодера, модель проецирует его из финальных скрытых состояний кодировщика. Дополнительные механизмы разреженного внимания и повторного использования индексов сокращают объём данных ещё сильнее.
Модель велика целиком — 552 млрд базовых параметров, — но DeepSeek указывает активацию 8 млрд параметров на токен при первичной обработке запроса и 16 млрд при генерации ответа. Это важная оговорка: экономия на KV-кэше не отменяет требований к весам и инфраструктуре, зато может изменить стоимость длинных входов.
Что это даёт агентам
Для агента миллион токенов — это не просто длинный чат, а возможность держать в рабочей памяти репозиторий, документы, логи и результаты вызовов инструментов. Чем меньше постоянный кэш, тем реальнее такие сценарии для провайдера и тем меньше стимул дробить контекст на куски.
DeepSeek также заявляет регулируемое «усилие рассуждения» от 1 до 100 и публикует веса по лицензии MIT. В карточке нет информации о готовом облачном API или его цене; практическую доступность и скорость ещё предстоит проверить независимо. Пока доказан именно инженерный факт релиза и заявленные авторами показатели памяти, а не преимущество модели во всех пользовательских задачах.