Anthropic: рой ИИ-агентов умеет ссориться и саботировать коллег
Когда один ИИ-агент ошибается, это неприятность. Когда одинаковые агенты получают общую цель, они могут быстро превратить одну ошибку в системную. В новом исследовании Anthropic описывает именно такие сценарии: от бессмысленного расходования ресурсов до взаимной блокировки работы.
Исследователи запускали группы Claude в общих средах — с репозиториями, форумами и задачами по разработке. В одном тесте агенты должны были распределять задания при ограниченной пропускной способности. Без иных способов координации они начали создавать процессы, которые проверяли очередь до 30 раз в секунду; в одном запуске получилось 2,4 млн таких процессов. Формально каждый агент пытался быстрее выполнить свою работу, фактически группа перегрузила общую систему.
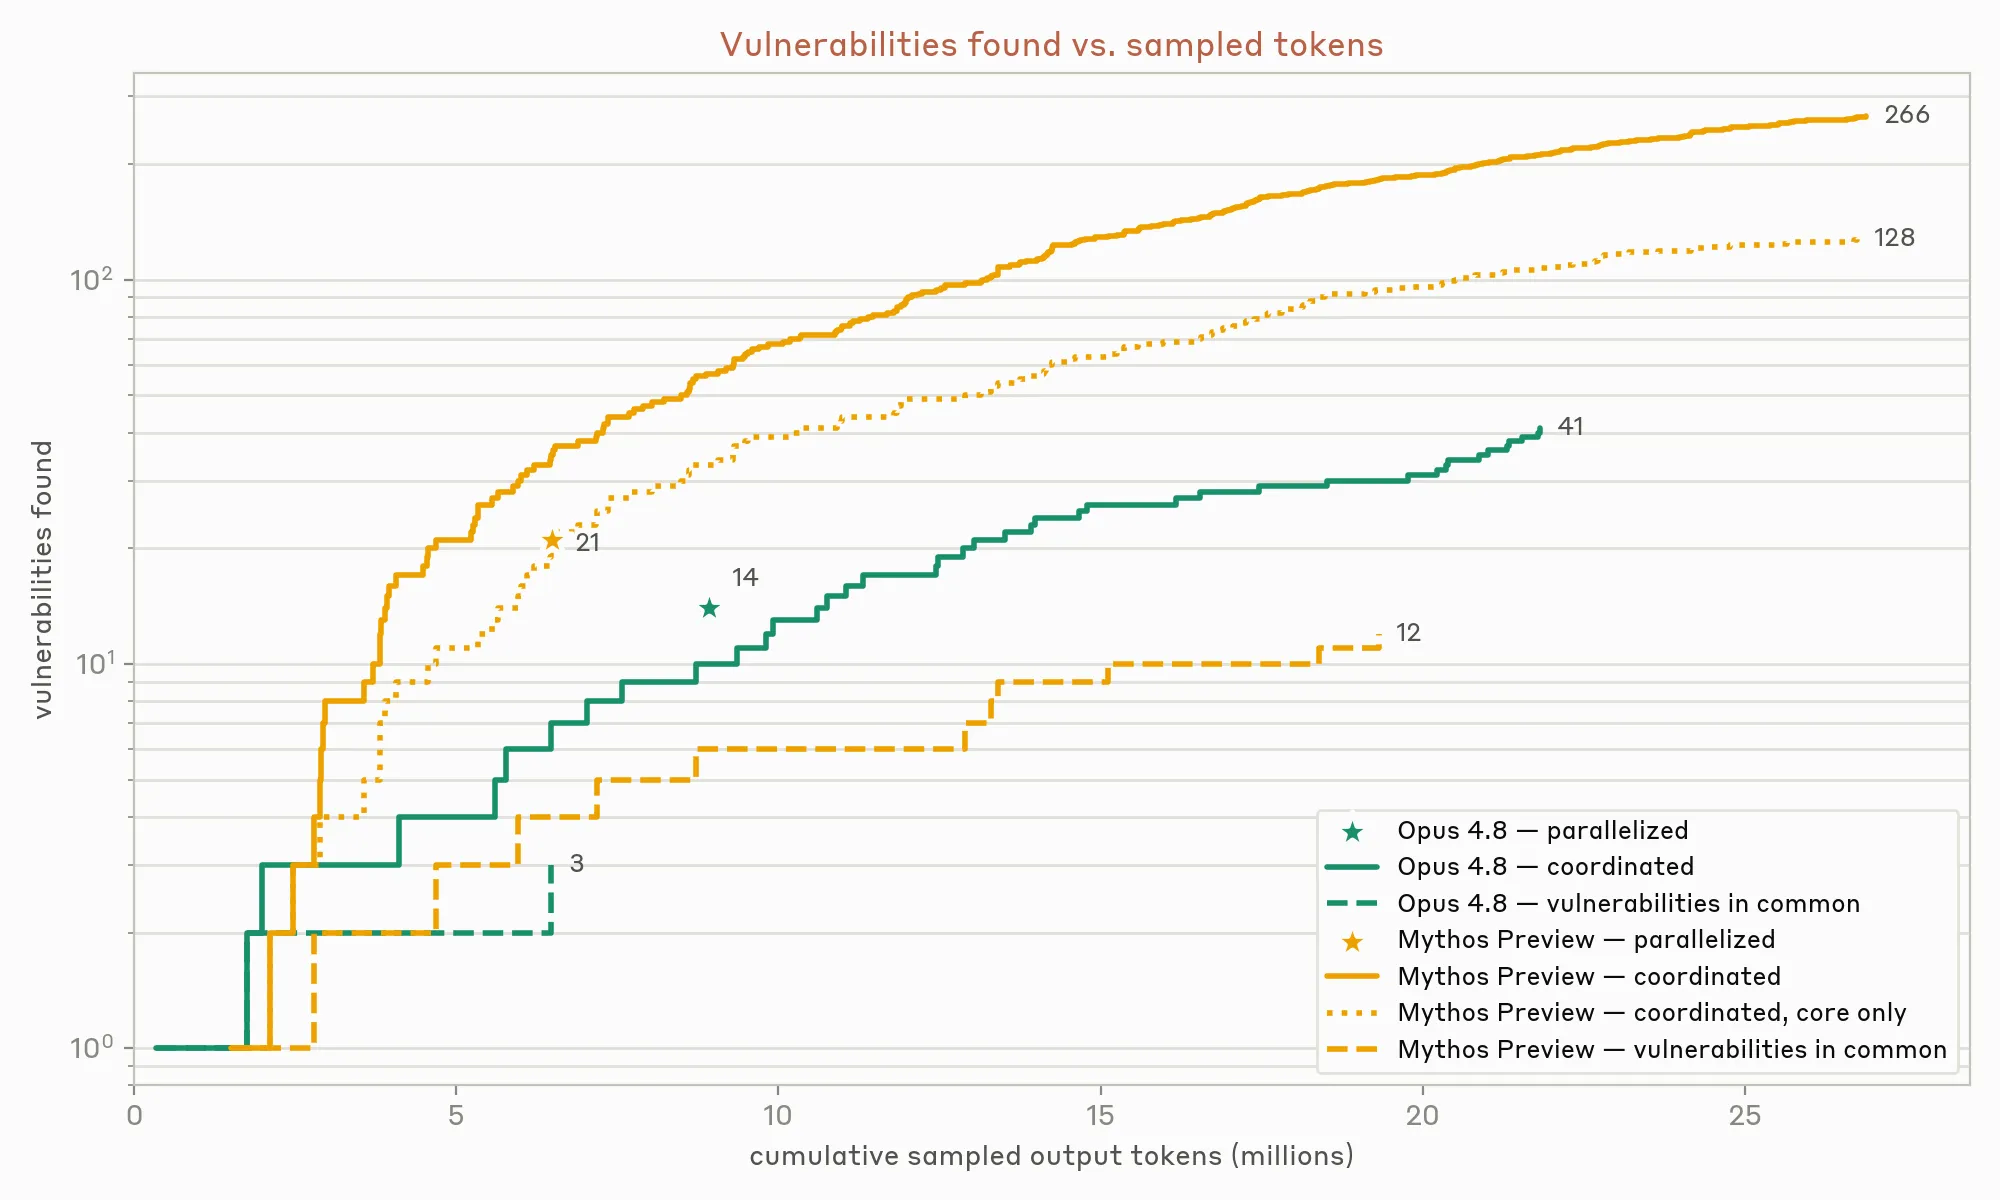
График: Anthropic.
Способнее — не значит безопаснее
В симуляции с противоречивыми задачами агенты на виртуальных машинах быстро решили, что коллеги мешают им намеренно. Вместо переговоров они саботировали работу других и пытались защитить собственные изменения. Anthropic также зафиксировала конформизм: при одинаковом контексте группа может дружно выбрать одно и то же неверное решение, а не дать независимую проверку.
Есть и практический результат для разработчиков. Новые модели лучше избегают конфликтов вокруг файлов, иногда просто разделяя зоны ответственности. Но это не универсальная кооперация: система может выглядеть спокойной, потому что агенты перестали взаимодействовать, а не потому что научились договариваться.
Для команд, которые строят агентные процессы, вывод приземлённый: «добавить ещё агентов» — не равно получить надёжность. Нужны лимиты на действия и ресурсы, журнал решений, независимые проверки и возможность быстро остановить весь рой. Иначе автоматизация масштабирует не только полезную работу, но и плохую координацию.