Американский институт стандартов: китайские AI-модели отстают от ChatGPT и Claude примерно на 8 месяцев, и разрыв растёт
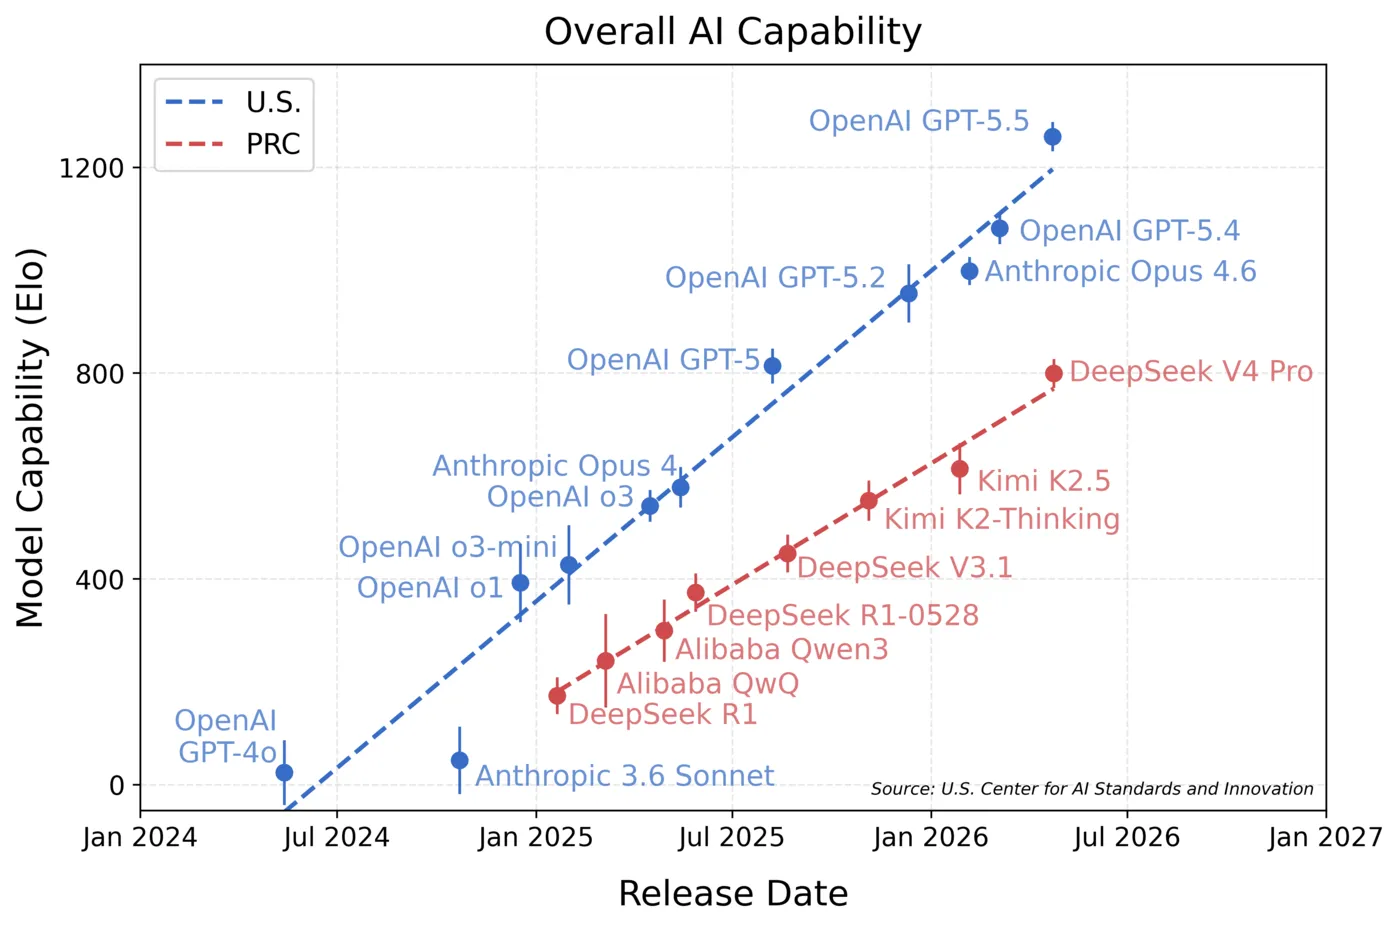
Американский институт стандартов: китайские AI-модели отстают от ChatGPT и Claude примерно на 8 месяцев, и разрыв растёт
Американский Центр стандартов и инноваций в области ИИ при NIST опубликовал оценку DeepSeek V4 Pro и пришёл к неудобному для Китая выводу: это самая сильная китайская модель в их проверках, но по совокупным возможностям она примерно на восемь месяцев позади американского фронтира. В сравнении CAISI DeepSeek V4 Pro выглядит ближе к GPT-5, чем к более свежим OpenAI GPT-5.5 и Anthropic Opus 4.6.
Это не отменяет успех DeepSeek. Скорее, показывает две разные правды о рынке: в закрытых государственных и агентных тестах китайский фронтир всё ещё отстаёт, а в открытых весах DeepSeek снова стал одним из главных игроков.
Что именно проверил CAISI
CAISI оценивал DeepSeek V4 Pro в пяти областях: кибербезопасность, программная инженерия, естественные науки, абстрактное рассуждение и математика. Часть тестов была публичной, часть — закрытой или полузакрытой, включая ARC-AGI-2 semi-private и внутренний PortBench для переноса консольных инструментов между языками программирования.
На обычных бенчмарках картина смешанная. DeepSeek V4 Pro почти не уступает в математике: 97% на OTIS-AIME-2025, 96% на PUMaC 2024 и 96% на SMT 2025. На GPQA-Diamond модель получила 90%, то есть находится рядом с Opus 4.6 и GPT-5.4 mini.
Но на более агентных и закрытых проверках разрыв заметнее. В CTF-Archive-Diamond у DeepSeek V4 Pro — 32% против 71% у GPT-5.5. В PortBench — 44% против 78% у GPT-5.5 и 60% у Opus 4.6. На ARC-AGI-2 semi-private — 46% против 79% у GPT-5.5 и 63% у Opus 4.6. Совокупная IRT-оценка CAISI: 800±28 у DeepSeek V4 Pro, 999±27 у Opus 4.6 и 1260±28 у GPT-5.5.
Почему вывод отличается от отчёта DeepSeek
По собственным данным DeepSeek, V4 Pro выглядит примерно на уровне Opus 4.6 и GPT-5.4, то есть моделей, вышедших около двух месяцев назад. CAISI утверждает, что на заранее выбранном наборе проверок, включая непубличные тесты, модель ближе к GPT-5, релиз которого был примерно восемь месяцев назад.
Это важная разница. Публичные бенчмарки всё чаще показывают не только силу модели, но и то, насколько лаборатории научились оптимизироваться под известные шкалы. CAISI специально подчёркивает, что не выбирал тесты задним числом по результатам, а использовал заранее заданный набор.
Именно поэтому график NIST важнее одной таблицы побед и поражений. В агрегированной регрессии американские публично выпущенные модели идут выше китайских, а линия китайского фронтира пока не догоняет американскую. Если читать этот график как карту гонки, DeepSeek быстро движется, но лидеры тоже ускоряются.
Другой угол: среди открытых весов DeepSeek снова наверху
Artificial Analysis даёт DeepSeek V4 Pro гораздо более комплиментарную оценку. По их Intelligence Index модель получила 52 балла, на 10 пунктов больше DeepSeek V3.2, и стала №2 среди моделей рассуждения с открытыми весами — уступая только Kimi K2.6. V4 Flash набрала 47 баллов и выглядит сильной для своего размера.
Ещё важнее агентный слой. В GDPval-AA, тесте Artificial Analysis для реальных рабочих агентных задач, DeepSeek V4 Pro набрал 1554 и обошёл Kimi K2.6, GLM-5.1, GLM-5 и MiniMax-M2.7. Для команд, которым нужна не абсолютная лучшая модель мира, а сильный открытый рабочий мотор, это серьёзный аргумент.
Но цена лидерства неоднозначна. Artificial Analysis отмечает очень высокий уровень галлюцинаций: 94% у V4 Pro и 96% у V4 Flash в сценариях, где модель не знает ответа. Кроме того, V4 Pro использовала 190 млн выходных токенов для прохождения Intelligence Index, а V4 Flash — 240 млн. Низкая цена за токен помогает, но не отменяет того, что модель может быть дорогой в длинных рассуждениях из-за объёма вывода.
Что это значит для рынка
Предыдущая статья Neuro.ee о запуске DeepSeek V4 Pro в API была про ценовую атаку и попытку стать удобным слоем для AI-интеграций. Новая оценка NIST добавляет к этой истории ограничение: дешёвый и совместимый API не автоматически означает паритет с лучшими закрытыми моделями, особенно в агентных, кибербезопасностных и инженерных задачах.
Для бизнеса вывод практичный. DeepSeek V4 Pro может быть сильным вариантом там, где важны цена, открытые веса, развёртывание у разных провайдеров и хорошая агентная производительность среди открытых весов. Но в задачах, где ошибка дорога — безопасность, научные выводы, юридические или медицинские процессы, автономное изменение кода, — высокий уровень галлюцинаций и отставание в закрытых проверках нельзя списывать как мелочь.
Мнение редакции Neuro.ee — DeepSeek остаётся одним из самых важных игроков в гонке моделей, но NIST хорошо показывает, где проходит граница между «дешёвой сильной альтернативой» и «настоящим фронтиром». Главная интрига теперь не в том, может ли Китай выпускать впечатляющие модели. Может. Вопрос в другом: сможет ли открытый китайский стек догонять передовые модели быстрее, чем OpenAI и Anthropic будут уводить планку дальше.