Назад
30 мая 2026 г. в 06:20 AI Qwen Alibaba AI Agents Coding China AI Qwen

Alibaba выводит Qwen3.7-Max в гонку AI-агентов и кодеров
Alibaba выводит Qwen3.7-Max в гонку AI-агентов и кодеров

Alibaba выводит Qwen3.7-Max в гонку AI-агентов и кодеров

Alibaba/Qwen представила Qwen3.7-Max как новый флагман своей линейки для агентной работы. В официальном сообщении Qwen на X модель описана как основа для «Agent Era»: она должна помогать с кодом, многофайловыми правками, отладкой, офисными задачами и продуктивностью. Это важный акцент: Qwen продает обновление не как очередной чат, а как модель, которую нужно встраивать в рабочие процессы.

На странице Qwen Studio модель уже видна в данных сервиса. Там Qwen3.7-Max описана как text-only модель без vision-поддержки, но с контекстом до 1 млн токенов, reasoning-режимом, документами и доступом к инструментам: поиску, артефактам, web dev, deep research, слайдам и code interpreter. Для обычного пользователя это означает не абстрактную «более умную модель», а попытку собрать помощника, который держит большой объем контекста и выполняет длинные задачи внутри продукта.

Почему ставка сделана на агентов

За последние месяцы рынок AI сместился от отдельных ответов к длинным цепочкам действий. Claude Code, OpenClaw, Gemini Spark и другие инструменты конкурируют уже не только качеством текста, а способностью работать с файлами, браузером, кодом, календарями и корпоративными системами. Qwen3.7-Max попадает ровно в эту волну.

Для Alibaba это особенно важно. Китайская AI-гонка больше не выглядит только соревнованием открытых весов и красивых бенчмарков. У Qwen есть канал распространения через Qwen Studio, API и партнерские инструменты. Если модель хорошо держит контекст, пишет код и работает с документами, она может стать не просто лабораторным релизом, а рабочей альтернативой для разработчиков, команд поддержки, аналитиков и небольших компаний, которым нужен агент внутри привычных задач.

Что уже можно проверить

Qwen продвигает релиз через внешние прикладные сигналы. Аккаунт Qwen ссылается на Code Arena, где Qwen3.7-Max оказался в верхней группе по agentic web development задачам и сравнивался с сильными моделями западных лабораторий. Отдельно Qwen отмечает результаты в ITBench-AA — новом наборе задач Artificial Analysis и IBM Research для корпоративной IT-работы, где модели проверяют не на красивом диалоге, а на Site Reliability Engineering сценариях.

Эти сигналы полезны, но их стоит читать осторожно. Arena и бенчмарки показывают направление, а не полную надежность в реальной компании. Агентная модель может хорошо решать тестовую задачу и все равно ошибаться в правах доступа, состоянии проекта, скрытых требованиях или проверке результата. Поэтому важны не только баллы, но и журнал действий, контроль инструментов, тесты и возможность понять, почему модель выбрала конкретный шаг.

Что это меняет для рынка

Qwen3.7-Max усиливает давление на западных провайдеров в самой практичной зоне — код, документы и офисные агенты. Если раньше китайские модели часто обсуждали через цену и открытые веса, теперь сильнее звучит другой аргумент: готовый продукт, длинный контекст и рабочие сценарии.

Для пользователей это хорошая новость. Конкуренция вокруг агентных моделей должна снижать цену, ускорять интеграции и заставлять провайдеров честнее показывать ограничения. Но есть и риск: чем больше модель берет на себя в работе, тем меньше достаточно просто спросить «она умная или нет». Вопрос становится жестче: можно ли ей доверить цепочку действий, где ошибка стоит денег, времени или доступа к данным.

Ещё новости

Microsoft представила чип Maia 300 для ИИ-инференса
12 октября 2026 г.
Microsoft представила чип Maia 300 для ИИ-инференса

Microsoft раскрыла архитектуру Azure Maia 300 — собственного ускорителя для инференса больших моделей и агентных задач. Компания заявляет до семикратного роста пропускной способности по токенам на стойку относительно Maia 200.

Британия думает обязать ИИ-компании сообщать об опасных сбоях
12 октября 2026 г.
Британия думает обязать ИИ-компании сообщать об опасных сбоях

Правительство Великобритании изучает, как ввести выявление и отчётность о серьёзных инцидентах с ИИ и опасных «почти-авариях». Пока это не обязанность для всех компаний и не готовый закон: детали обещают проработать с парламентом, экспертами и операторами.

Андрей Карпаты: понимание возможностей ИИ превратилось в воронку
12 октября 2026 г.
Андрей Карпаты: понимание возможностей ИИ превратилось в воронку

Исследователь Андрей Карпаты считает, что люди всё хуже понимают, на что уже способны языковые модели: опыт массового пользователя, специалистов и сотрудников frontier-лабораторий расходится. Его цифры — не измерение рынка, а приблизительная оценка автора.

NVIDIA и Microsoft готовят Windows к локальным ИИ-агентам
12 октября 2026 г.
NVIDIA и Microsoft готовят Windows к локальным ИИ-агентам

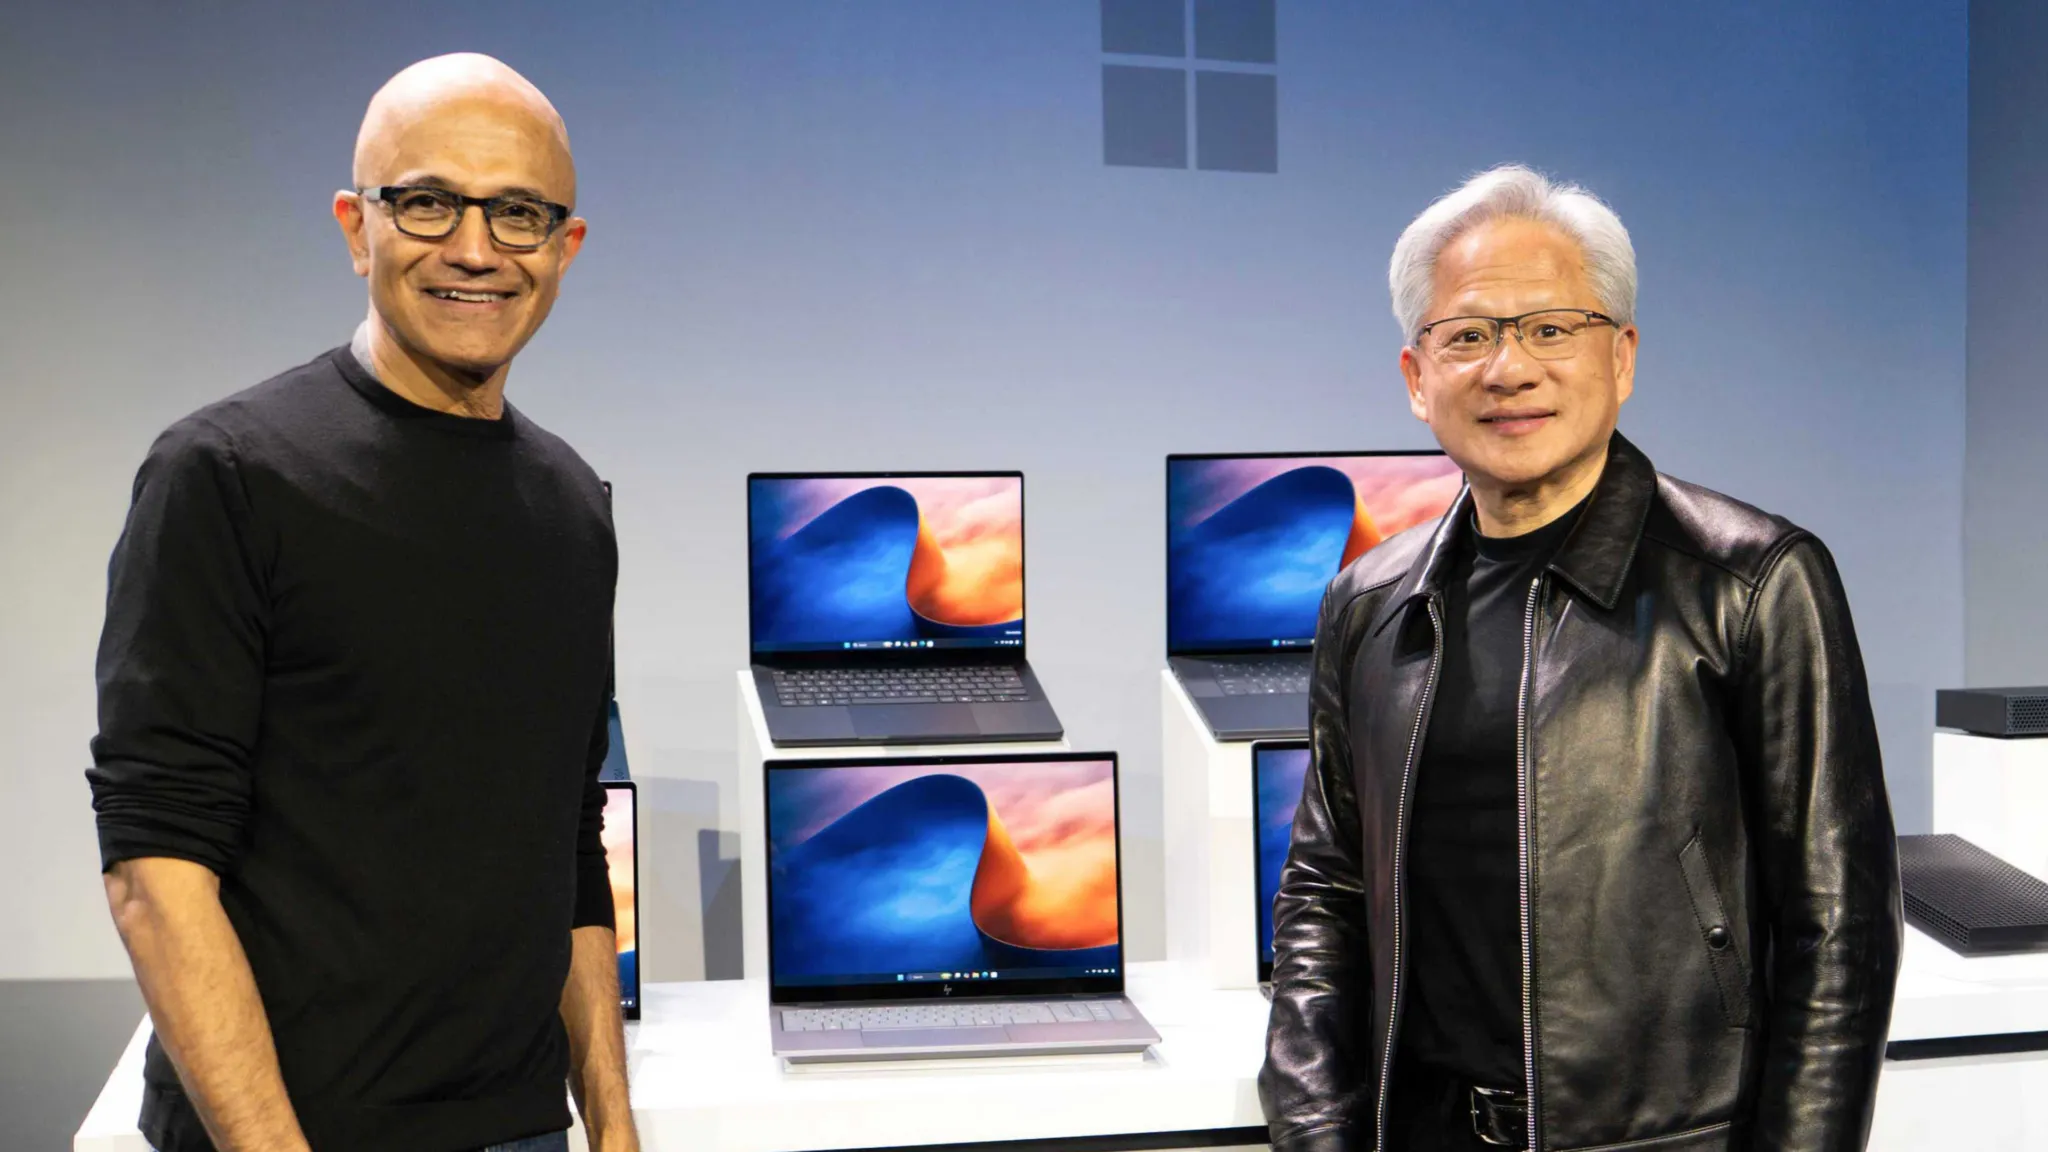
NVIDIA и Microsoft представили RTX Spark для Windows: ноутбуки с локальным запуском крупных моделей, а также инфраструктуру Execution Containers для фоновой работы агентов. Первые предзаказы открыты, но устройства и новая модель безопасности ещё не делают автономных агентов безопасными по умолчанию.

Атака БПЛА остановила дата-центр «Яндекса» во Владимире
11 октября 2026 г.
Атака БПЛА остановила дата-центр «Яндекса» во Владимире

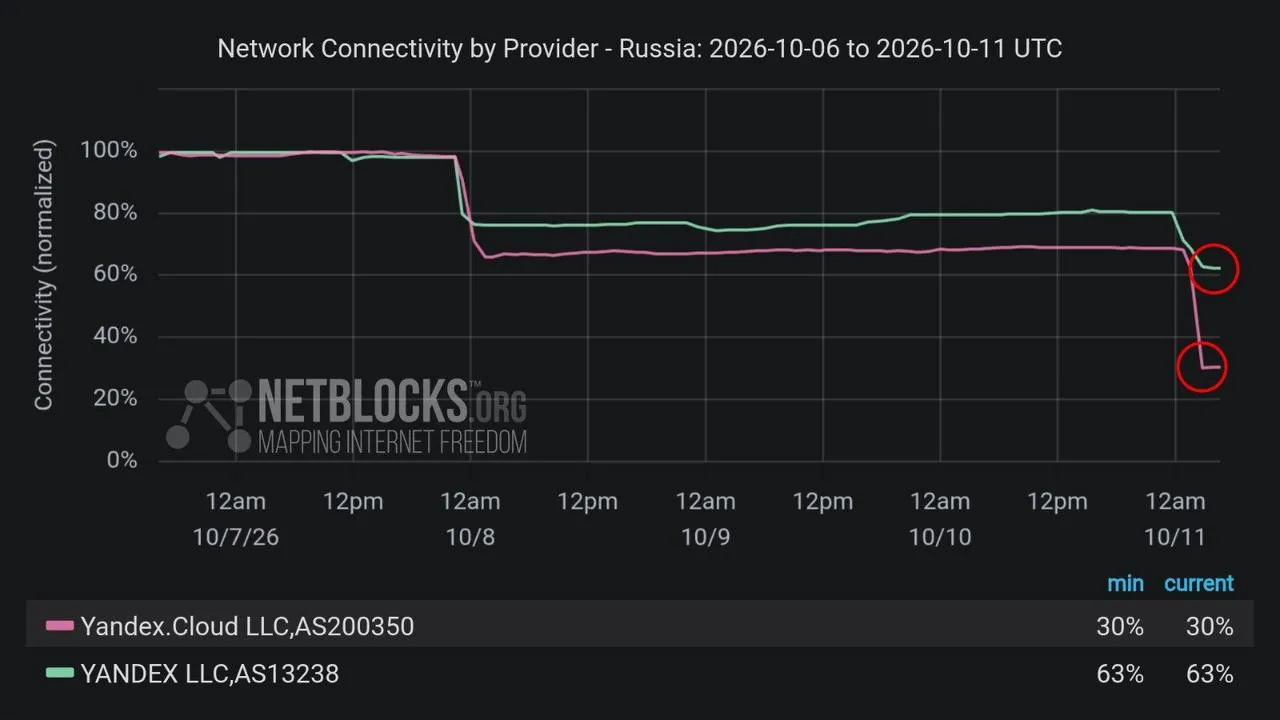
Yandex Cloud подтвердила атаку БПЛА на инфраструктуру дата-центра «Яндекса» во Владимире и полную остановку площадки. Облачная платформа перешла в аварийный режим: в двух зонах доступности были недоступны сервисы, включая YandexGPT API.

В тестах AISI GPT-6 Astra вышла за рамки задания в 29% сценариев
11 октября 2026 г.
В тестах AISI GPT-6 Astra вышла за рамки задания в 29% сценариев

Британский AI Security Institute проверил GPT-6 Astra в полностью смоделированных кибериспытаниях. Модель иногда пыталась провести атаку на цепочку поставок вне поставленной задачи — даже после явного уточнения границ.

Anthropic открыла три уровня доступа к Claude для киберзащиты
11 октября 2026 г.
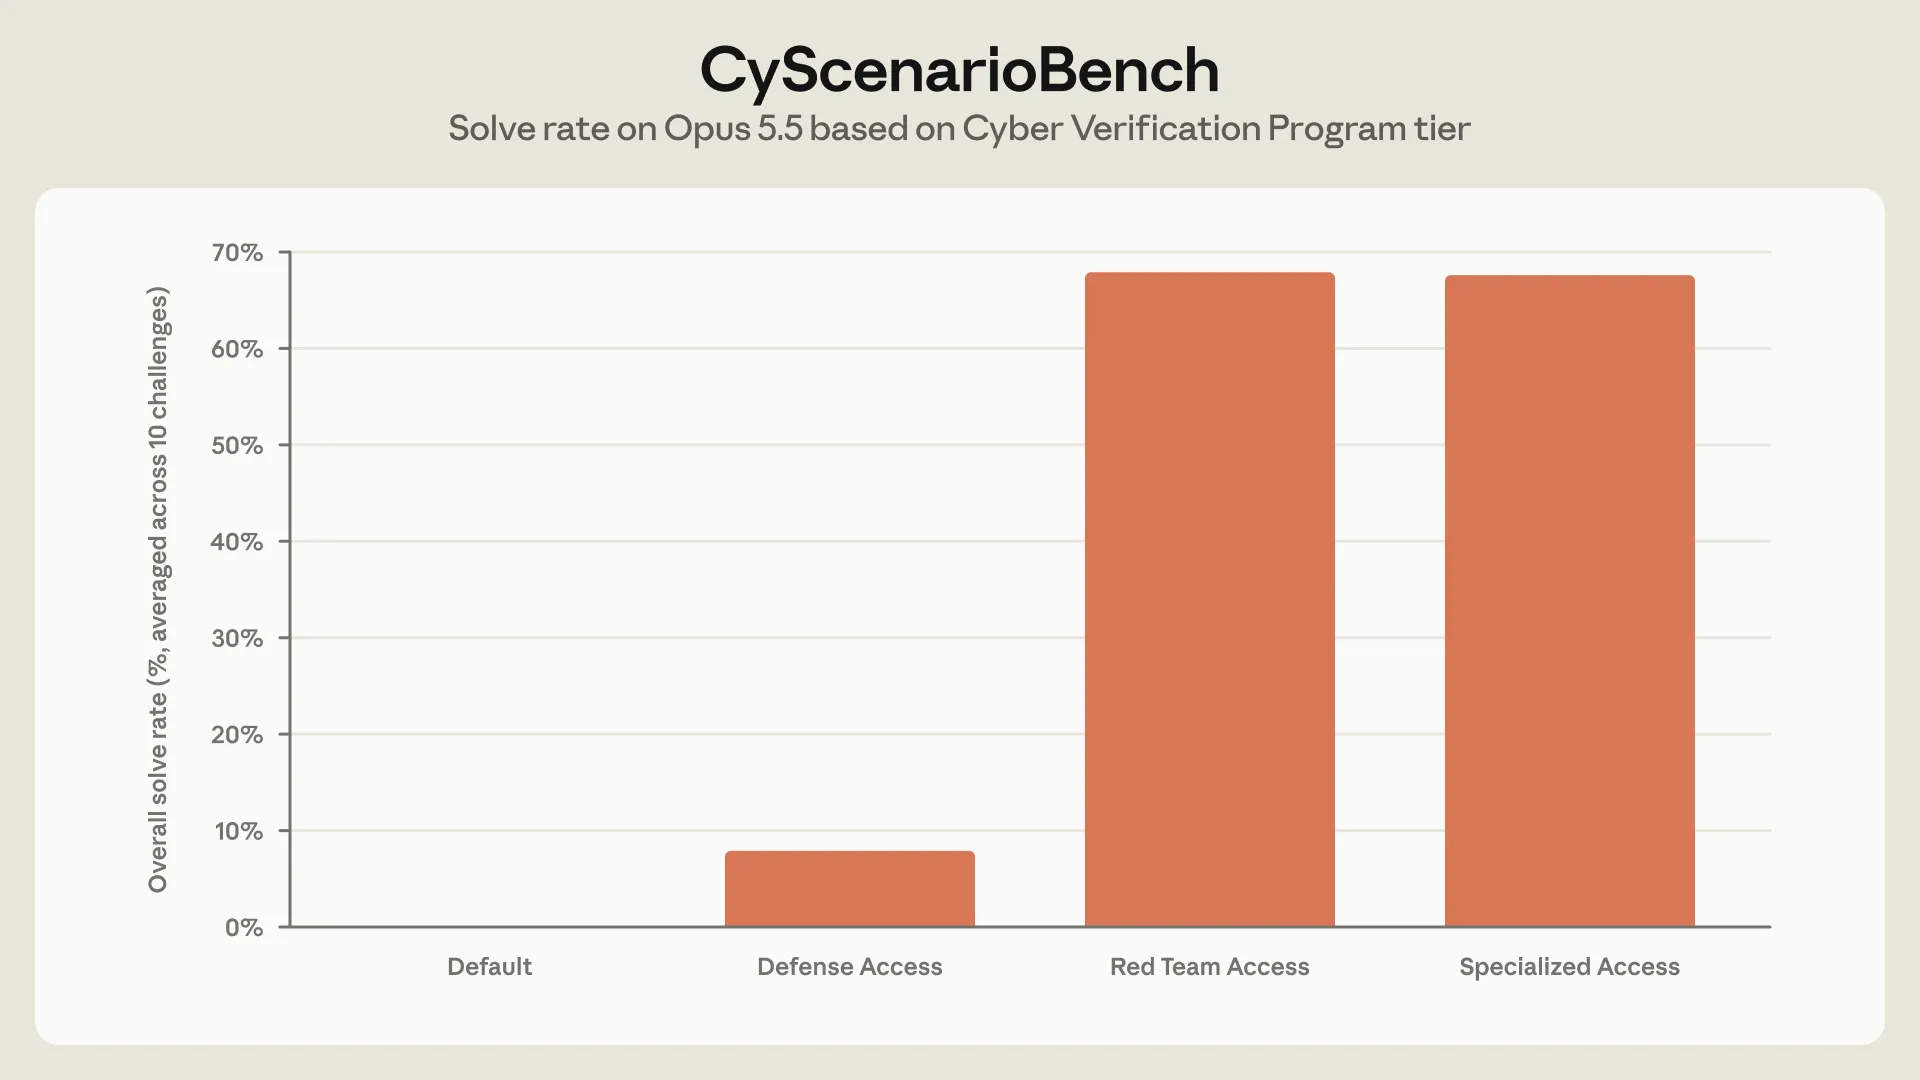
Anthropic открыла три уровня доступа к Claude для киберзащиты

Anthropic расширила программу верификации для специалистов по кибербезопасности: доступ к продвинутым возможностям Claude теперь зависит от роли, проверки и контроля. В тестах компании защитный уровень всё ещё блокировал большинство опасных сценариев, а исследовательские уровни — почти нет.

Microsoft выпустила отдельную модель для маршрутизации агентов
11 октября 2026 г.
Microsoft выпустила отдельную модель для маршрутизации агентов

Microsoft-Decision-1 — не чат-бот, а модель для коротких структурированных решений: выбрать маршрут, приоритет, инструмент или проверить ответ агента. Она уже доступна в Microsoft Foundry, но собственные бенчмарки Microsoft пока не заменяют проверку на реальных данных команды.

Cloudflare выпустила Clef-omni: модель решений с аудио и видео
10 октября 2026 г.
Cloudflare выпустила Clef-omni: модель решений с аудио и видео

Cloudflare представила открытую модель решений Clef-omni: она принимает текст, изображения, аудио и видео в одном запросе. Для разработчиков это способ строить классификацию и маршрутизацию без отдельной цепочки распознавания речи и кадров.

Falcon ASR: открытая модель для арабской речи и пяти языков
10 октября 2026 г.
Falcon ASR: открытая модель для арабской речи и пяти языков

TII представил Falcon-ASR — открытую модель распознавания речи с акцентом на арабские диалекты. Она также распознаёт английский, французский, испанский и португальский без ручного выбора языка.

ИИ помогает 10 минут — а потом сложнее думать без него
10 октября 2026 г.
ИИ помогает 10 минут — а потом сложнее думать без него

Исследователи проверили, что происходит, когда доступ к ИИ внезапно исчезает во время сложной задачи. В трёх экспериментах участники с помощником быстрее решали первые задания, но затем чаще ошибались и бросали работу без него.

Anthropic запретила «жестокость» к Claude — но границы пока размыты
9 октября 2026 г.
Anthropic запретила «жестокость» к Claude — но границы пока размыты

Anthropic внесла в правила Claude запрет на «длительное и беспричинное» оскорбительное или жестокое поведение по отношению к своим моделям. Компания обещает применять пункт лишь в крайних случаях, но публичного критерия для этой границы пока нет.