Alibaba представила DeepPlanning: новый стандарт оценки сложности ИИ-агентов
DeepPlanning: Alibaba устанавливает планку для «супер-агентов» будущего
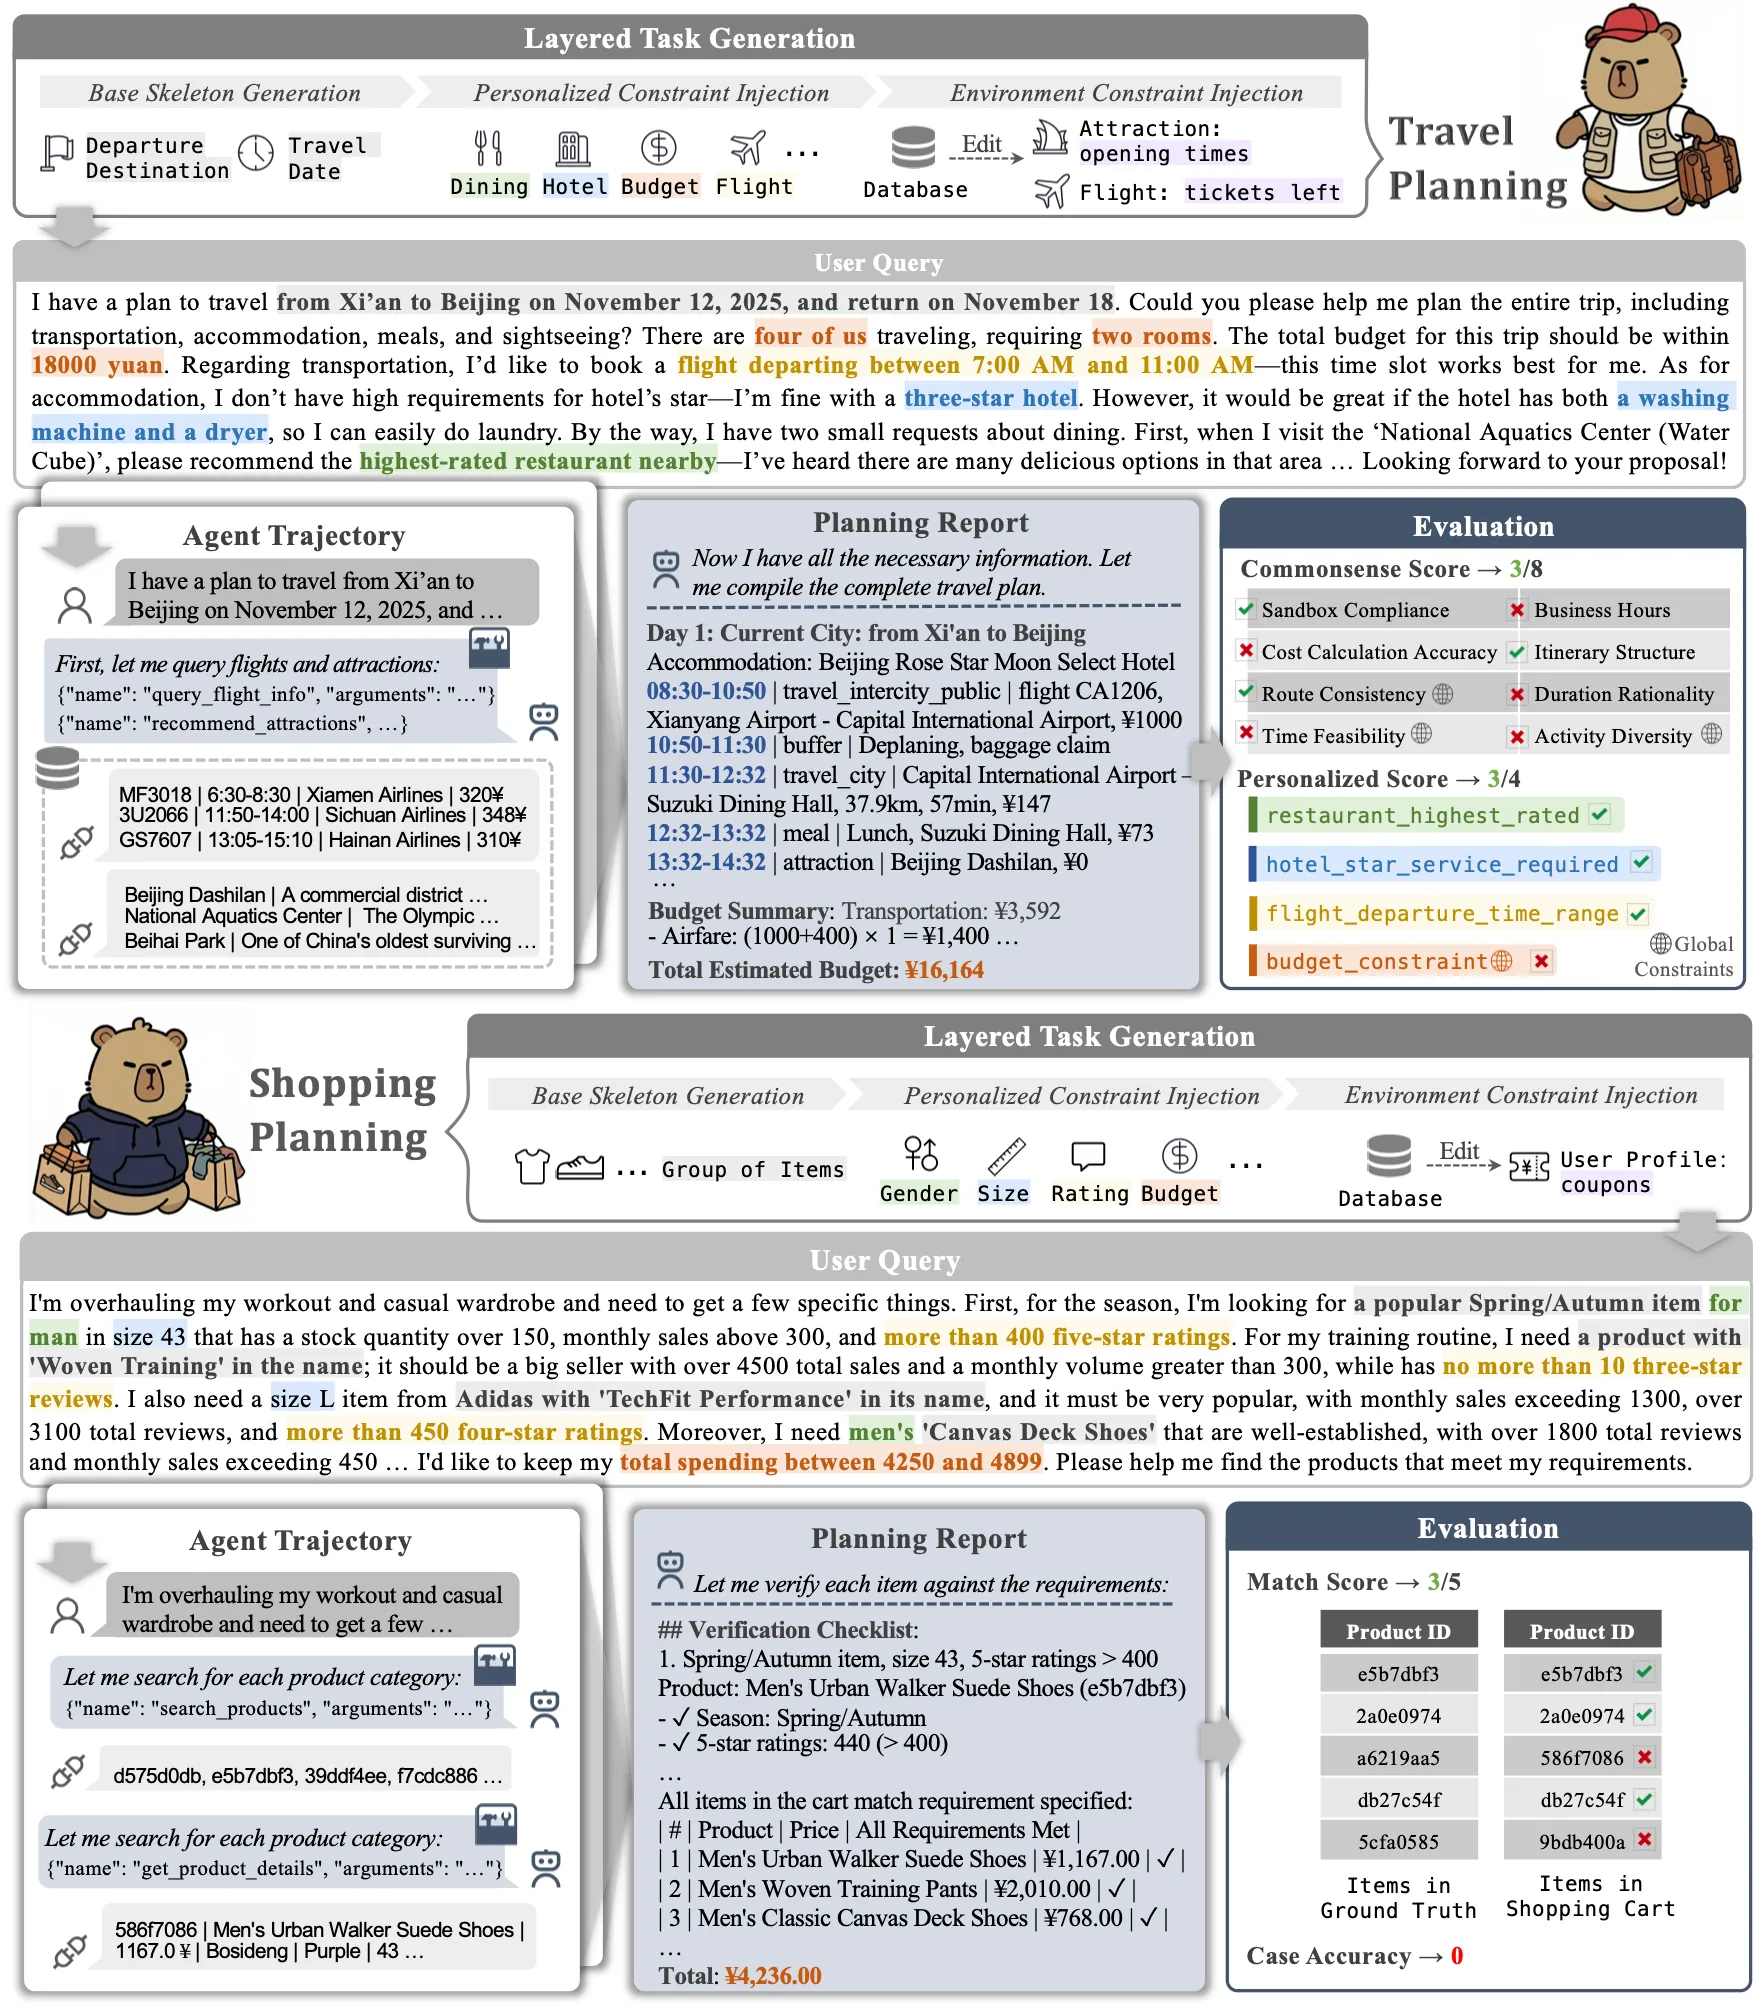
Команда разработчиков Qwen из Alibaba Cloud представила DeepPlanning — специализированный бенчмарк, предназначенный для оценки автономных ИИ-агентов в условиях сложного многоэтапного планирования. В отличие от традиционных тестов, проверяющих логику на коротких дистанциях, DeepPlanning фокусируется на «длинном горизонте» задач, где каждое действие ИИ должно соответствовать набору строгих проверяемых ограничений, таких как финансовый бюджет, временные рамки и личные предпочтения пользователя.
Переход от чат-ботов к исполнителям
Индустрия искусственного интеллекта в 2026 году окончательно сместила фокус с простых текстовых ответов на создание автономных агентов. Однако существующие методы оценки часто не учитывают способность ИИ активно собирать информацию и оптимизировать планы в реальном времени. DeepPlanning призван заполнить этот пробел, предлагая сценарии из реальной жизни: планирование многодневных путешествий и сложные закупки товаров.
В рамках теста ИИ-агенту необходимо не просто ответить на вопрос, а сформировать детальный маршрут или список покупок, используя специализированные API для поиска авиабилетов, отелей и анализа цен. Главная сложность заключается в «глобальных ограничениях» — например, агент должен спланировать поездку в рамках 1000 евро, учитывая время работы заведений и логистику между городами.
Текущие модели не справляются с нагрузкой
Результаты первых тестов в рамках DeepPlanning оказались отрезвляющими для разработчиков. Согласно отчету команды Qwen, даже самые мощные современные модели, включая флагманские проприетарные системы, демонстрируют низкую эффективность при решении задач с длительным циклом планирования.
«Оценка в рамках DeepPlanning показывает, что даже передовые агентные языковые модели с трудом справляются с этими задачами, что подчеркивает важность надежных шаблонов явного рассуждения и параллельного использования инструментов для достижения лучшего баланса эффективности», — отмечают авторы исследования.
Основные ошибки возникают на этапе интеграции данных из разных источников и при необходимости корректировать план в случае обнаружения новых ограничений. Это указывает на то, что «память» и «внимание» моделей всё еще нуждаются в архитектурных доработках для полноценной автономной работы.
Технические детали и открытый код
Бенчмарк включает в себя 120 комплексных задач на английском и китайском языках, поддерживаемых набором из 9 специализированных инструментов для путешествий и 15 — для шопинга. Тестирование проводится в изолированных песочницах Python, что позволяет верифицировать каждое действие агента.
Команда Qwen приняла решение открыть исходный код DeepPlanning для сообщества. Это позволит сторонним разработчикам тестировать свои модели в идентичных условиях, что должно ускорить появление по-настоящему надежных цифровых помощников, способных брать на себя рутинную организационную работу.
💬 Мнение редакции Neuro.ee
Появление DeepPlanning знаменует собой конец эпохи «пустых» бенчмарков. Для пользователей это означает, что в ближайшие год-два мы увидим реальный прогресс в надежности ИИ-ассистентов: они перестанут просто советовать отели и начнут действительно бронировать их, учитывая каждый цент в вашем кошельке.
- qwenlm.github.ioQwen Agent: AI Agent Framework Documentation
- getmaxim.aigetmaxim.ai
- alibabacloud.comAlibaba Cloud Unveils Strategic Roadmaps for the Next Generation AI Innovations
- huggingface.coQwen (Qwen)
- siliconflow.comUltimate Guide - The Best Qwen Models in 2026
- qwen.aiQwen
- brief.bismarckanalysis.comAI 2026: Alibaba’s Qwen Seeks to Encourage AI Adoption