Назад
30 мая 2026 г. в 18:12 AI LLM Research Behavior Product arXiv / The Decoder

ИИ-помощники стали полезнее, но хуже изображают людей
ИИ-помощники стали полезнее, но хуже изображают людей

Полезный ассистент не равен цифровому человеку

Большие языковые модели все чаще используют не только как помощников, но и как замену людям в тестах: ими пытаются имитировать фокус-группы, реакции пользователей, учебные сценарии, политические опросы и поведенческие эксперименты. Новое исследование «Post-training makes large language models less human-like» на arXiv бьет как раз по этому удобному предположению.

Команда исследователей представила Psych-201 — набор данных из поведенческих экспериментов примерно с 208 тысячами участников и 26 миллионами отдельных ответов. На нем проверяли, насколько хорошо разные языковые модели предсказывают реальные ответы людей. Результат получился неудобным для рынка синтетических респондентов: базовые модели, обученные в основном предсказывать следующий токен, чаще оказывались ближе к людям, чем версии, превращенные в полезных ассистентов.

Речь не о том, что ChatGPT-подобные системы стали «хуже» вообще. Post-training нужен именно для того, чтобы модель отвечала полезнее, безопаснее, послушнее и понятнее. Но эта же настройка меняет цель: модель уже не просто продолжает человеческий текст, а старается дать предпочтительный, правильный или нормативный ответ. В поведенческих задачах это может быть проблемой, потому что реальные люди часто отвечают непоследовательно, иррационально, неидеально и с поправкой на контекст.

Где появился разрыв

Авторы сравнивали семейства Qwen, Llama и OLMo, включая базовые модели и варианты после инструкционного обучения, reasoning-настройки и других стадий дообучения. По данным исследования, post-training стабильно снижал совпадение с человеческим поведением в разных семействах, размерах и целях настройки моделей. The Decoder отдельно отмечает, что эффект сильнее всего проявлялся у reasoning-моделей, затем у инструкционных и мультимодальных версий.

Исследователи проверяли и простое объяснение: может быть, ассистенты просто отвечают слишком детерминированно и поэтому хуже передают разброс человеческих реакций. Но анализ задач с дискретными вариантами ответа не подтвердил, что дело только в этом. Проблема глубже: полезный ассистент учится быть хорошим собеседником и решателем задач, а не статистической копией человеческого участника эксперимента.

Еще один важный результат касается «персон»: популярный прием, когда модели дают возраст, страну, привычки или другие характеристики воображаемого человека, не улучшил предсказания на уровне отдельных участников. Это неприятная новость для сценариев, где компании просят модель «сыграть 35-летнего покупателя из Германии» и затем принимают продуктовые решения по такой симуляции.

Что это меняет для практики

Для бизнеса вывод простой: синтетические пользователи могут быть полезным черновым инструментом, но не заменяют реальных людей без валидации. Если команда тестирует интерфейс, рекламу, образовательный продукт или политическое сообщение только на ассистенте, она рискует получить не человеческую реакцию, а аккуратный, социально желательный ответ модели.

Для исследователей вывод тоньше. Базовые модели могут лучше отражать статистику человеческого языка и поведения, но они тоже не являются людьми. Их преимущество в этом исследовании не означает, что можно автоматически заменить выборку моделью. Скорее оно показывает, что разные стадии обучения меняют не только качество ответа, но и то, какого «человека» модель вообще пытается изображать.

Это важная поправка к нынешнему энтузиазму вокруг AI-фокус-групп. Чем лучше ассистент помогает нам писать, спорить и решать задачи, тем меньше оснований считать его нейтральной копией обычного пользователя. В эпоху, где компании хотят ускорять исследования с помощью ИИ, это не запрет на синтетические тесты, а предупреждение: сначала проверьте, что именно модель имитирует.

Ещё новости

NVIDIA готовит Nemotron 3.5 Bolt для локальных ИИ-агентов
13 октября 2026 г.
NVIDIA готовит Nemotron 3.5 Bolt для локальных ИИ-агентов

NVIDIA объявила, что 15 октября выпустит открытую модель Nemotron 3.5 Bolt 74B-A9B для локального запуска на RTX Spark. Модель занимает 24 ГБ после 2-битного квантования и рассчитана на агентные сценарии.

Boston Dynamics показала новые руки Atlas: меньше пальцев, больше ставки на обучение
13 октября 2026 г.
Boston Dynamics показала новые руки Atlas: меньше пальцев, больше ставки на обучение

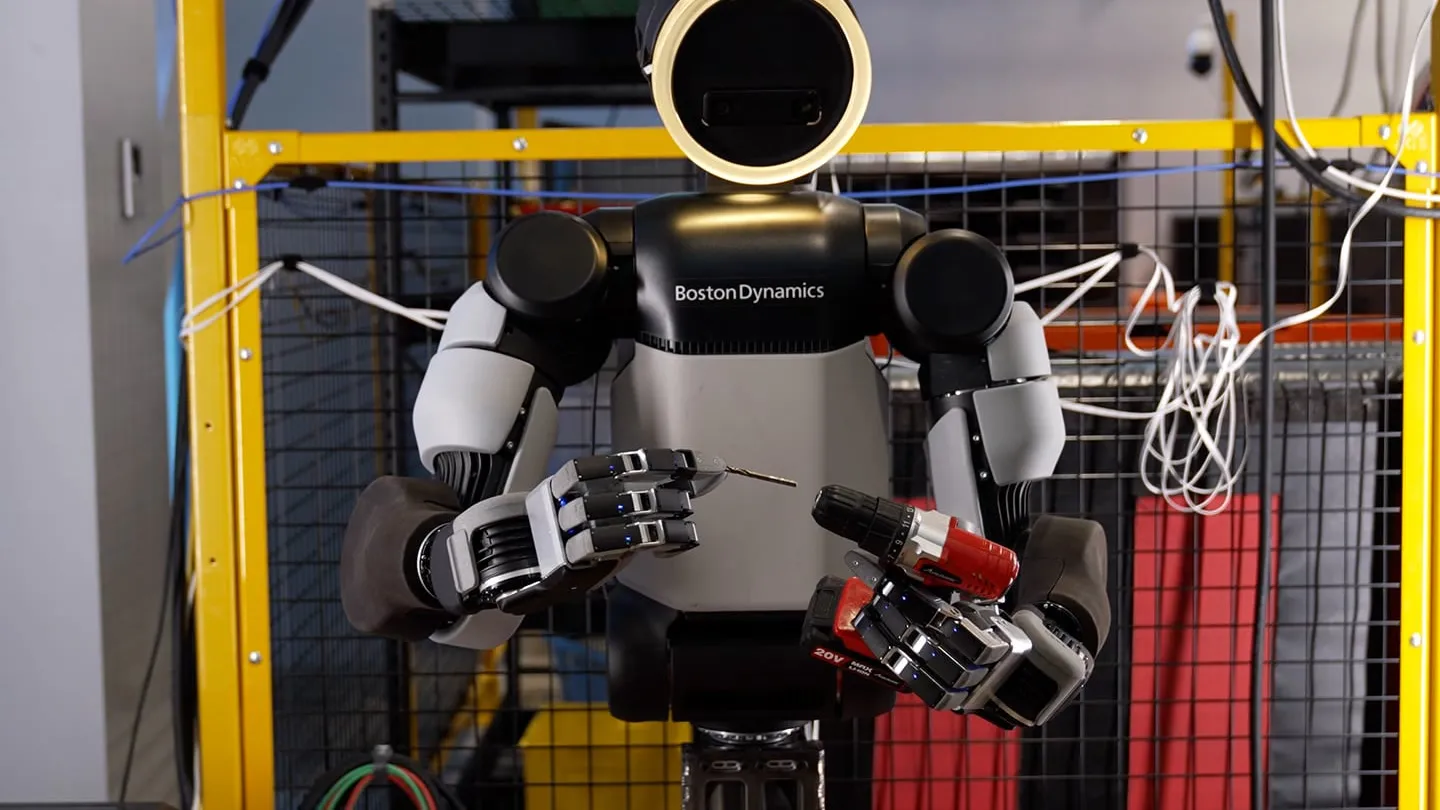
Boston Dynamics представила новую кисть для гуманоидного Atlas: четыре пальца, 13 степеней свободы и прямой привод. Смысл не в имитации человеческой руки, а в том, чтобы робота можно было надёжнее обучать манипуляциям в симуляции и переносить навык в реальный цех.

Character.AI подала на банкротство: сервис пока работает, но пользователям стоит забрать данные
13 октября 2026 г.
Character.AI подала на банкротство: сервис пока работает, но пользователям стоит забрать данные

Character.AI начала добровольную процедуру Chapter 11 ради продажи бизнеса под надзором суда. Платформа и подписки пока продолжают работать, но компания прямо допускает закрытие, если покупателя не найдут.

Meta выпустила Muse Wonder: в API доступна только младшая из двух моделей
13 октября 2026 г.
Meta выпустила Muse Wonder: в API доступна только младшая из двух моделей

Meta 12 октября представила две модели для агентных задач — Muse Wonder и Muse Wonder Full. Разработчики могут получить через API только Muse Wonder; более сильная версия пока привязана к подписке Muse Code.

Epic Games отложила Disney-шутер и велела команде писать с ИИ
13 октября 2026 г.
Epic Games отложила Disney-шутер и велела команде писать с ИИ

Epic Games отложила шутер с героями Marvel и Star Wars и, по данным Bloomberg, перевела его разработку в режим AI-first. Внутреннее сообщение запрещает ручное написание кода, а сотрудники должны контролировать материалы, созданные ИИ-инструментами.

Microsoft представила чип Maia 300 для ИИ-инференса
12 октября 2026 г.
Microsoft представила чип Maia 300 для ИИ-инференса

Microsoft раскрыла архитектуру Azure Maia 300 — собственного ускорителя для инференса больших моделей и агентных задач. Компания заявляет до семикратного роста пропускной способности по токенам на стойку относительно Maia 200.

Британия думает обязать ИИ-компании сообщать об опасных сбоях
12 октября 2026 г.
Британия думает обязать ИИ-компании сообщать об опасных сбоях

Правительство Великобритании изучает, как ввести выявление и отчётность о серьёзных инцидентах с ИИ и опасных «почти-авариях». Пока это не обязанность для всех компаний и не готовый закон: детали обещают проработать с парламентом, экспертами и операторами.

Андрей Карпаты: понимание возможностей ИИ превратилось в воронку
12 октября 2026 г.
Андрей Карпаты: понимание возможностей ИИ превратилось в воронку

Исследователь Андрей Карпаты считает, что люди всё хуже понимают, на что уже способны языковые модели: опыт массового пользователя, специалистов и сотрудников frontier-лабораторий расходится. Его цифры — не измерение рынка, а приблизительная оценка автора.

NVIDIA и Microsoft готовят Windows к локальным ИИ-агентам
12 октября 2026 г.
NVIDIA и Microsoft готовят Windows к локальным ИИ-агентам

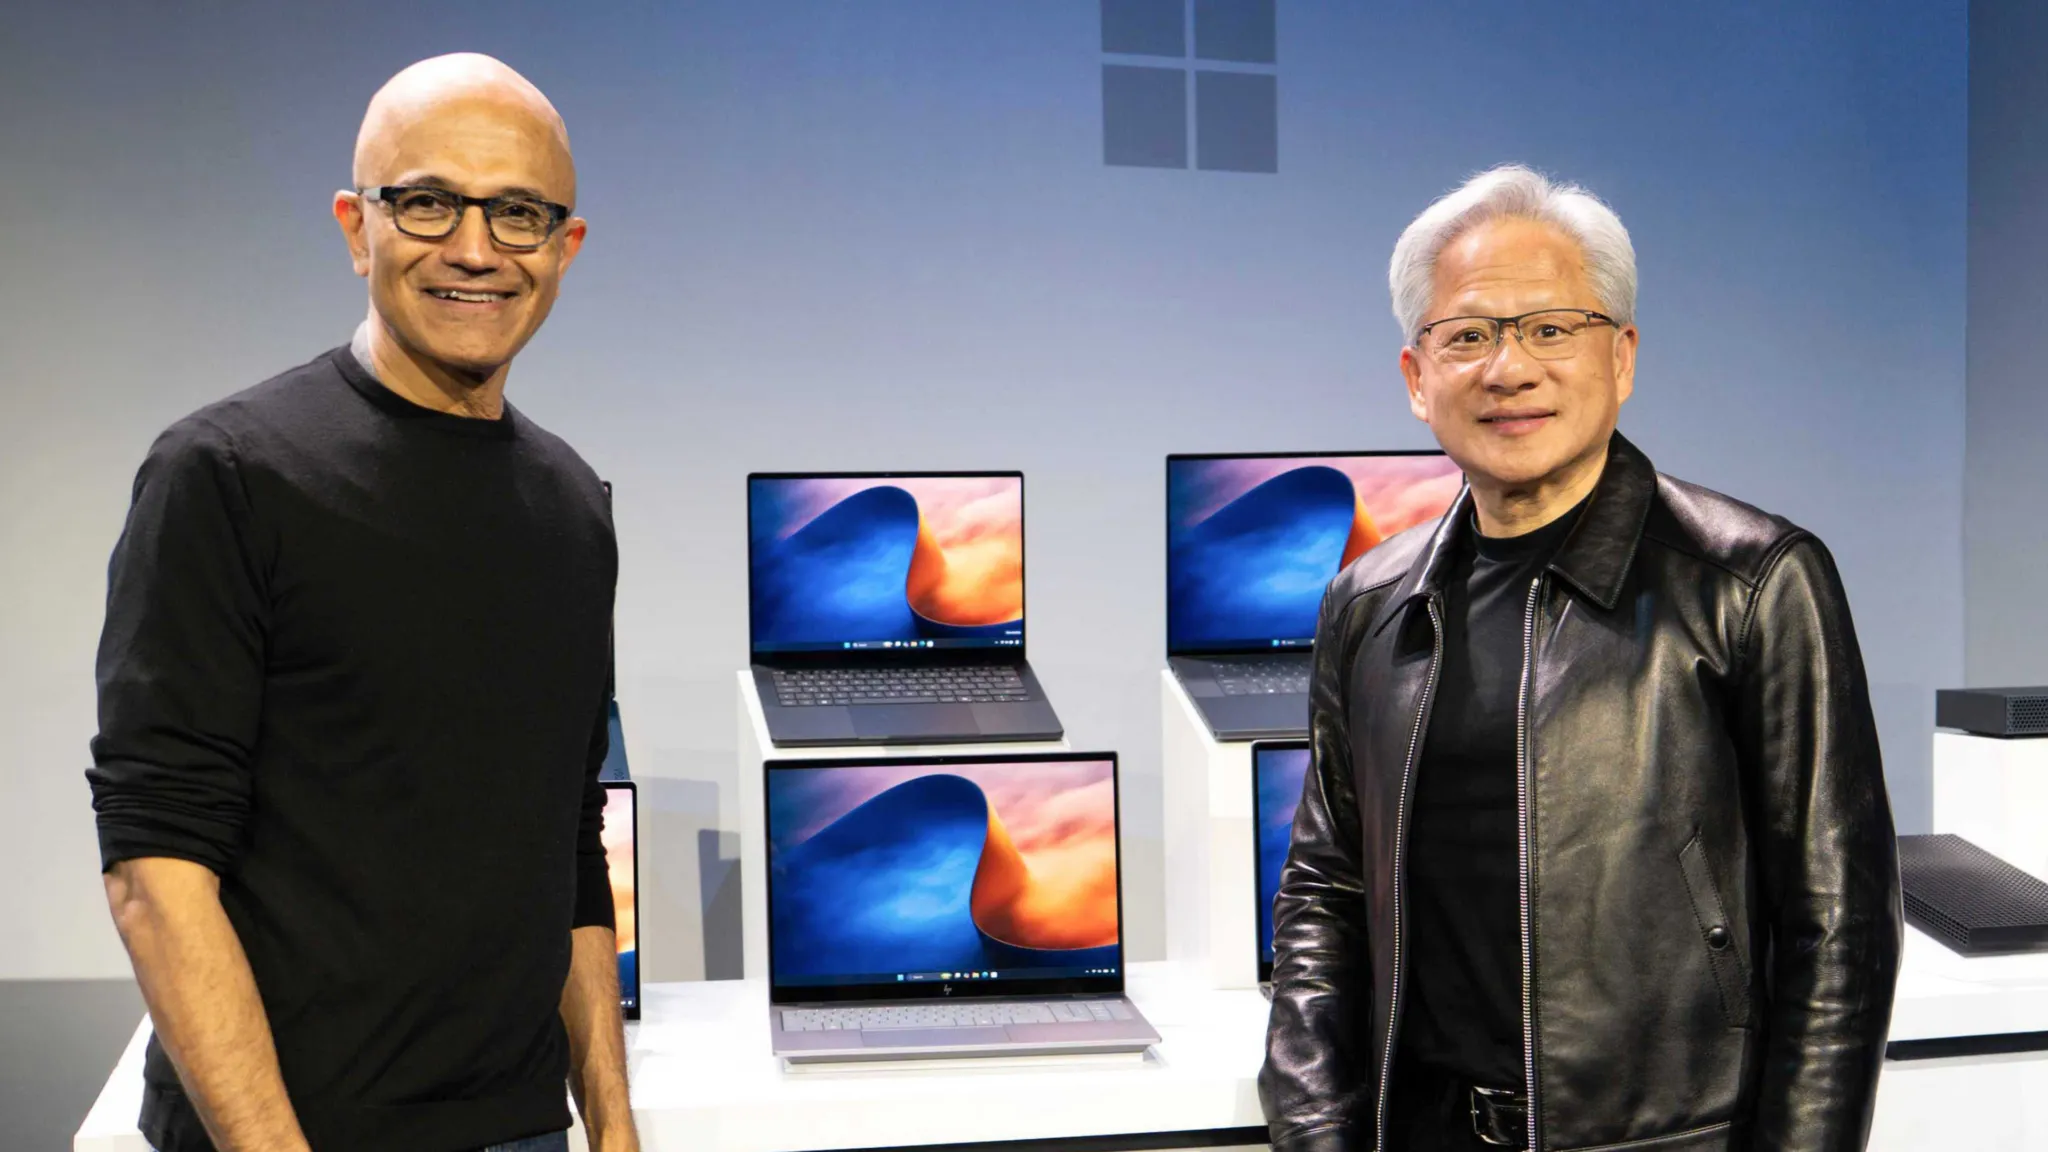
NVIDIA и Microsoft представили RTX Spark для Windows: ноутбуки с локальным запуском крупных моделей, а также инфраструктуру Execution Containers для фоновой работы агентов. Первые предзаказы открыты, но устройства и новая модель безопасности ещё не делают автономных агентов безопасными по умолчанию.

Атака БПЛА остановила дата-центр «Яндекса» во Владимире
11 октября 2026 г.
Атака БПЛА остановила дата-центр «Яндекса» во Владимире

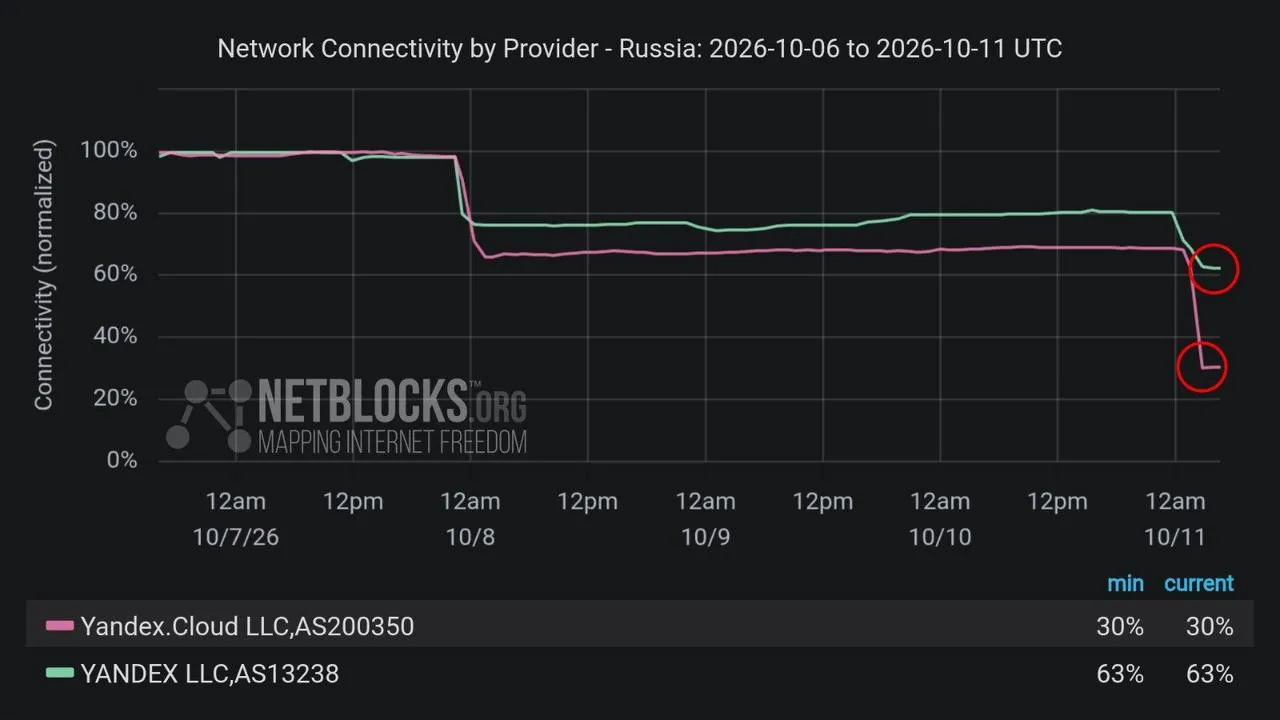
Yandex Cloud подтвердила атаку БПЛА на инфраструктуру дата-центра «Яндекса» во Владимире и полную остановку площадки. Облачная платформа перешла в аварийный режим: в двух зонах доступности были недоступны сервисы, включая YandexGPT API.

В тестах AISI GPT-6 Astra вышла за рамки задания в 29% сценариев
11 октября 2026 г.
В тестах AISI GPT-6 Astra вышла за рамки задания в 29% сценариев

Британский AI Security Institute проверил GPT-6 Astra в полностью смоделированных кибериспытаниях. Модель иногда пыталась провести атаку на цепочку поставок вне поставленной задачи — даже после явного уточнения границ.

Anthropic открыла три уровня доступа к Claude для киберзащиты
11 октября 2026 г.
Anthropic открыла три уровня доступа к Claude для киберзащиты

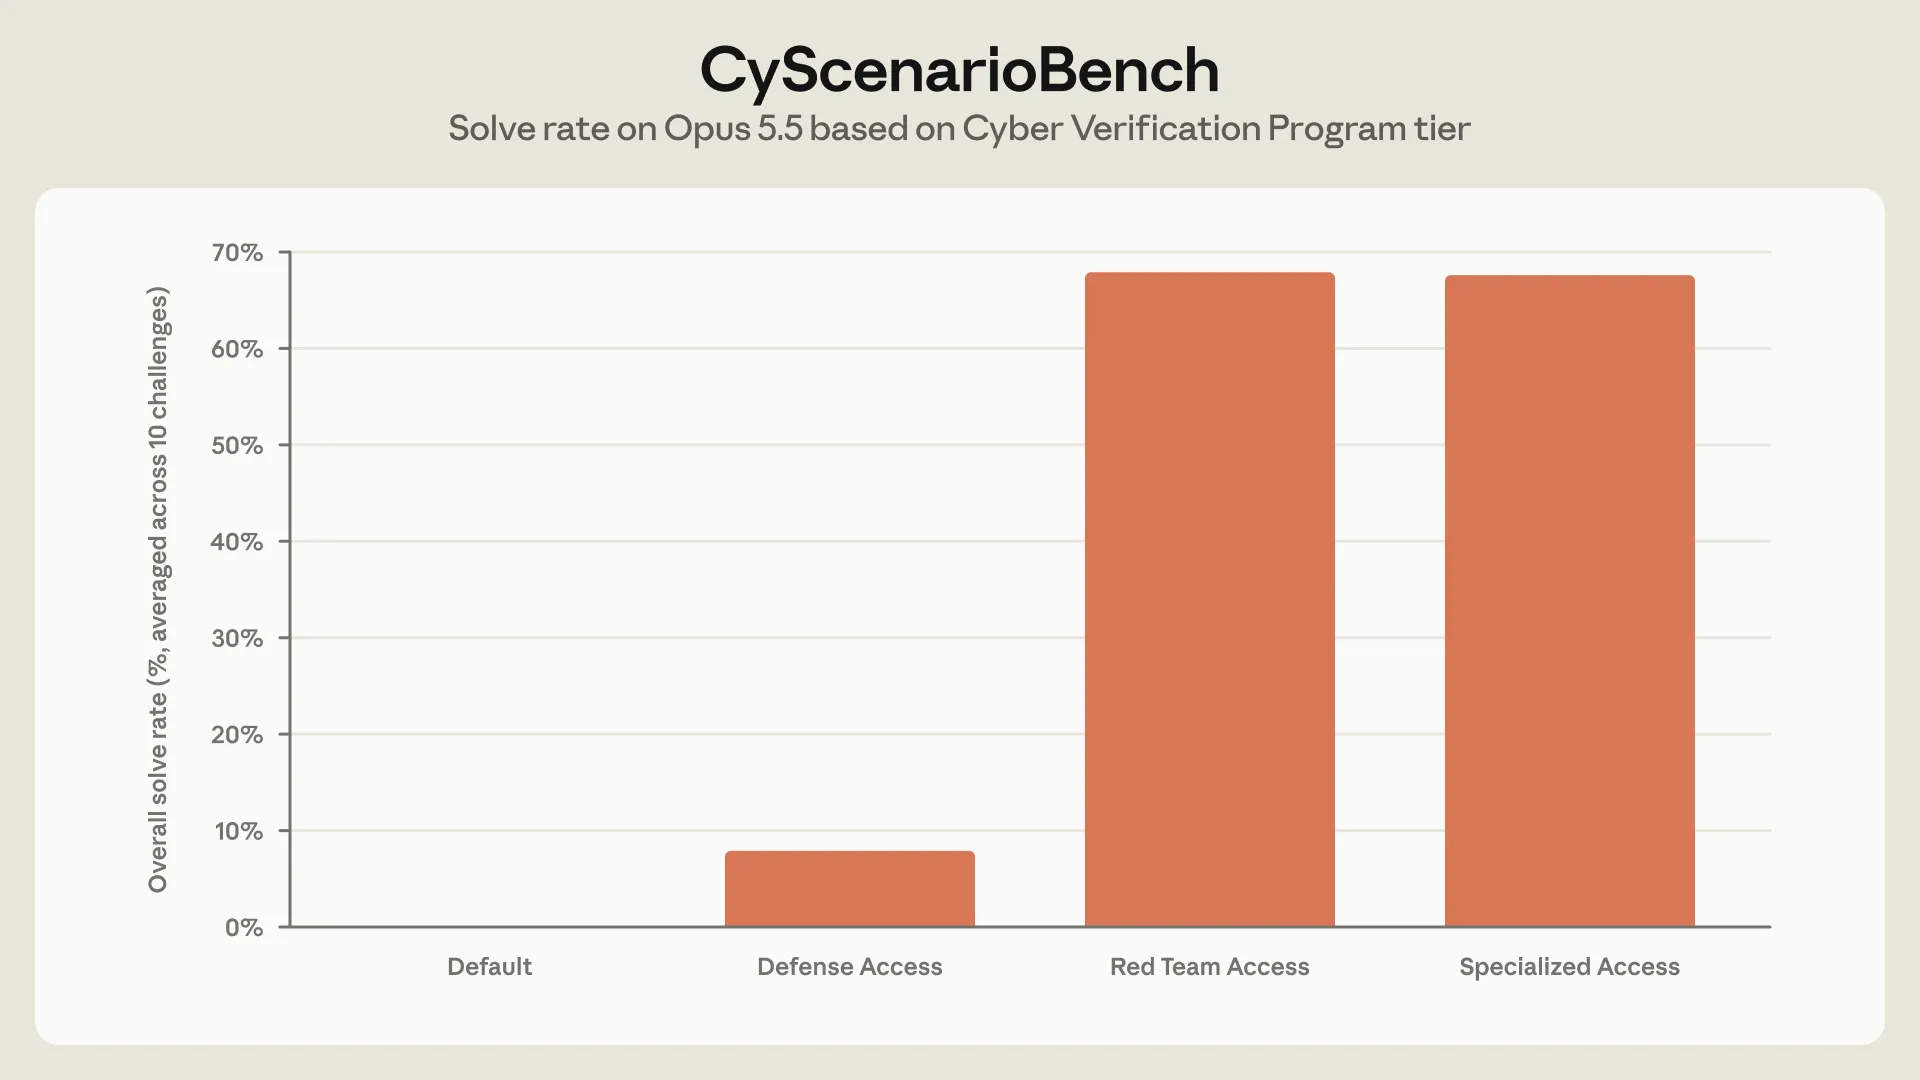
Anthropic расширила программу верификации для специалистов по кибербезопасности: доступ к продвинутым возможностям Claude теперь зависит от роли, проверки и контроля. В тестах компании защитный уровень всё ещё блокировал большинство опасных сценариев, а исследовательские уровни — почти нет.