Poolside открыла Laguna M.1: coding-agent модель на 225 млрд параметров вышла на Hugging Face
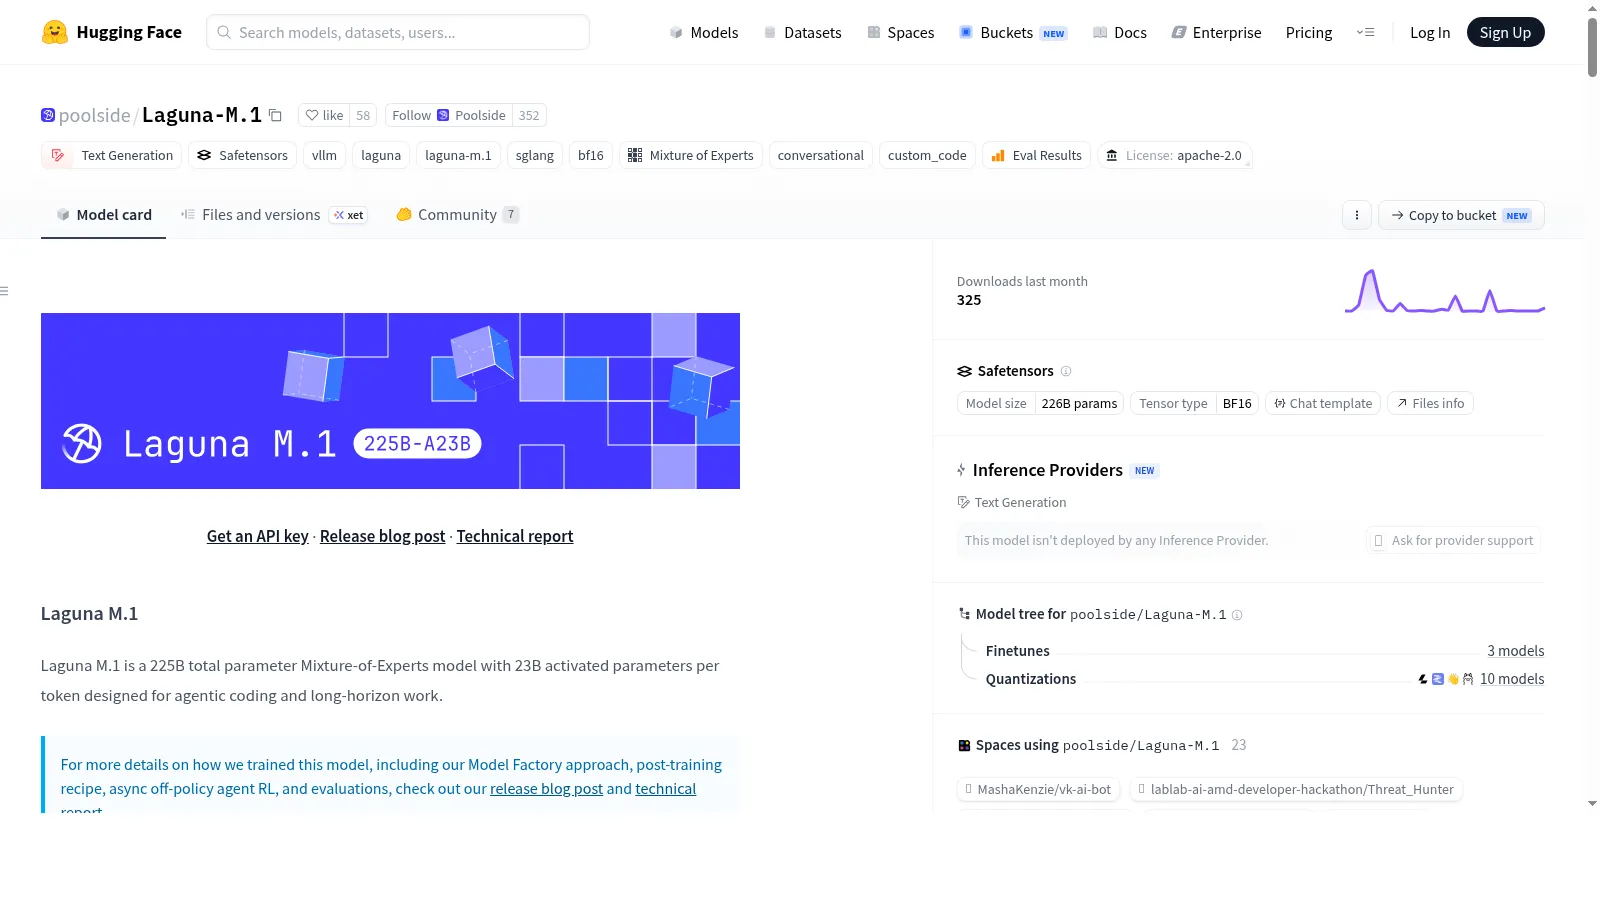
Poolside открыла на Hugging Face веса Laguna M.1 — большой модели для агентной разработки. Это не просто ещё один чекпойнт для энтузиастов: компания выкладывает модель класса 225 млрд параметров под Apache 2.0 и прямо позиционирует её как инструмент для длинных задач с кодом, терминалом и внешними инструментами.
На странице модели указано, что Laguna M.1 — sparse MoE: всего 225 млрд параметров, но на каждый токен активируются около 23 млрд. Контекстное окно заявлено на 262 144 токена. Для coding agents это важно: им нужно не только написать функцию, но и читать репозиторий, запускать тесты, исправлять ошибки, возвращаться к старым файлам и не терять состояние после десятков шагов.
Что именно открылось
Hugging Face показывает публичный репозиторий poolside/Laguna-M.1, обновлённый 18 июня 2026 года. В model card перечислены BF16-веса и отдельные FP8/NVFP4-варианты, поддержка vLLM, SGLang, Transformers и TensorRT-LLM. Там же Poolside описывает tool calling, режим рассуждения между вызовами инструментов и собственные бенчмарки: 74,6% на SWE-bench Verified, 49,2% на SWE-bench Pro и 45,8% на Terminal-Bench 2.0.
Эти цифры стоит читать аккуратно. Бенчмарки для агентного программирования быстро меняются, а сравнение моделей зависит от harness, лимитов шагов, песочниц и патчей окружения. Но сам факт публикации весов важнее красивой таблицы: раньше Laguna M.1 была заметнее как API и продуктовая история Poolside, теперь её можно изучать, запускать и адаптировать в своей инфраструктуре.
Почему это заметно для разработчиков
Рынок AI-кодинга дробится. Одни команды покупают закрытые агенты вроде Claude Code, Codex или Cursor, другие хотят держать модель ближе к своим данным, логам и политике безопасности. Для второго лагеря открытые веса меняют переговорную позицию: можно сравнивать не только цену токена, но и контроль над окружением, приватность, возможность дообучения и предсказуемость доступа.
Laguna M.1 не станет моделью для ноутбука: 225 млрд параметров требуют серьёзной инфраструктуры даже с квантизацией. Зато для компаний, хостеров и платформ это новый кандидат в слой «длинных» coding agents. После GLM-5.2, Qwen, DeepSeek и Devstral становится видно, что открытая гонка моделей для разработки уже идёт не по остаточному принципу. Она приближается к главному рабочему месту ИИ — к репозиторию, терминалу и задачам, где ошибка стоит денег.