Назад
9 июля 2026 г. в 09:00 AI OpenAI Coding Agents Benchmarks OpenAI / Techmeme

OpenAI забраковала бенчмарк для coding-агентов: треть задач может быть сломана
OpenAI забраковала бенчмарк для coding-агентов: треть задач может быть сломана

OpenAI заявила, что больше не рекомендует SWE-Bench Pro как надежный ориентир для оценки ИИ-моделей в программировании. После аудита компания оценила, что около 30% задач в публичном наборе могут быть сломаны: часть тестов слишком жестко требует конкретную реализацию, часть промптов недоописана, часть проверок пропускает неполные решения, а некоторые задания направляют модель не туда, куда потом ведут скрытые тесты.

Это важно потому, что SWE-Bench Pro как раз должен был заменить другой проблемный стандарт, SWE-bench Verified. Его продвигали как более реалистичную проверку длинных задач для coding-агентов: модель должна читать репозиторий, менять код и проходить тесты. На публичном наборе из 731 задачи, по данным OpenAI, результаты frontier-моделей за восемь месяцев выросли с 23,3% до 80,3%. Теперь сама измерительная линейка оказалась под вопросом.

Что именно нашли

OpenAI сначала прогнала задачи через pipeline анализа данных: он смотрел на попытки моделей, метаданные и следы падений. Затем подозрительные задания проверяли агентами-исследователями на базе Codex и отдельно отдавали пяти опытным инженерам. Автоматический путь отметил 200 сломанных задач, человеческая разметка — 249.

Главная претензия проста: в хорошей оценке провал должен показывать слабость модели, а успех — настоящее решение. Если тесты требуют неочевидную деталь реализации или промпт скрывает важное условие, бенчмарк начинает измерять не способность программировать, а способность угадать замысел автора теста.

Почему это касается не только лабораторий

Для компаний, которые выбирают coding-агентов, эта история снижает ценность голых leaderboard-цифр. Модель может выиграть таблицу и всё равно плохо работать в конкретном репозитории, если там другие правила, тесты, стиль кода и цена ошибки. Особенно опасны случаи, где бенчмарк пропускает неполное исправление: в продукте такой агент создаст ощущение успеха, а проблему оставит внутри системы.

Парадокс в том, что те же агенты, чьи способности пытаются измерить, уже помогают находить дефекты в самих бенчмарках. OpenAI прямо пишет, что более сильные модели позволяют глубже проверять промпты, тесты, патчи и edge cases. Значит, следующий этап гонки coding-агентов будет не только про «кто набрал больше», но и про качество самих экзаменов.

Ещё новости

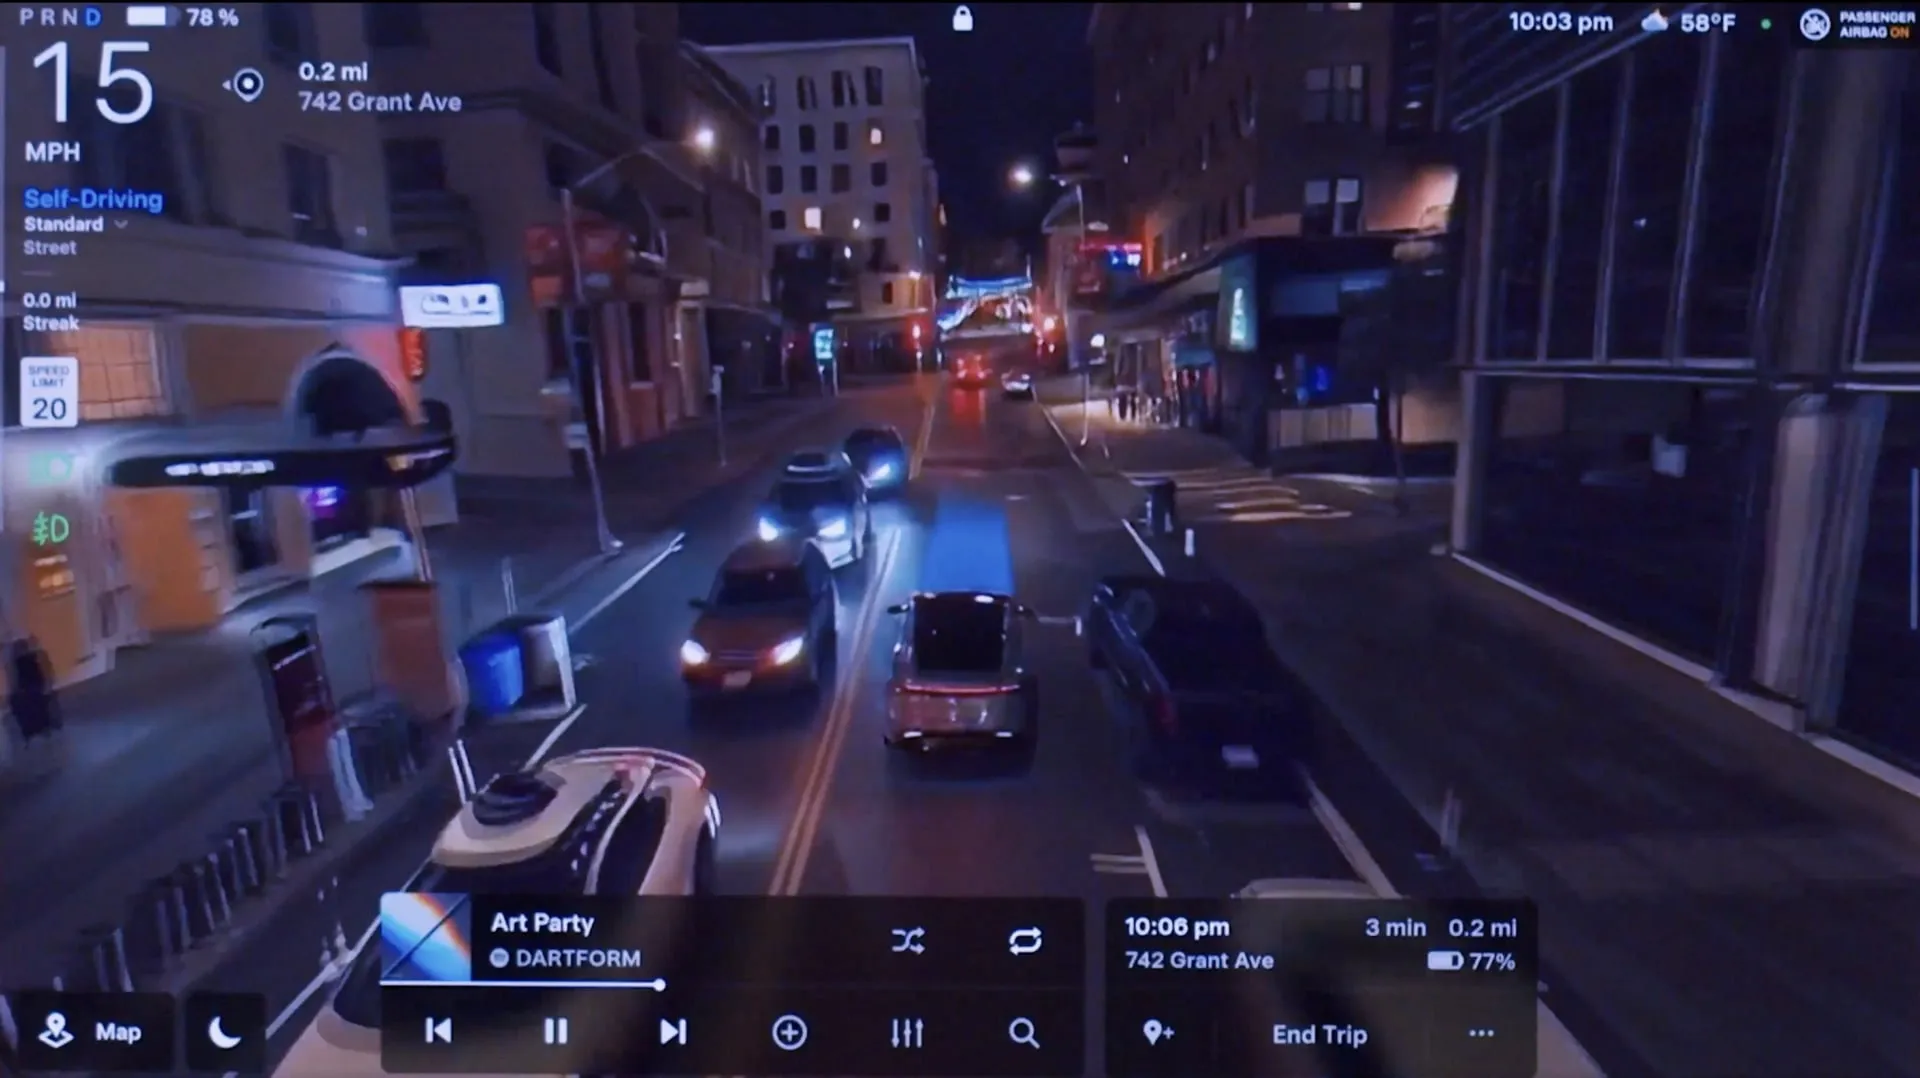
Tesla добавила в FSD v15 фотореалистичный обзор вокруг машины
22 ноября 2026 г.
Tesla добавила в FSD v15 фотореалистичный обзор вокруг машины

В FSD v15 Tesla показывает вокруг автомобиля подвижную фотореалистичную сцену. Это визуализация для водителя, а не доказательство автономного вождения.

AWS Quick перенесла рабочий ИИ в браузер
22 ноября 2026 г.
AWS Quick перенесла рабочий ИИ в браузер

AWS открыла веб-версию Quick и обновила расширение браузера и дополнения Microsoft 365. Агенты, запущенные из браузера, по заявлению компании продолжают работать после закрытия вкладки.

AWS Quick научился собирать агентов и навыки в один плагин
22 ноября 2026 г.
AWS Quick научился собирать агентов и навыки в один плагин

AWS Quick получил плагины: они объединяют агентов, навыки, коннекторы и сценарии в один устанавливаемый пакет. Компания обещает более 100 готовых навыков и плагинов, а собственный пакет можно собрать через чат.

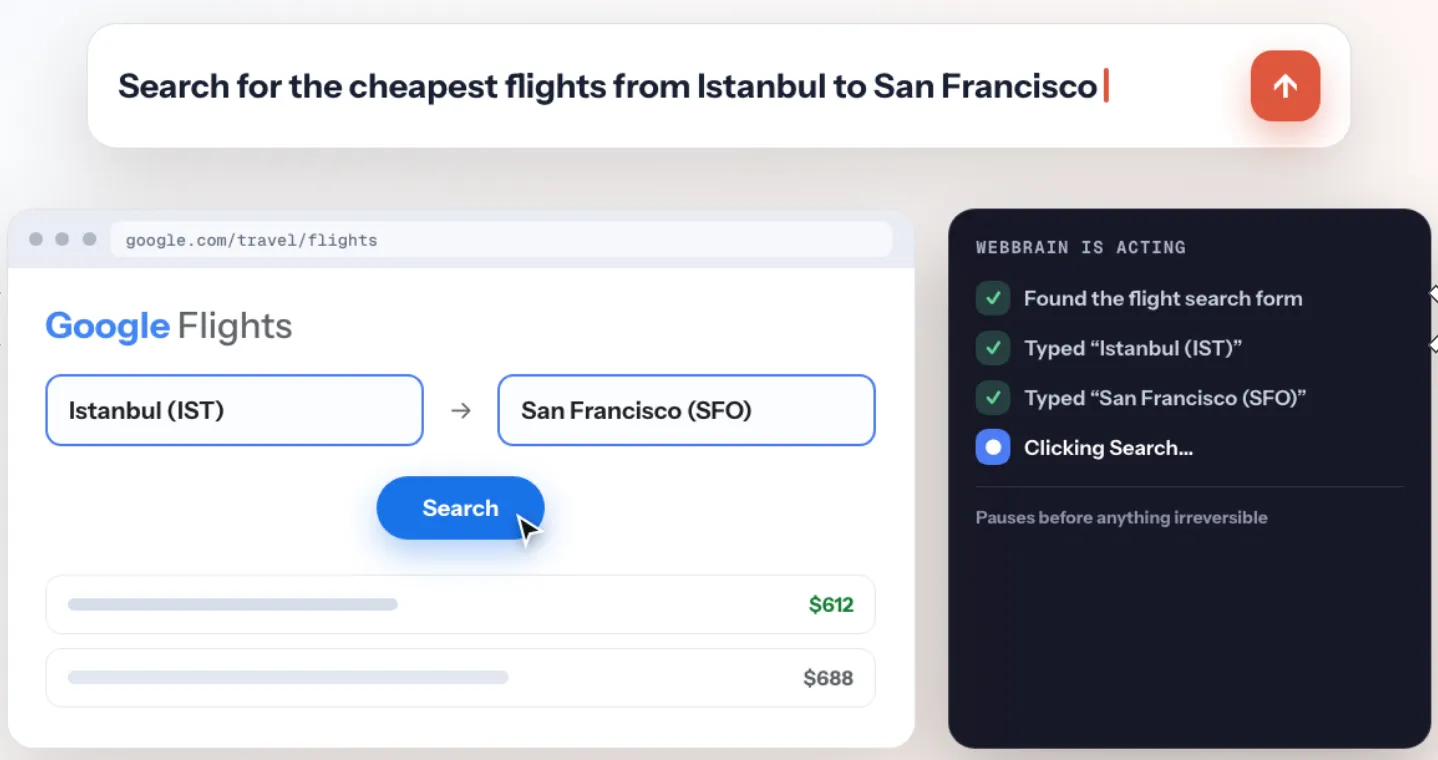
WebBrain: браузерный ИИ-агент можно запустить с локальной моделью
21 ноября 2026 г.
WebBrain: браузерный ИИ-агент можно запустить с локальной моделью

Mozilla рассказала о WebBrain — расширении для Firefox с ИИ-агентом в боковой панели. Оно умеет работать с локальными моделями, но также поддерживает облачные API: приватность зависит от выбранного провайдера и режима.

OpenAI усилила защиту моделей от кражи рассуждений
21 ноября 2026 г.
OpenAI усилила защиту моделей от кражи рассуждений

OpenAI сообщила о новых мерах против извлечения скрытых рассуждений моделей через API. Компания утверждает, что в её внутренней проверке успешность таких атак на GPT‑6.2 Astra упала с 54% до 0,2%. Для обычных пользователей это не новая функция, а ограничение того, что можно получить от модели.

AWS добавила в Textract ИИ-проверку полей по страницам документа
21 ноября 2026 г.
AWS добавила в Textract ИИ-проверку полей по страницам документа

Amazon Textract Insights извлекает поля из смешанных пакетов документов и возвращает для каждого значения оценку уверенности и привязку к странице. AWS позиционирует сервис как способ автоматизировать обработку без отказа от проверки человеком.

Математик Anthropic заявил о доказательстве гипотезы Римана с Claude
20 ноября 2026 г.
Математик Anthropic заявил о доказательстве гипотезы Римана с Claude

Математик Anthropic Левент Альпёге заявил, что вместе с Claude получил формальное доказательство гипотезы Римана и её обобщения. Код на Lean уже скомпилировался у независимого математика, но математическому сообществу ещё предстоит разобрать и подтвердить сам результат.

Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты
20 ноября 2026 г.
Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты

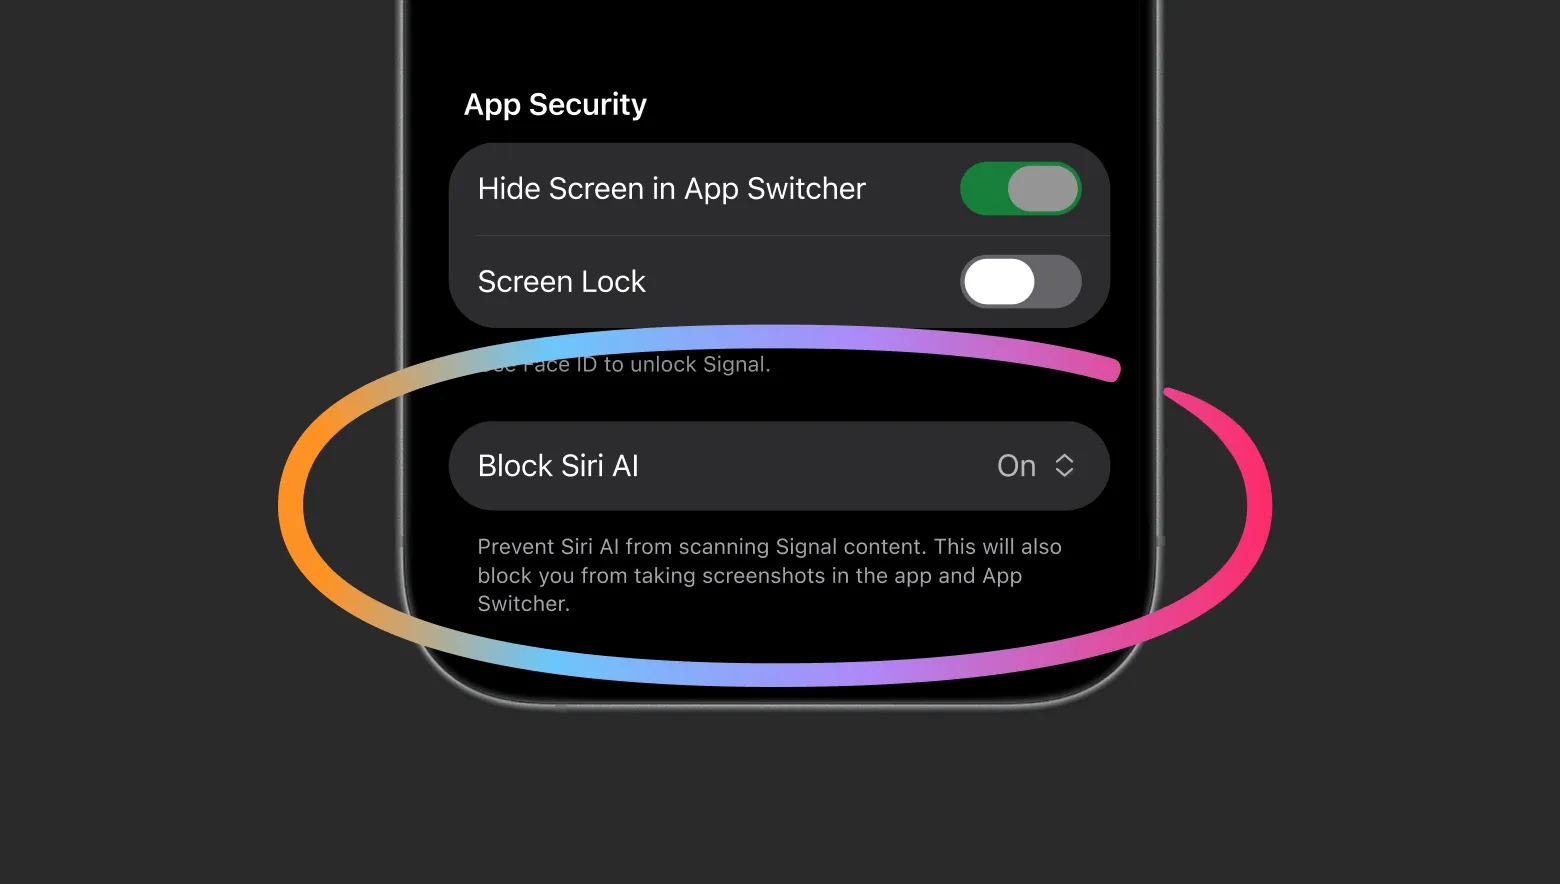
Signal вводит защиту от захвата экрана на iOS 27 и при обнаружении ИИ-помощника на Android. Мессенджер предупреждает: мера не закрывает все пути доступа и на macOS пока не работает.

В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты
20 ноября 2026 г.
В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты

В отчёте Reco описан инцидент с восемью захваченными аккаунтами Microsoft 365: после кражи сессии злоумышленники быстро меняли правила почты. Компания не утверждает, что атаку выполнил ИИ — и это важная граница для интерпретации.

DeepMind описал четыре пути от AGI к сверхинтеллекту
20 ноября 2026 г.
DeepMind описал четыре пути от AGI к сверхинтеллекту

Исследователь Google DeepMind Тим Генвейн предлагает смотреть на переход от человеческого уровня ИИ к сверхинтеллекту как на набор проверяемых технических сценариев. Это не прогноз сроков, а карта возможных ускорителей и ограничений.

Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены
19 ноября 2026 г.
Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены

Google представила Gemini 4 Neon — модель для сложных задач в коде, офисной работе и науке. Компания заявляет качество уровня Gemini 4 Carbon при трёхкратной скорости и 60% стоимости; проверять это стоит на собственных задачах.

GitHub открыла протокол для сессий AI-агентов между устройствами
19 ноября 2026 г.
GitHub открыла протокол для сессий AI-агентов между устройствами

GitHub описала открытый Agent Host Protocol: он сохраняет состояние AI-агента при переходе между VS Code, Copilot, телефоном и облаком. Это не новый агент, а общий способ подключать клиентов к уже работающей сессии.