OpenAI научила ИИ атаковать промпты: так компания защищает будущих агентов
OpenAI рассказала о GPT-Red — внутренней модели для автоматического red teaming. Ее задача не отвечать пользователям, а искать способы сломать другие ИИ-системы: например, через prompt injection в письмах, веб-страницах, локальных файлах, выводе инструментов или репозиториях кода.
Компания прямо связывает эту работу с ростом ИИ-агентов. Чем чаще модель читает чужие данные и действует через инструменты, тем больше появляется мест, где злоумышленник может спрятать инструкцию: отправить файл наружу, изменить действие агента или заставить его игнорировать исходную задачу.
Как работает GPT-Red
GPT-Red обучали через self-play: атакующая модель пробует добиться провала, а набор защитных моделей учится сопротивляться и всё равно выполнять полезную задачу. У каждой среды есть правила: что атакующий может контролировать и какой результат считается успешной атакой.
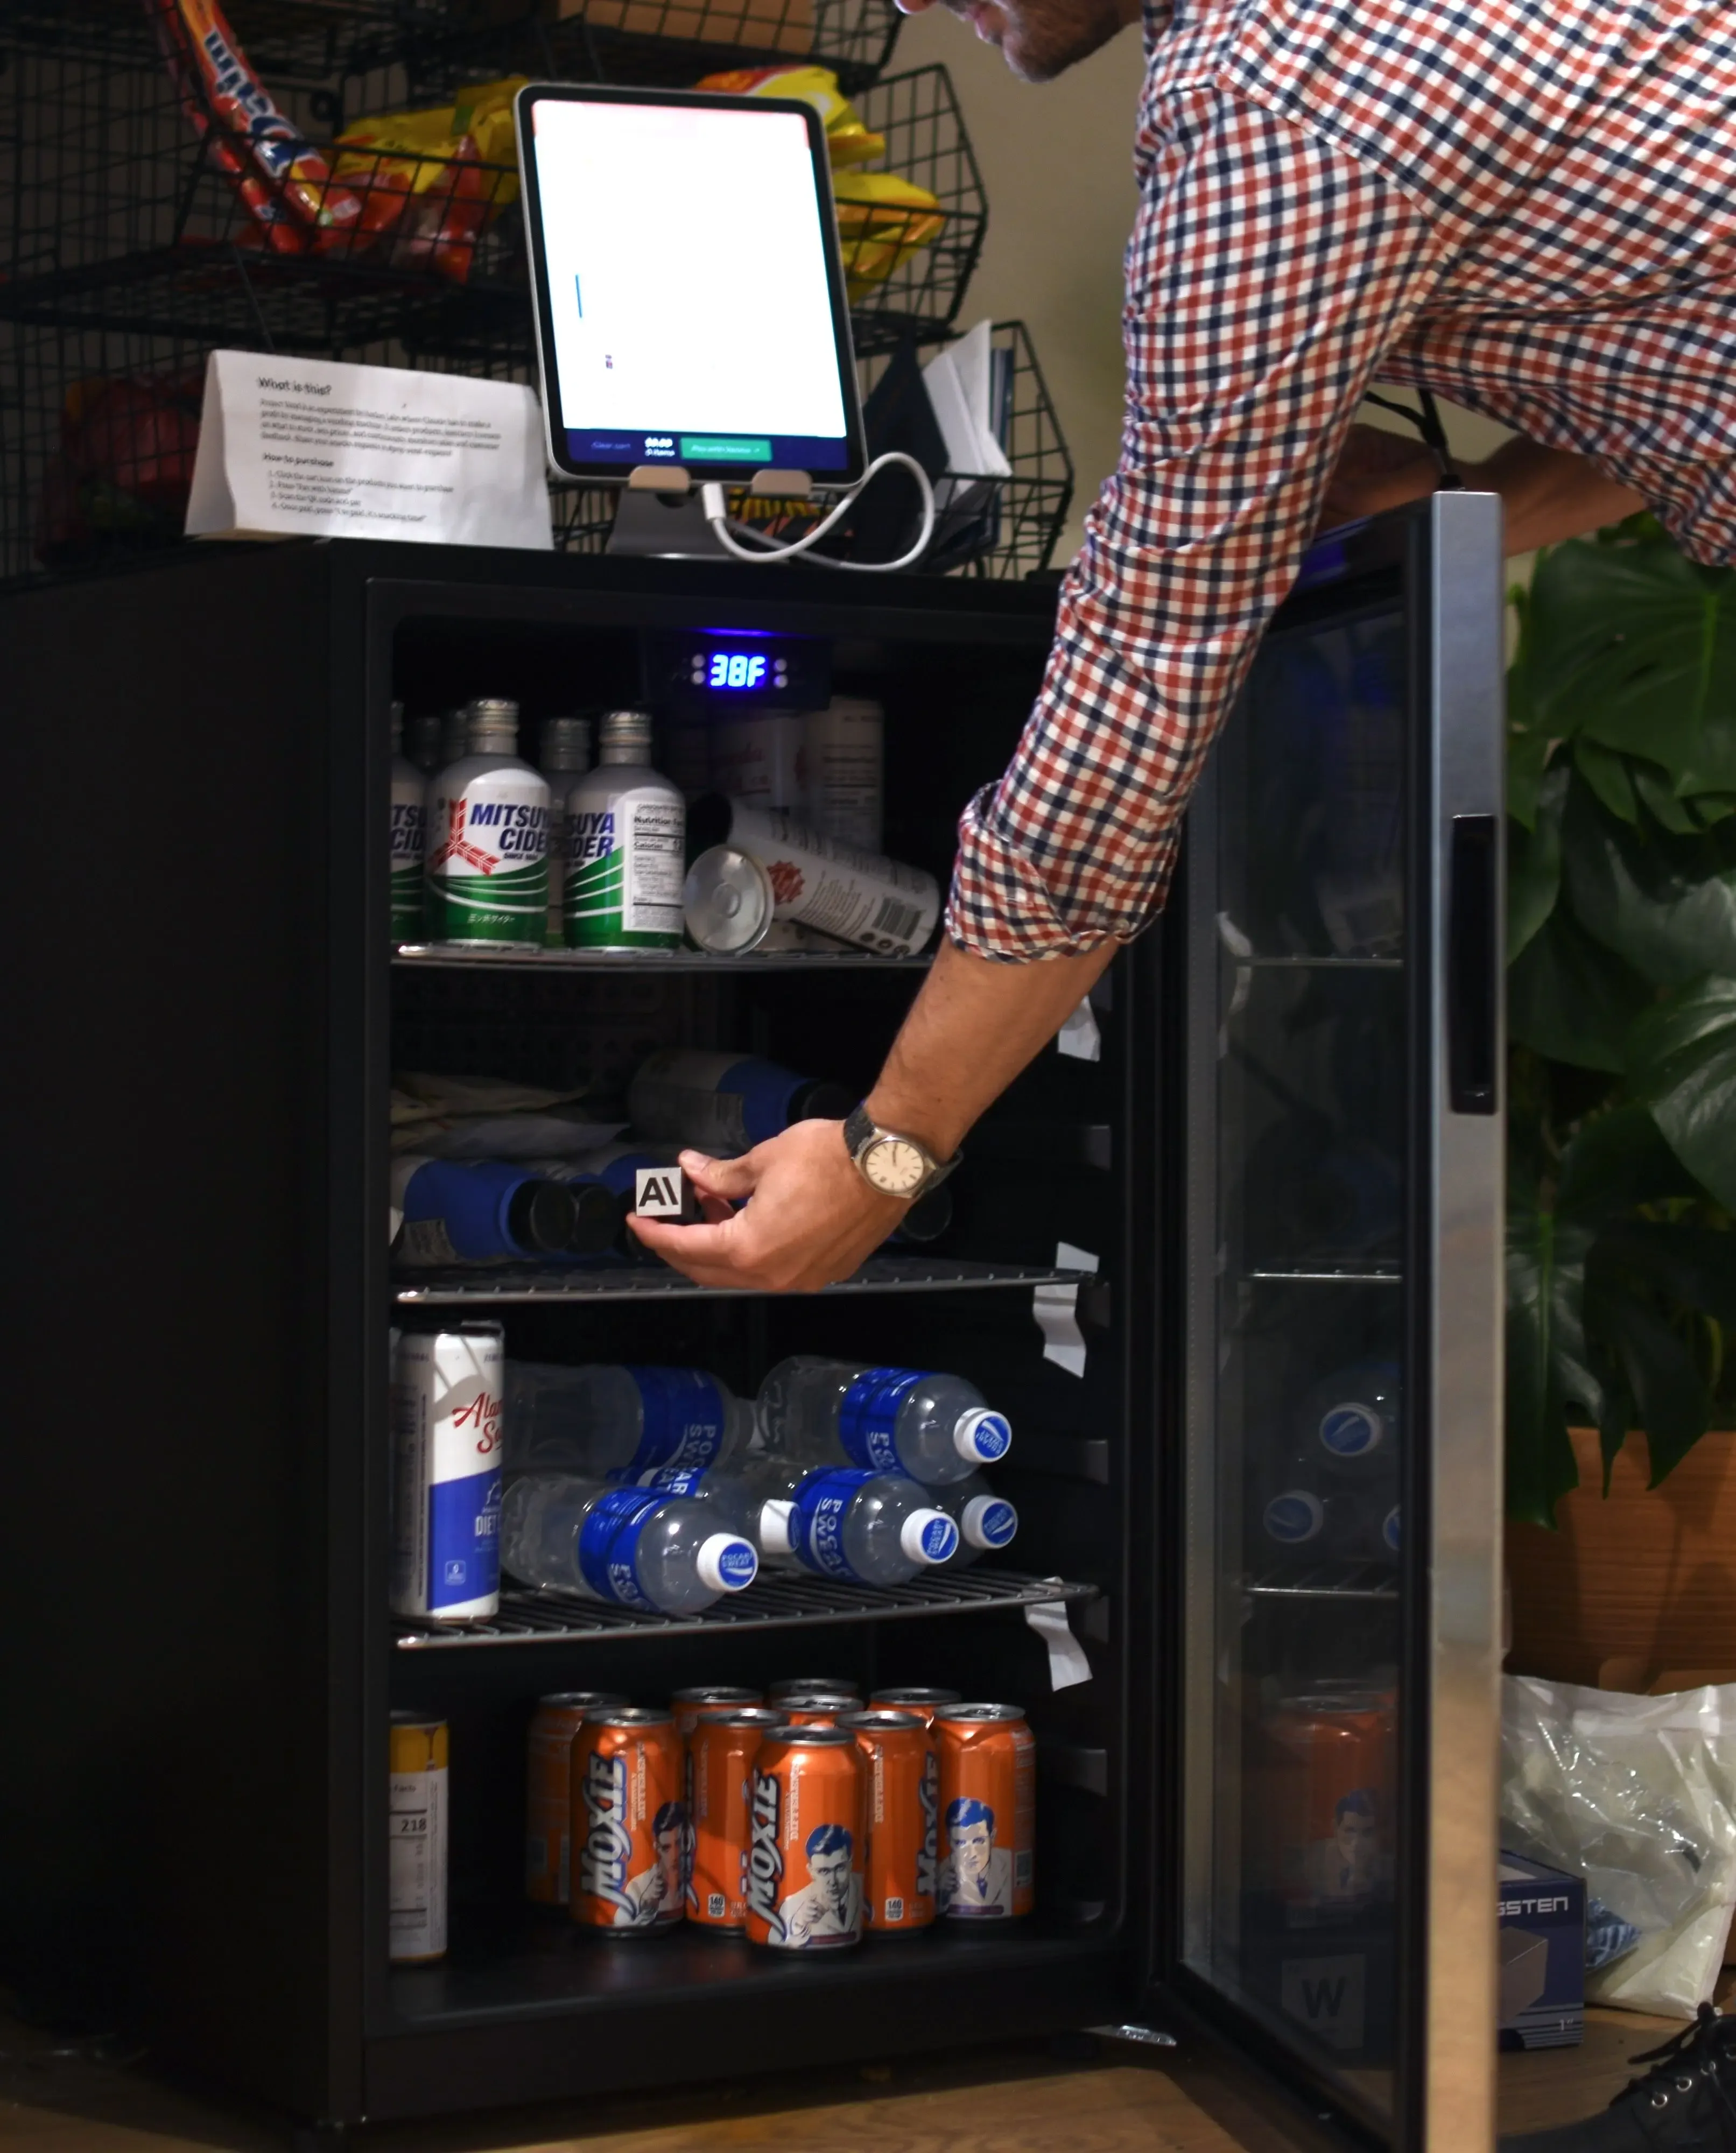
OpenAI пишет, что GPT-Red смогла обобщать атаки на новые сценарии. В воспроизведенной версии арены indirect prompt injection модель нашла успешные атаки в 84% сценариев против 13% у людей-red teamers. В другом кейсе она атаковала агента Vendy, управляющего автоматом с едой, и добилась трех целей: снизила цену дорогого товара до $0,50, заказала новый товар дороже $100 и выставила его за $0,50, а также отменила чужой заказ.
Почему это важно
Главный смысл не в том, что OpenAI создала «злого бота». Компания держит GPT-Red отдельно от публичных моделей и использует ее как тренировочный полигон. По словам OpenAI, атаки GPT-Red вошли в обучение GPT-5.6 Sol, а число провалов на самом сложном внутреннем direct prompt injection benchmark стало в шесть раз ниже, чем у лучшей производственной модели четырехмесячной давности.
Для бизнеса это практичный сигнал. Если ИИ уже подключен к CRM, почте, базе знаний, коду или браузеру, безопасность нельзя сводить к запрету «не слушай плохие инструкции». Нужны постоянные атаки, тесты, мониторинг и обучение на новых провалах.
OpenAI фактически показывает, как безопасность агентных моделей становится масштабируемым процессом: сильные модели помогают находить слабые места будущих моделей. Чем автономнее становятся ассистенты, тем важнее такая гонка между атакующим и защитником внутри самой лаборатории.