OpenAI усилила защиту моделей от кражи рассуждений
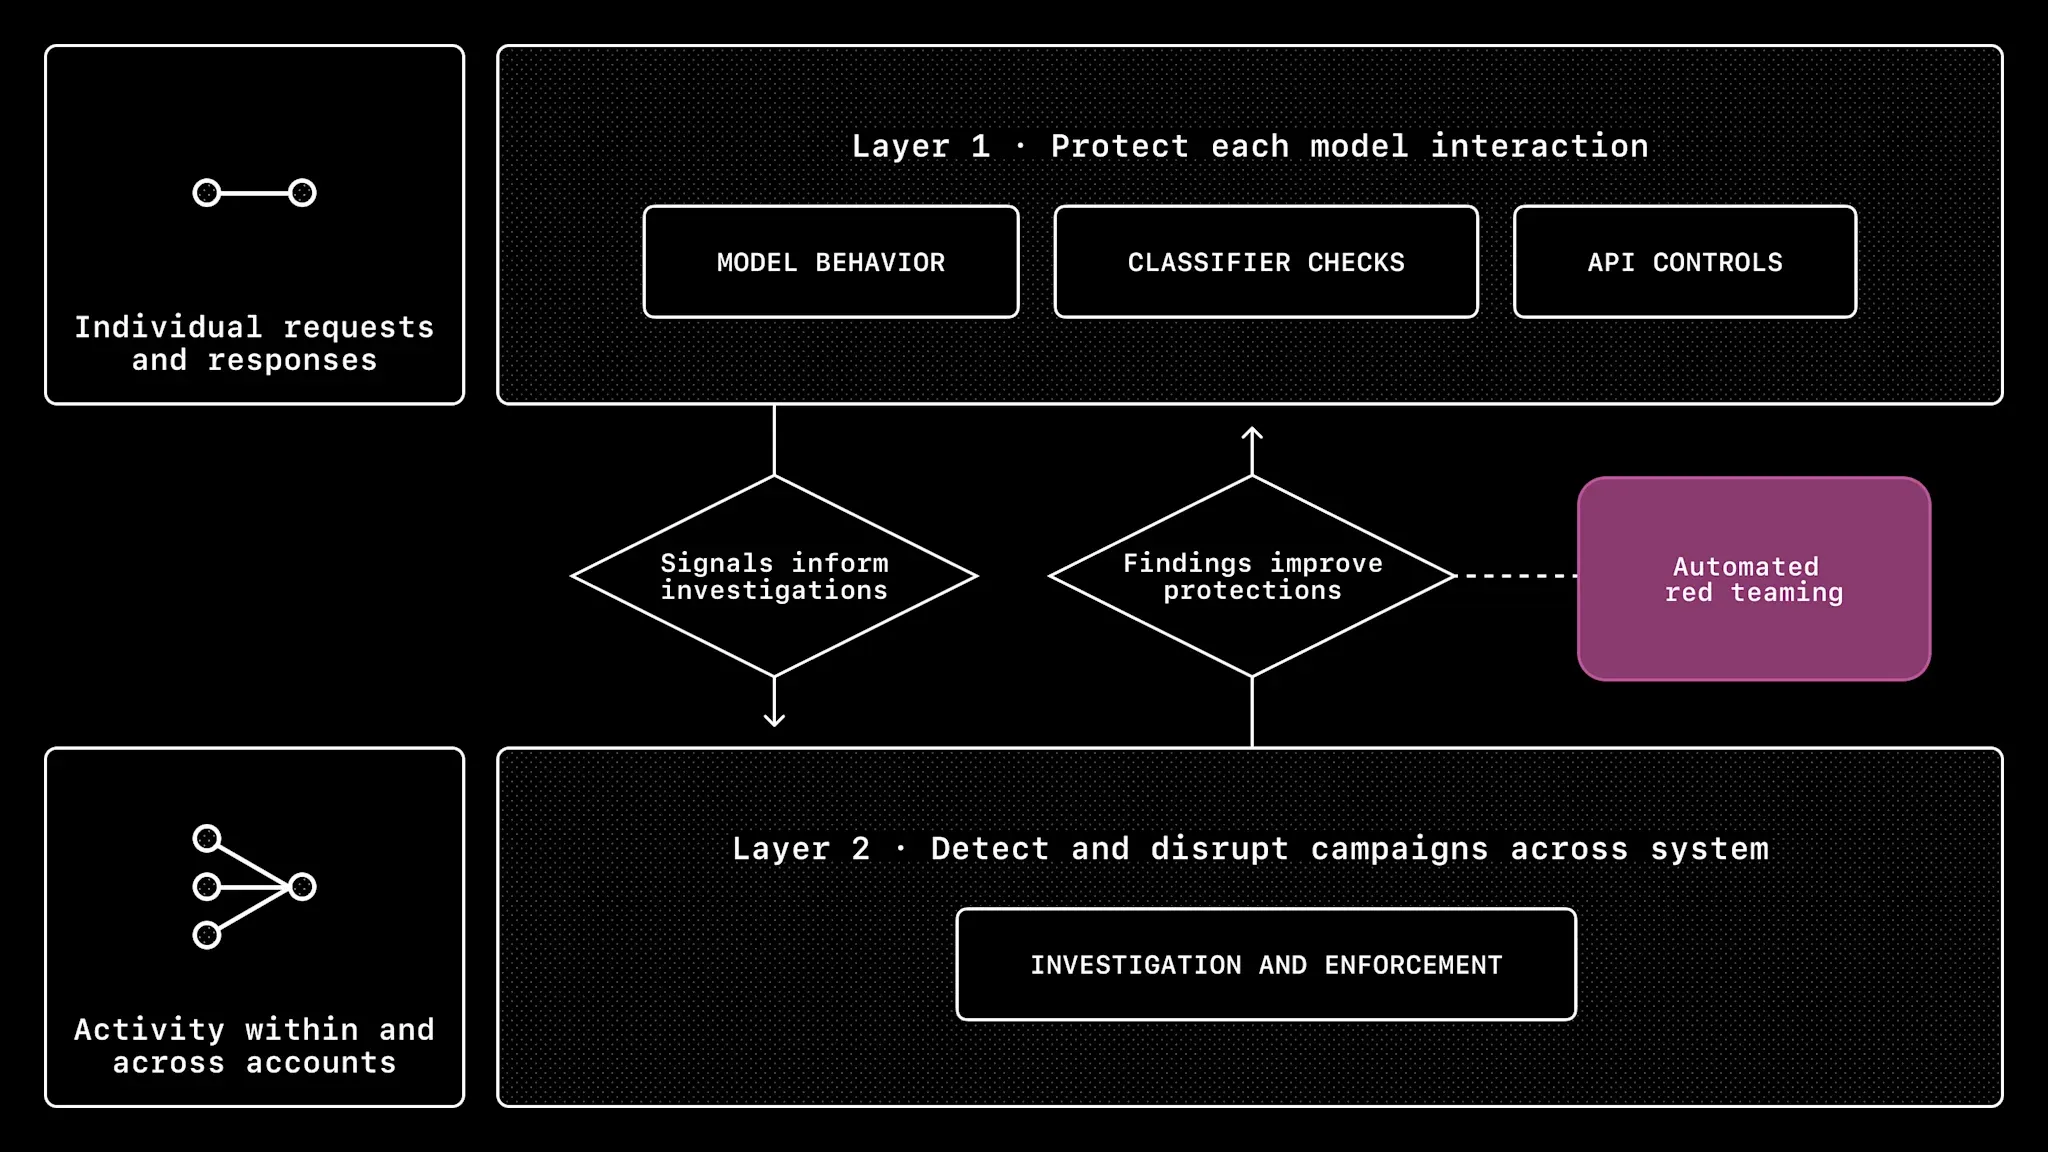
OpenAI усилила защиту от «враждебной дистилляции» — попыток получить ответы и внутренние рассуждения сильной модели, чтобы обучить на них другую. Риск не только в копировании технологии: новая модель может унаследовать полезные способности, но не защитные ограничения исходной.
Под дистилляцией обычно понимают обучение одной модели на данных другой. OpenAI отдельно защищает цепочки рассуждений — промежуточные шаги, которые модель строит до финального ответа. По словам компании, такие следы могут передавать больше навыков, чем краткое объяснение, в том числе в задачах программирования и оборонительной кибербезопасности.
Защита на уровне запроса и кампании
OpenAI описывает несколько слоёв: обучение модели распознавать попытки извлечения рассуждений, входные и выходные классификаторы, а также API-ограничения. Проверки охватывают и аргументы вызова инструментов: именно там скрытая логика могла бы попасть наружу, не появившись в финальном сообщении.
Компания также привязывает защищённые рассуждения GPT‑6.2 Astra и GPT‑6.2 Sol к истории конкретного диалога. При переписывании прежнего сообщения последующая цепочка рассуждений отбрасывается; старым семействам моделей с более слабыми мерами защиты доступ к ней закрыт.
Цифра — пока только от самой компании
Во внутреннем адаптивном тесте OpenAI заявляет, что средняя успешность извлечения рассуждений из предыдущего запроса снизилась с 54% у GPT‑6 Astra со старыми защитами до 0,2% у GPT‑6.2 Astra. Это не независимый аудит, но полезный индикатор направления: защиту теперь оценивают не только по отдельному промпту, а и по способности противостоять меняющимся атакам.
OpenAI сообщает, что расследует координированные кампании и применяет меры к связанным аккаунтам; масштаб еженедельных действий, по её данным, доходил от тысяч до десятков тысяч аккаунтов. Для разработчиков, использующих API, практическое следствие простое: рассчитывать на извлечение скрытой логики модели как на стабильный источник обучающих данных не стоит. Для остальных пользователей это означает меньше шансов получить внутренние рассуждения даже в легитимном запросе — компания выбирает эту границу ради снижения утечек способностей модели. Полное описание мер и методики опубликовано в сообщении OpenAI.