Назад
7 февраля 2026 г. в 00:00 NVIDIA Blackwell NVFP4 AI Hardware Quantization

NVIDIA NVFP4: Как втиснуть интеллект GPT-4o в 4 бита и не сойти с ума
NVIDIA NVFP4: Как втиснуть интеллект GPT-4o в 4 бита и не сойти с ума

NVIDIA представила новый формат квантования NVFP4 и обновленную линейку моделей Nemotron. Спойлер: теперь огромные LLM едят вдвое меньше памяти, а работают быстрее, чем вы успеваете моргнуть.

Что произошло?

Пока индустрия билась над тем, как сжать нейросети без потери их «мозгов», NVIDIA выкатила ультимативное решение — формат NVFP4 (NVIDIA 4-bit Floating Point). Это не просто очередное «обрезание» весов до целых чисел (INT4), а хитрый гибридный формат с плавающей точкой, созданный специально для архитектуры Blackwell.

Главная новость недели: NVIDIA выпустила модель Nemotron-3 Nano-30B в формате NVFP4. Благодаря технологии QAD (Quantization-Aware Distillation) — это когда «умная» полноразмерная модель учит «сжатую» версию — им удалось сохранить точность уровня BF16 при четырехкратном уменьшении объема.

Техническая магия: почему это не INT4?

Главная проблема обычного 4-битного квантования — потеря точности на «выбросах» (outliers). NVFP4 решает это через двухслойное масштабирование:

  1. Микроблоки по 16 значений: каждое из них получает свой масштабный коэффициент в формате FP8.
  2. Глобальный скаляр FP32: накладывается сверху на весь тензор.

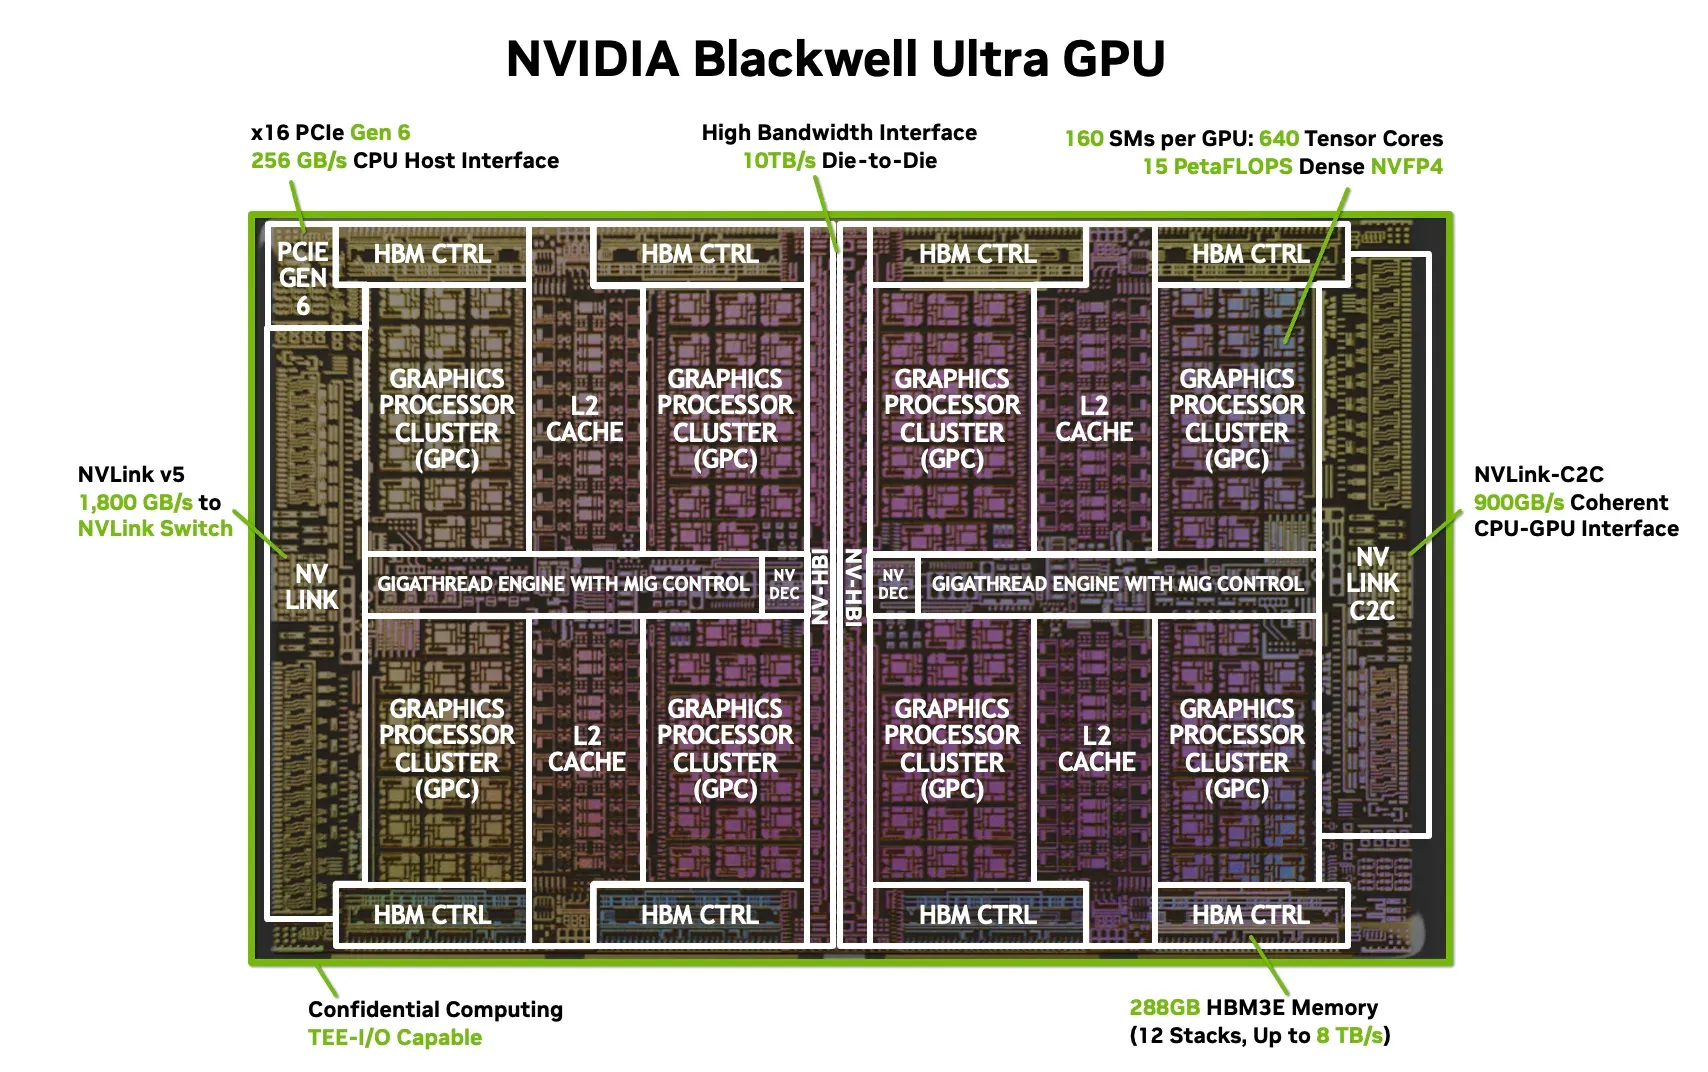
Результат? Память экономится в 3.5 раза по сравнению с FP16 и в 1.8 раза по сравнению с уже привычным FP8. На чипах Blackwell (B200/GB200) это дает безумный прирост пропускной способности — до 15 петафлопс на одну систему.

Почему это важно?

  1. Смерть «мемори-лимита»: Теперь модели уровня Llama 3.1 70B или свежие Nemotron 70B, которые раньше требовали целую стойку серверов, можно запускать на значительно меньшем количестве GPU. Модель Llama-3.1-Nemotron-70B-Instruct уже возглавила чарты Arena Hard (85 баллов против 79 у GPT-4o), а с NVFP4 она становится еще и экономически выгодной.
  2. Экосистема готова: Поддержка NVFP4 уже «завезена» в TensorRT-LLM, vLLM и SGLang. Это значит, что разработчикам не нужно ждать годами — оптимизированные чекпоинты моделей вроде DeepSeek-R1, Flux.2 и Nemotron уже лежат на Hugging Face.
  3. Локальный запуск: NVIDIA намекает, что с выходом потребительских карт серии RTX 50 (Blackwell), запуск моделей на 30-70 млрд параметров дома станет реальностью, а не мучением с 2 токенами в секунду.
Мнение редакции Neuro.ee — Давайте будем честны: NVIDIA в очередной раз подтвердила статус монополиста, который сам создает проблему (гигантские модели) и сам же продает элегантное решение (Blackwell + NVFP4). Переход на 4 бита с плавающей точкой — это «серебряная пуля» для инференса. Если раньше квантование было компромиссом для бедных, то с NVFP4 оно становится стандартом для богатых и умных. Мы прогнозируем, что к концу 2026 года формат FP16 в продакшене станет таким же архаизмом, как сейчас дискеты.


Источники

Ещё новости

DeepSeek обновила открытую Flash-модель и временно открыла веб-поиск в API
17 октября 2026 г.
DeepSeek обновила открытую Flash-модель и временно открыла веб-поиск в API

DeepSeek выпустила V4.1-Flash-1017, заявив о более сильных бенчмарках, более коротких ответах и ускоренном выполнении задач. Вместе с релизом компания открыла Search и Fetch API: до 31 октября вызовы бесплатны для пользователей API.

Gemini 4 Argon появился в GitHub Copilot: доступ уже открыт для платных планов
17 октября 2026 г.
Gemini 4 Argon появился в GitHub Copilot: доступ уже открыт для платных планов

GitHub добавил Gemini 4 Argon в Copilot для пользователей Pro+, Max, Business и Enterprise. Модель можно выбрать в Copilot Chat, CLI, VS Code, Visual Studio и на GitHub.com — если доступ не ограничен политикой организации.

NVIDIA выпустила открытую модель Nemotron 3.5 Super VL для ИИ-агентов
17 октября 2026 г.
NVIDIA выпустила открытую модель Nemotron 3.5 Super VL для ИИ-агентов

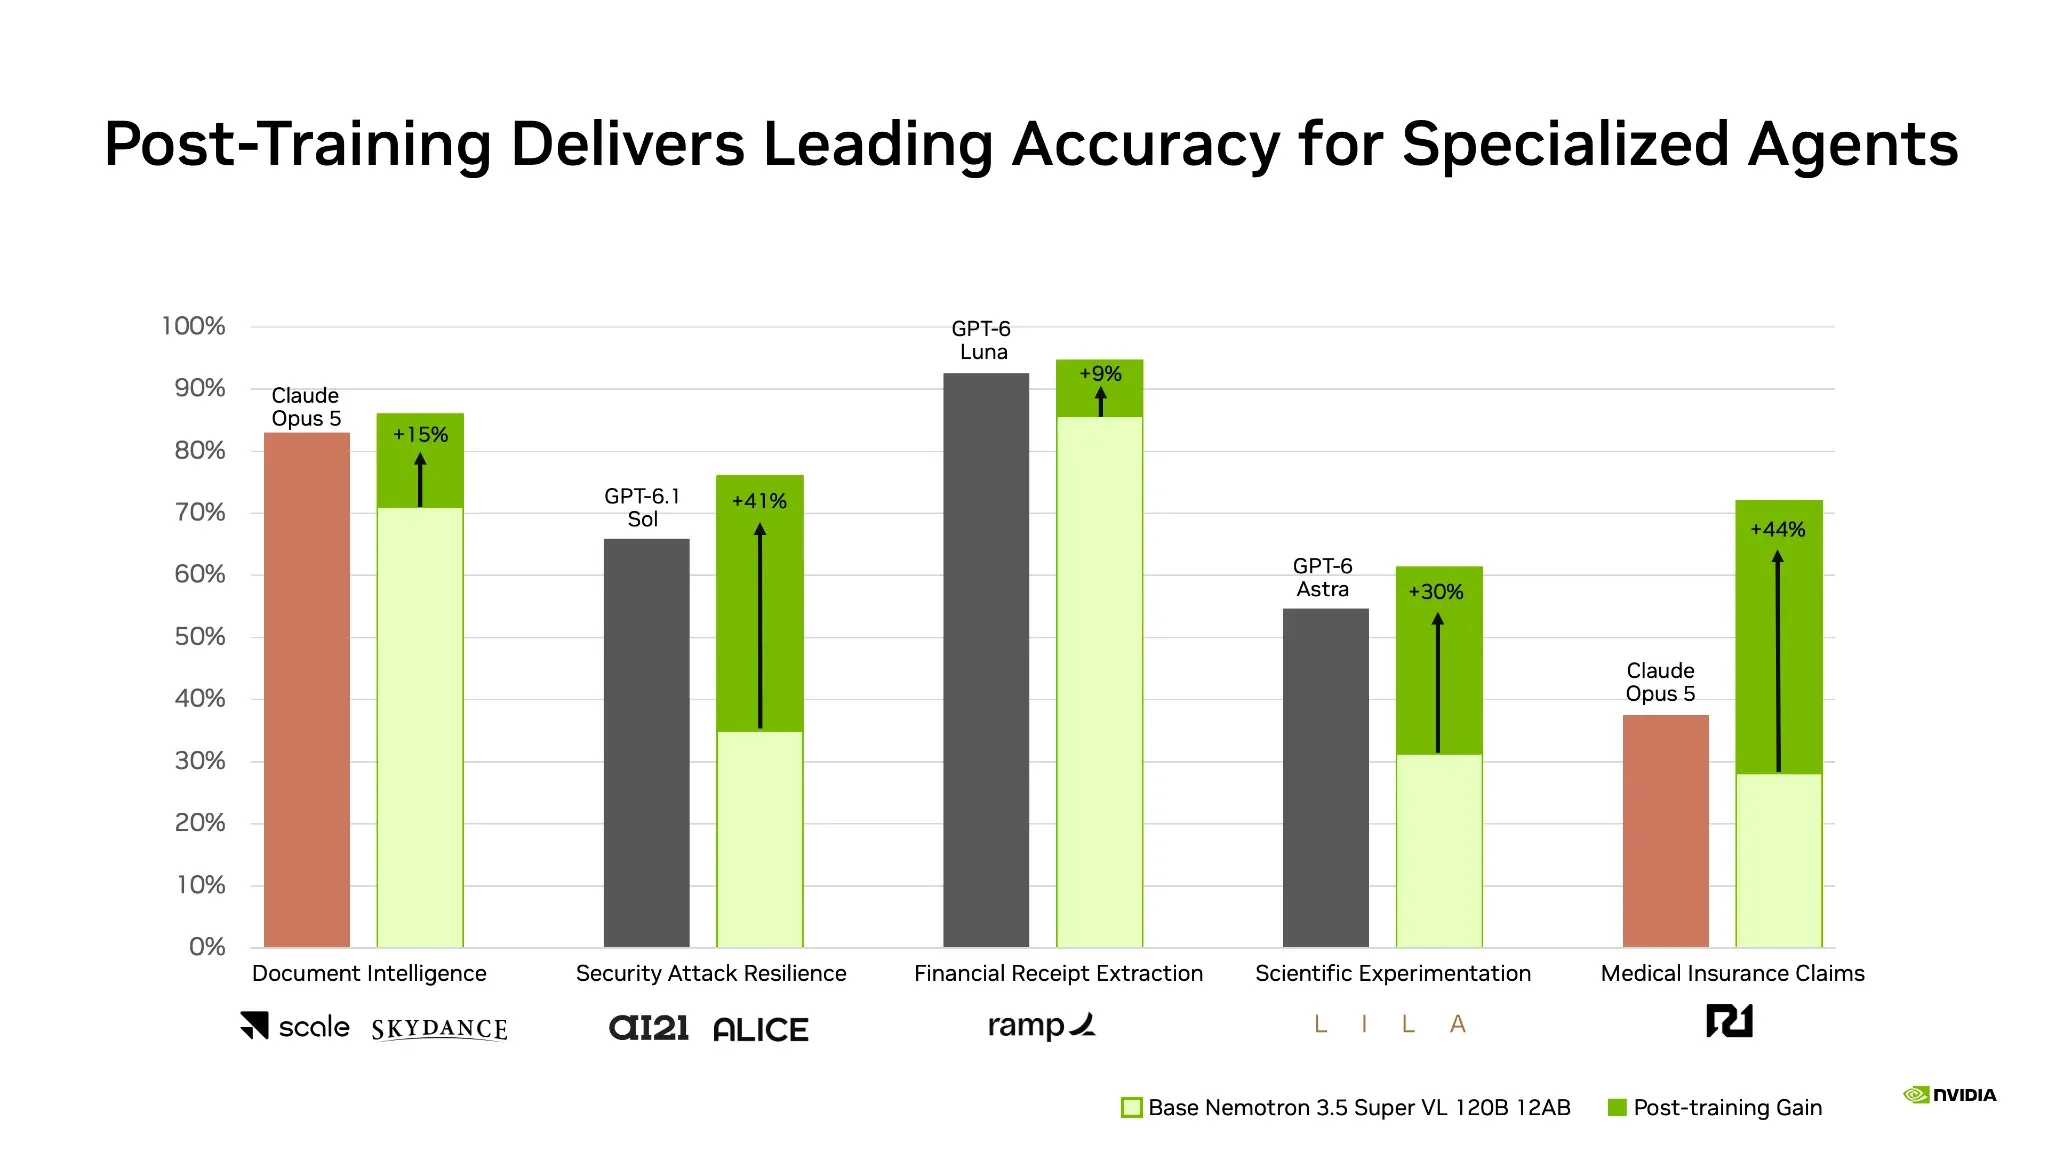
NVIDIA представила открытую мультимодальную модель Nemotron 3.5 Super VL. Она объединяет работу с текстом, документами, изображениями и видео для специализированных ИИ-агентов.

NVIDIA выпустила ноутбуки RTX Spark с 128 ГБ общей памяти
16 октября 2026 г.
NVIDIA выпустила ноутбуки RTX Spark с 128 ГБ общей памяти

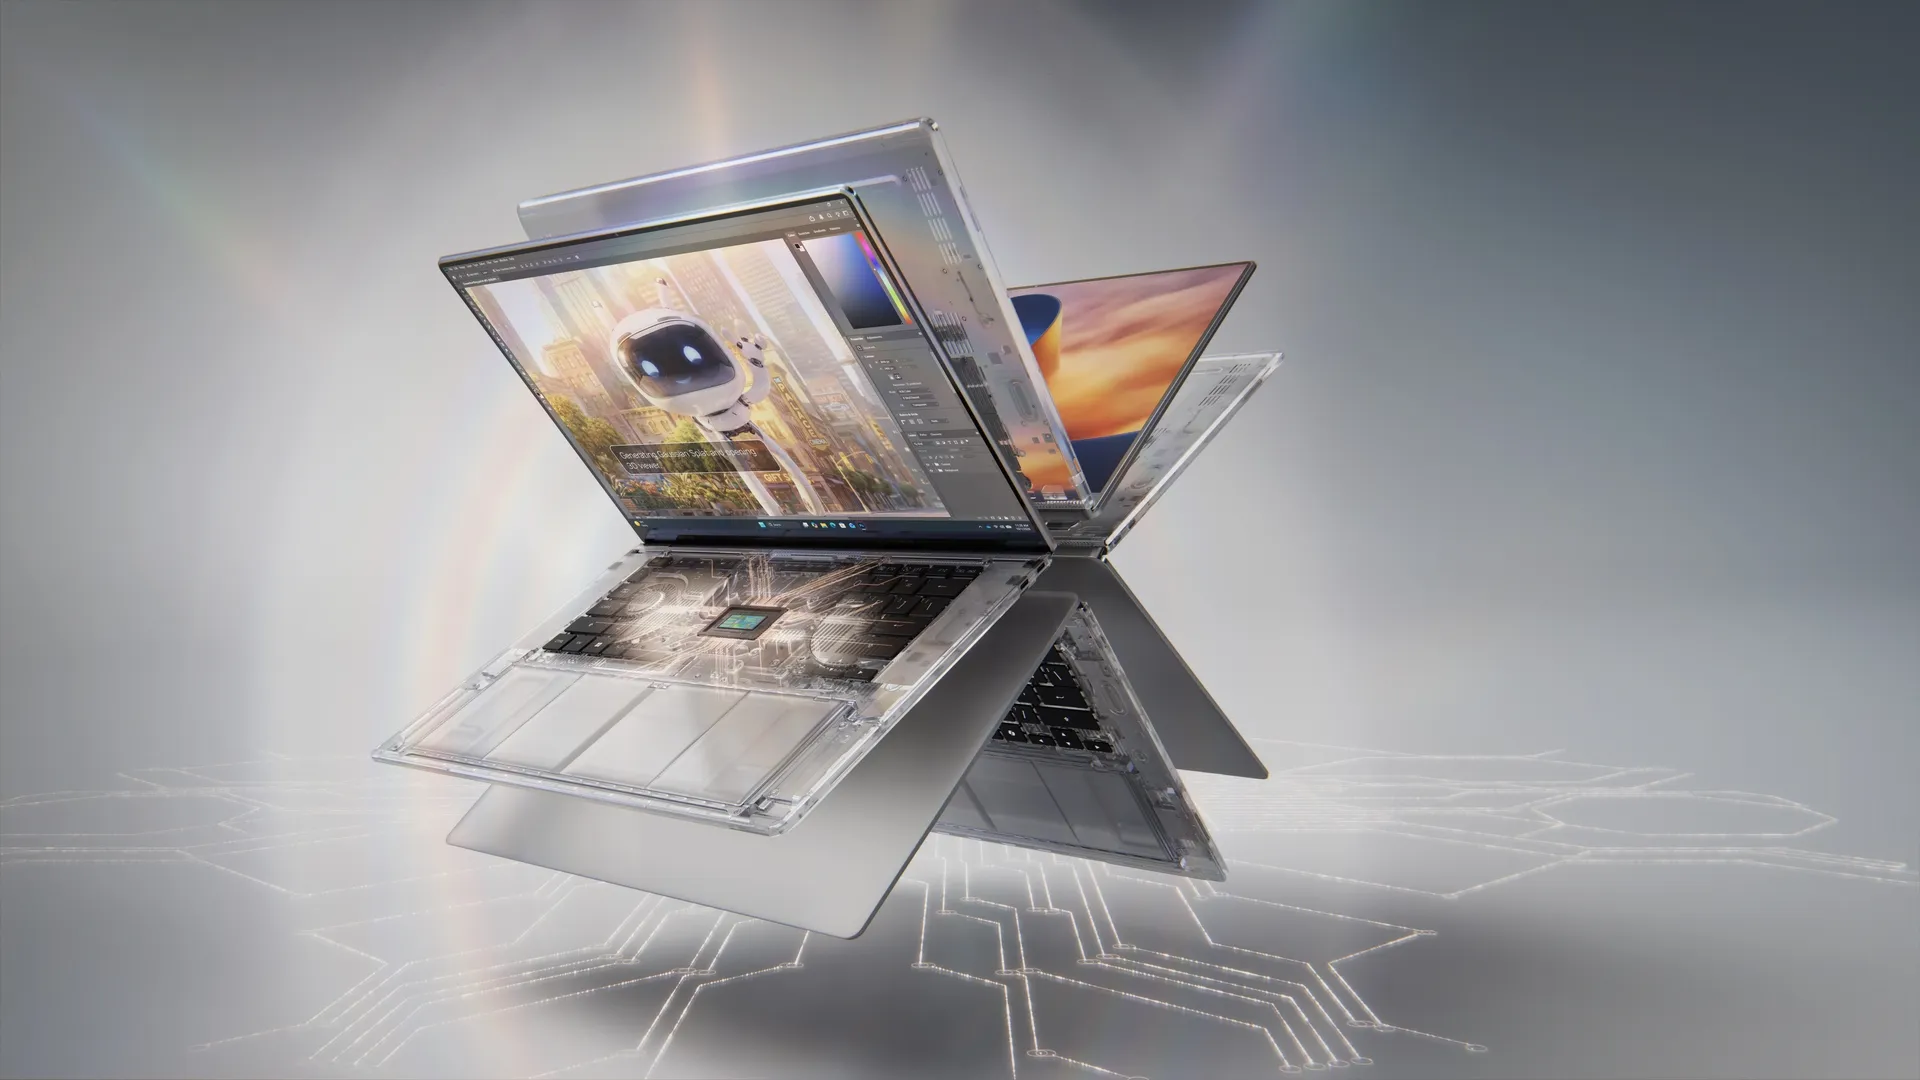
NVIDIA объявила о старте продаж ноутбуков RTX Spark. Платформа обещает запускать крупные языковые модели и ИИ-агентов на самом устройстве, а не только через облако.

Microsoft обучила базовую модель на 2,8 трлн параметров — но пока не отдаёт её пользователям
16 октября 2026 г.
Microsoft обучила базовую модель на 2,8 трлн параметров — но пока не отдаёт её пользователям

Microsoft AI завершила предобучение MAI-Base-2 — модели Mixture-of-Experts с 80 млрд активных и 2,8 трлн общих параметров. Компания заявляет о более высокой эффективности обучения по сравнению с DeepSeek-V4-Pro-Base, но сама модель ещё проходит постобучение и недоступна.

Anthropic пустила независимых оценщиков глубже в свои системы
16 октября 2026 г.
Anthropic пустила независимых оценщиков глубже в свои системы

Anthropic начала давать команде некоммерческой организации METR доступ, близкий к доступу сотрудников, чтобы та могла оценивать риски передовых моделей и практики безопасности. Компания также описала три уровня доступа для внешних оценщиков — от узких проверок до возможности публиковать выводы без предварительного согласования.

Meta открыла веса Muse Spark Open, но запустить модель дома будет непросто
15 октября 2026 г.
Meta открыла веса Muse Spark Open, но запустить модель дома будет непросто

Meta выпустила открытые веса Muse Spark Open — мультимодальной модели для кода и агентных задач. Релиз даёт разработчикам больше контроля над запуском и дообучением, но требует очень мощного железа и распространяется по лицензии с коммерческими условиями.

Meta признала сбой: очки Ray-Ban записывали разговоры без команды
15 октября 2026 г.
Meta признала сбой: очки Ray-Ban записывали разговоры без команды

Владельцы Ray-Ban Meta сообщили о сохранённых аудиозаписях и расшифровках обычных разговоров, хотя голосовая команда не звучала. Meta заявила, что устранила проблему, но не объяснила её причину и масштаб.

Anthropic готовит Claude к выборам: официальные данные и новые фильтры
15 октября 2026 г.
Anthropic готовит Claude к выборам: официальные данные и новые фильтры

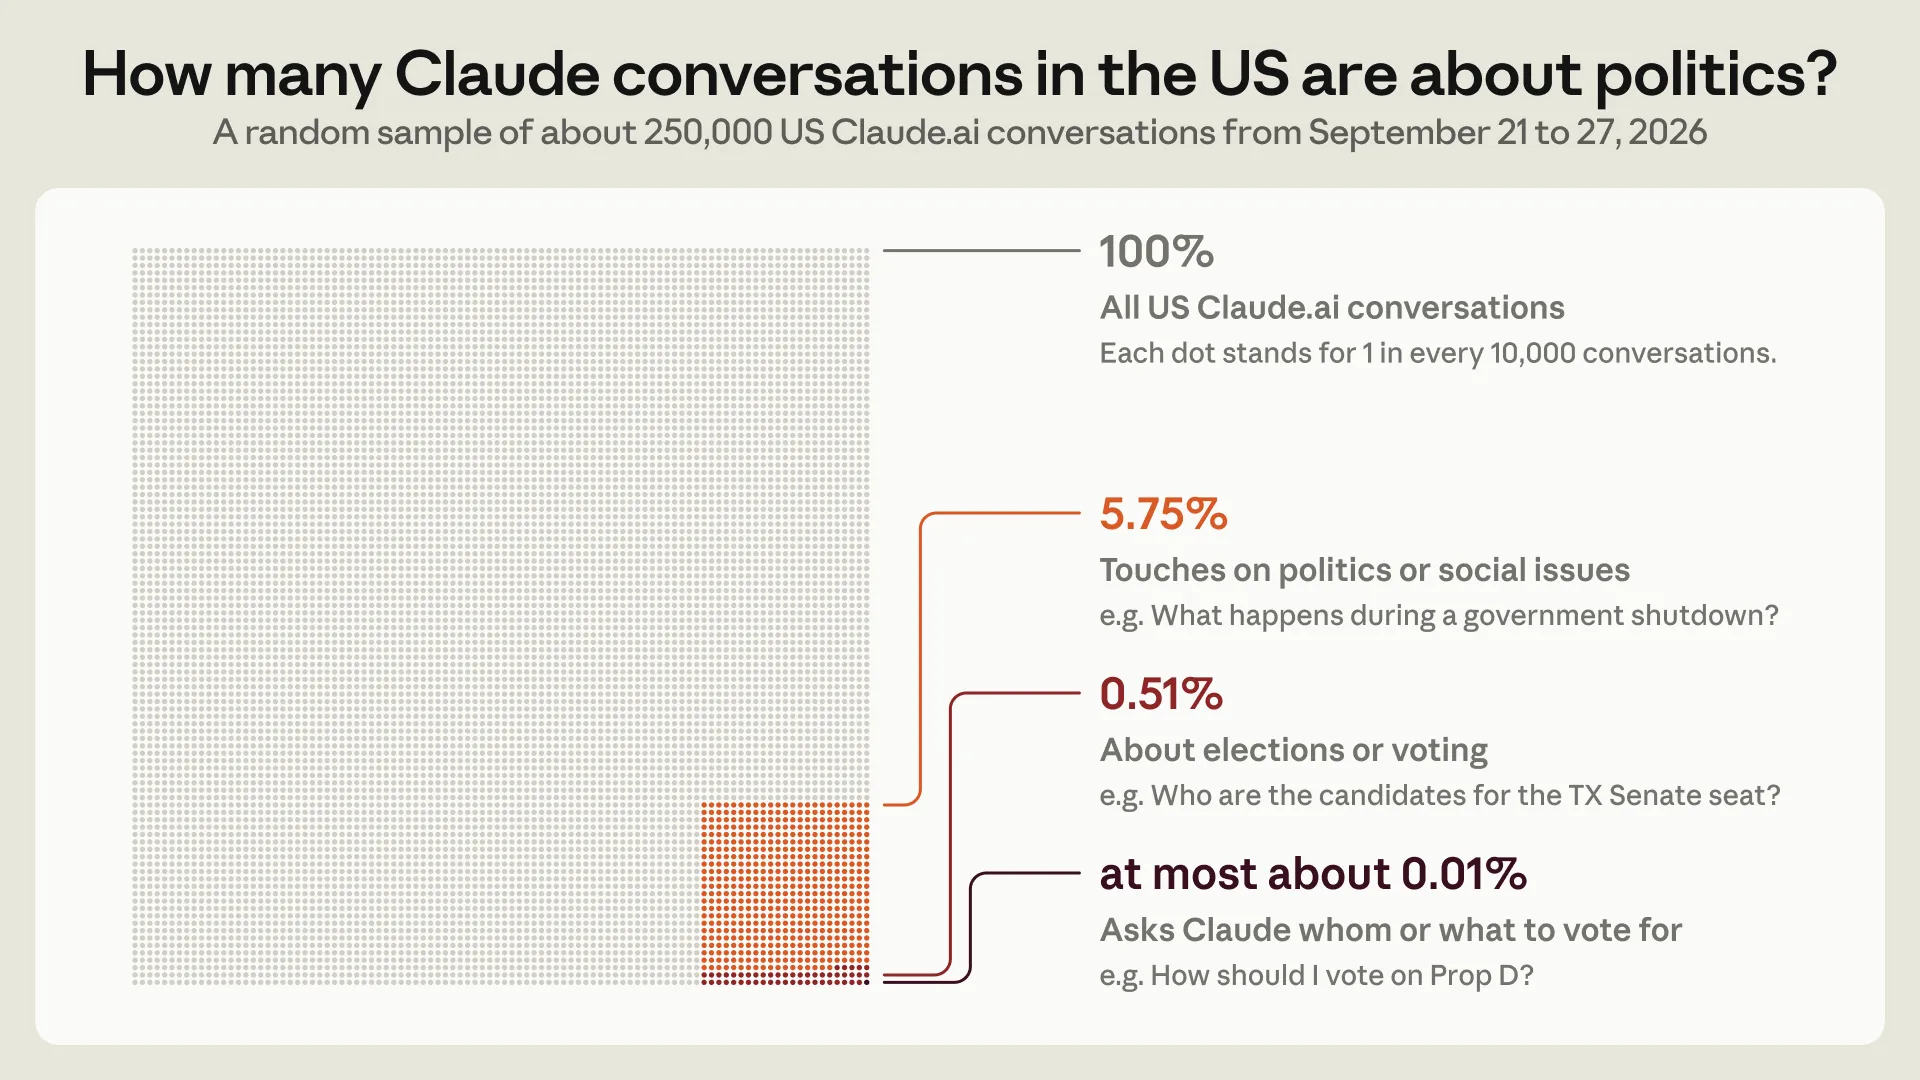
Anthropic добавит в Claude для пользователей США официальную информацию о голосовании и результаты выборов. Компания также признаёт ограничение своих защит: вредоносную кампанию, разбитую на безобидные шаги, модель может не распознать.

Anthropic: малые модели уже подбираются к самораспространению по IoT
15 октября 2026 г.
Anthropic: малые модели уже подбираются к самораспространению по IoT

Anthropic проверила, смогут ли небольшие модели развернуть себя на чужом слабом железе и продолжить цепочку. В лабораторной среде более сильные модели уже прошли упрощённый цикл, но реальный взлом устройств в эксперимент не входил.

FSB выпустил 12 правил для банков, внедряющих ИИ
15 октября 2026 г.
FSB выпустил 12 правил для банков, внедряющих ИИ

Совет по финансовой стабильности опубликовал финальные практики для банков и других финансовых организаций, использующих ИИ. Документ не вводит новый закон, но превращает управление ИИ из эксперимента отдельных команд в задачу руководства, контроля поставщиков и мониторинга всего жизненного цикла.

Google выпустила Gemini 4 Argon: миллион токенов и цена, которая удвоится в декабре
14 октября 2026 г.
Google выпустила Gemini 4 Argon: миллион токенов и цена, которая удвоится в декабре

Google открыла доступ к Gemini 4 Argon через API, Gemini и Antigravity. В стартовый период модель стоит $2 за миллион входных токенов, но 30 ноября цена вырастет вдвое.