Microsoft представила чип Maia 300 для ИИ-инференса
Microsoft показала Azure Maia 300 — третье поколение собственных ускорителей для ИИ-инференса. Главная цифра в анонсе: в конфигурации из 96 ускорителей на стойку компания обещает до семи раз больше токенов в секунду, чем у Maia 200. Это не чип для обучения моделей, а попытка удешевить ту часть ИИ, за которую пользователи платят ежедневно: ответы, длинные диалоги и вызовы инструментов.
Не просто «ещё один GPU»
Maia 300 Microsoft проектировала под нагрузку, в которой модель не выдаёт один короткий ответ, а держит длинный контекст, рассуждает в несколько шагов и обращается к инструментам. Поэтому компания делает ставку не только на вычисления, но и на перемещение данных: архитектура разделяет вычислительные чиплеты, память и ввод-вывод, а ПО управляет тем, где именно хранится состояние модели.
На один ускоритель заявлены 288 ГБ памяти HBM4 и 18 ТБ/с пропускной способности. По сравнению с Maia 200 Microsoft указывает 2,5-кратный рост пропускной способности памяти, на 33% больше её объёма и примерно двукратный прирост пропускной способности на ватт. Эти показатели — заявления производителя, а не независимый тест, но они объясняют, почему именно память становится центром новой конструкции.
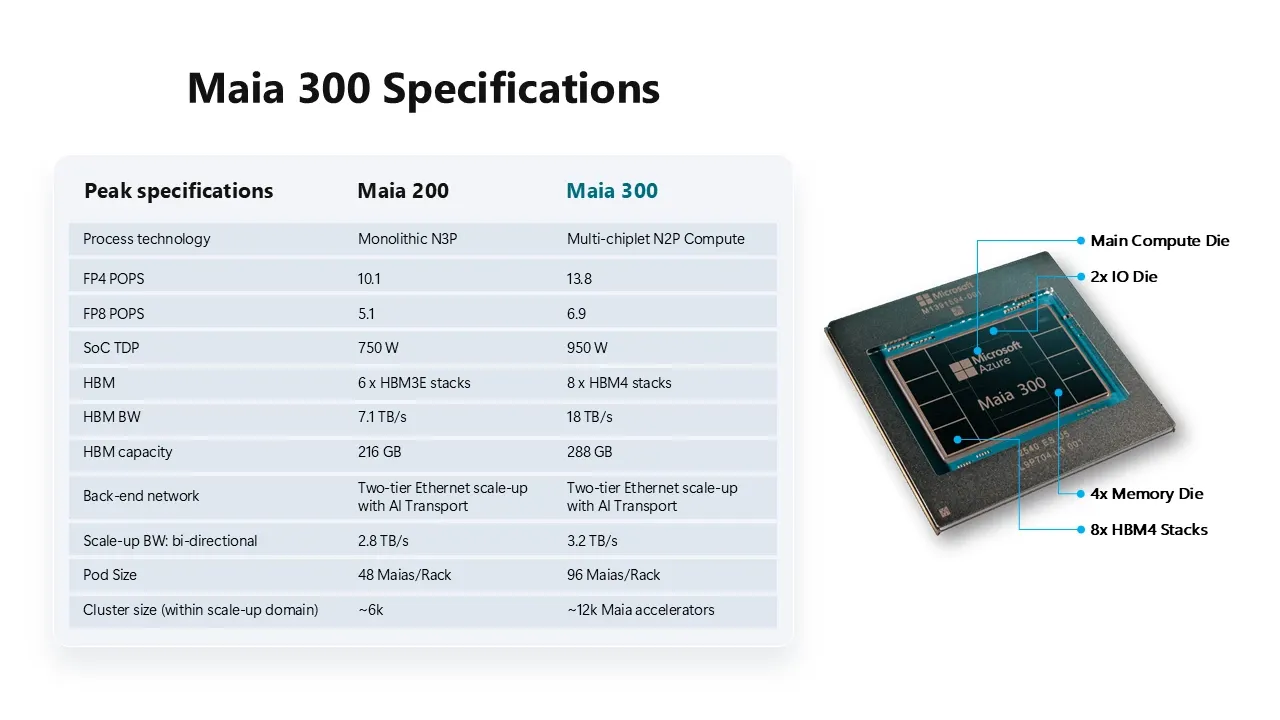
График: Microsoft Azure.
Стойка как единый компьютер
В стойке Maia 300 размещаются 96 ускорителей в 24 модулях; Microsoft оценивает её энергопотребление в 167 кВт. Для таких систем важны не только кремний и память: компания описывает жидкостное охлаждение, сеть и телеметрию как части одного продукта. Это отличается от привычного сценария, где дата-центр собирают из относительно самостоятельных серверов.
Практический вывод для пользователей Copilot, GitHub Copilot и Azure Foundry пока косвенный: Microsoft не обещала отдельную функцию Maia 300 в конкретную дату. Но собственный инференсный стек даёт ей больше контроля над себестоимостью и доступной мощностью. Если заявленная эффективность подтвердится в эксплуатации, конкуренция за ИИ-сервисы будет всё сильнее зависеть не только от качества модели, но и от того, кто способен дешевле обслужить длинный агентный запрос.
Полное техническое описание и исходные цифры опубликованы в блоге Azure.