Назад
18 мая 2026 г. в 09:00 AI Cybersecurity Linux Open Source Software Development The Register; Linux Kernel Documentation; Linuxiac; Techmeme; Wikimedia Commons

Линус Торвальдс устал от AI-багрепортов: Linux меняет правила для охотников за уязвимостями
Линус Торвальдс устал от AI-багрепортов: Linux меняет правила для охотников за уязвимостями

Линус Торвальдс устал от AI-багрепортов: Linux меняет правила для охотников за уязвимостями

Линус Торвальдс резко описал новую проблему для разработчиков Linux: AI-инструменты помогают находить баги, но одновременно заваливают закрытый security-list повторными и плохо подготовленными отчётами. В еженедельном сообщении о Linux 7.1-rc4 он написал, что поток AI reports сделал список «почти полностью неуправляемым»: разные люди запускают похожие инструменты, находят одни и те же проблемы и отправляют их туда, где другие исследователи не видят уже поданные отчёты.

Смысл претензии не в том, что AI бесполезен. Наоборот, Торвальдс прямо говорит: «AI tools are great» — но только если они действительно помогают, а не создают лишнюю боль и имитацию работы. Его главный совет прост: если модель нашла баг, не отправляйте случайный отчёт без понимания. Проверьте его, прочитайте правила, подготовьте патч и добавьте ценность поверх того, что сделал инструмент.

Что меняет Linux

Новая документация ядра уточняет, какие ошибки вообще стоит считать security bugs. Закрытый security-list нужен для срочных, легко эксплуатируемых уязвимостей, которые дают атакующему новые возможности в корректно настроенной production-системе и угрожают многим пользователям. Большая часть остальных проблем должна обсуждаться публично: так шире круг ревью, быстрее находится правильный maintainer и меньше риск, что один и тот же баг будут тайно пересылать десятки раз.

Отдельный пункт касается AI-assisted reports. Документация kernel.org говорит: если баг найден с помощью AI, его обычно надо считать публичным, потому что такие находки систематически всплывают одновременно у нескольких исследователей, иногда в один день. При этом эксплойт не надо выкладывать открыто: достаточно сообщить, что воспроизведение есть, и передать детали maintainer’ам приватно по запросу.

Почему это больше, чем спор разработчиков

История важна шире Linux, потому что показывает новую цену автоматизации безопасности. Раньше узким местом был поиск ошибок. Теперь AI снижает порог входа: больше людей может прогнать код через анализатор, получить подозрительное место и назвать это уязвимостью. Но узкое место смещается в проверку: нужно понять версию ядра, условия воспроизведения, реальное влияние, границу доверия и путь исправления.

Если этой работы нет, безопасность не ускоряется. Она превращается в очередь из одинаковых писем, где maintainer’ы тратят время не на патчи, а на маршрутизацию, объяснение, что баг уже исправлен, и отделение реальных рисков от шума. Для open source это особенно болезненно: внимание опытных людей — самый дефицитный ресурс проекта.

Урок для компаний

Та же проблема будет появляться в bug bounty, внутренних red team-процессах и корпоративных сканерах кода. AI может находить больше потенциальных дыр, но отчёт без воспроизводимости и владельца исправления — это не защита, а долг в очереди triage.

Практический вывод для команд простой: покупка AI-инструмента для поиска уязвимостей не заменяет процесс. Нужны правила, какие баги считать срочными, кто проверяет результат, где хранится reproducer, как быстро назначается maintainer и когда отчёт отправляется в публичный или приватный канал. Linux сейчас формулирует это жёстко, потому что живёт на переднем крае проблемы: автоматический поиск стал массовым быстрее, чем культура ответственной подачи отчётов.

Ещё новости

AWS добавила в Textract ИИ-проверку полей по страницам документа
21 ноября 2026 г.
AWS добавила в Textract ИИ-проверку полей по страницам документа

Amazon Textract Insights извлекает поля из смешанных пакетов документов и возвращает для каждого значения оценку уверенности и привязку к странице. AWS позиционирует сервис как способ автоматизировать обработку без отказа от проверки человеком.

Математик Anthropic заявил о доказательстве гипотезы Римана с Claude
20 ноября 2026 г.
Математик Anthropic заявил о доказательстве гипотезы Римана с Claude

Математик Anthropic Левент Альпёге заявил, что вместе с Claude получил формальное доказательство гипотезы Римана и её обобщения. Код на Lean уже скомпилировался у независимого математика, но математическому сообществу ещё предстоит разобрать и подтвердить сам результат.

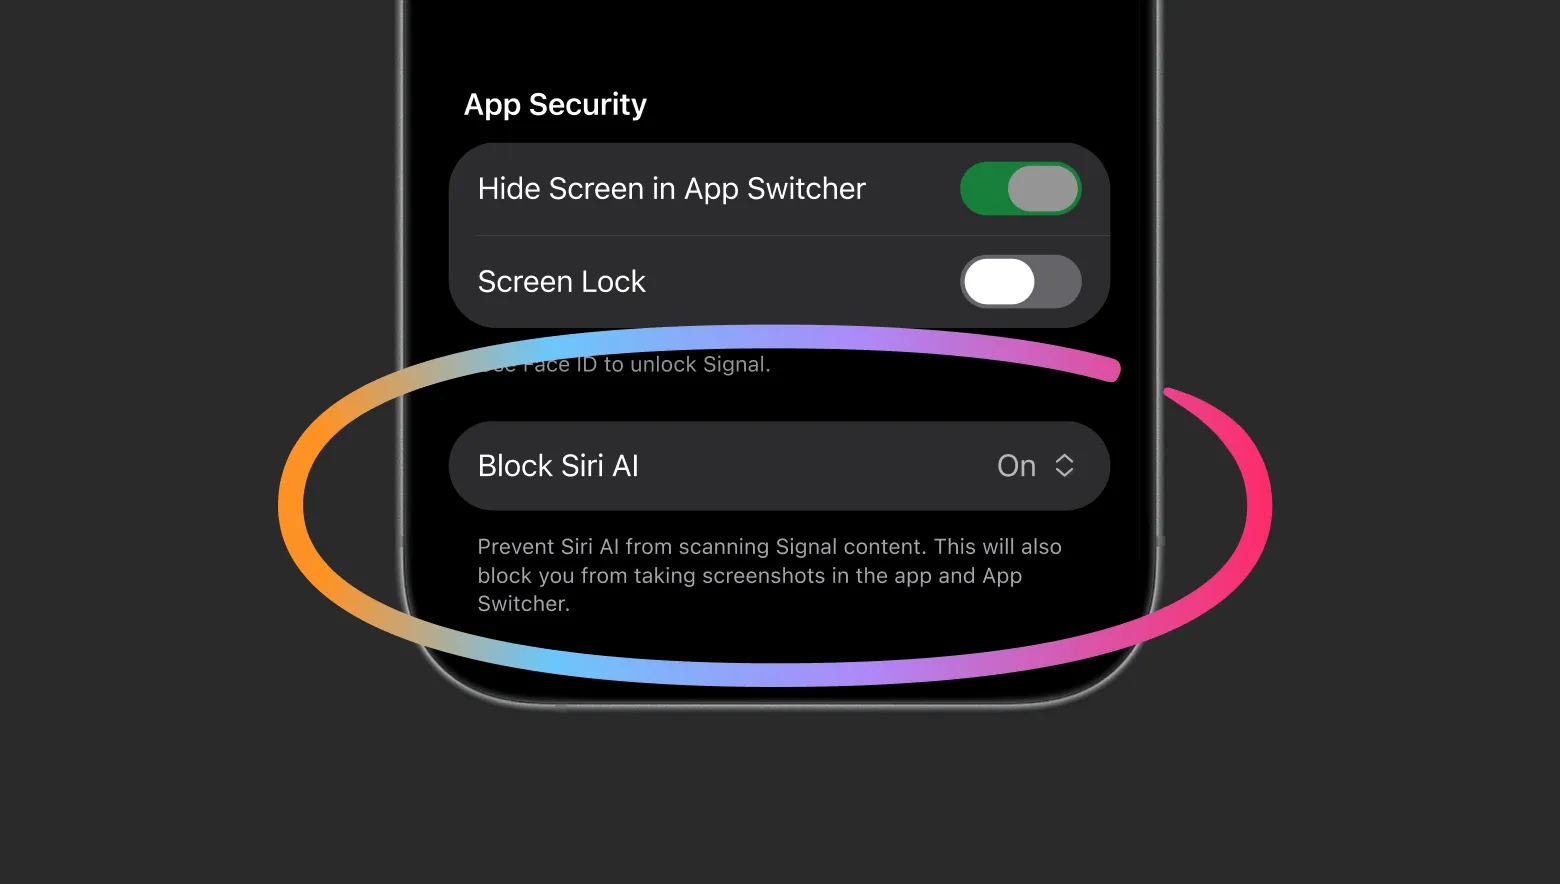
Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты
20 ноября 2026 г.
Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты

Signal вводит защиту от захвата экрана на iOS 27 и при обнаружении ИИ-помощника на Android. Мессенджер предупреждает: мера не закрывает все пути доступа и на macOS пока не работает.

В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты
20 ноября 2026 г.
В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты

В отчёте Reco описан инцидент с восемью захваченными аккаунтами Microsoft 365: после кражи сессии злоумышленники быстро меняли правила почты. Компания не утверждает, что атаку выполнил ИИ — и это важная граница для интерпретации.

DeepMind описал четыре пути от AGI к сверхинтеллекту
20 ноября 2026 г.
DeepMind описал четыре пути от AGI к сверхинтеллекту

Исследователь Google DeepMind Тим Генвейн предлагает смотреть на переход от человеческого уровня ИИ к сверхинтеллекту как на набор проверяемых технических сценариев. Это не прогноз сроков, а карта возможных ускорителей и ограничений.

Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены
19 ноября 2026 г.
Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены

Google представила Gemini 4 Neon — модель для сложных задач в коде, офисной работе и науке. Компания заявляет качество уровня Gemini 4 Carbon при трёхкратной скорости и 60% стоимости; проверять это стоит на собственных задачах.

GitHub открыла протокол для сессий AI-агентов между устройствами
19 ноября 2026 г.
GitHub открыла протокол для сессий AI-агентов между устройствами

GitHub описала открытый Agent Host Protocol: он сохраняет состояние AI-агента при переходе между VS Code, Copilot, телефоном и облаком. Это не новый агент, а общий способ подключать клиентов к уже работающей сессии.

Google представила Stitch Loop для непрерывной доработки приложений
19 ноября 2026 г.
Google представила Stitch Loop для непрерывной доработки приложений

Google Labs открыла лист ожидания Stitch Loop — агента, который подключается к коду и рабочим метрикам, находит проблемы и готовит pull request’ы. Сливать изменения без проверки человека сервис не должен.

GitHub отсеял 9 791 AI-находку до 99 отчётов для open source
18 ноября 2026 г.
GitHub отсеял 9 791 AI-находку до 99 отчётов для open source

В пилоте GitHub и Microsoft превратили тысячи сигналов AI-сканера в 99 проверенных закрытых отчётов для шести open-source-проектов. К 15 ноября мейнтейнеры исправили 55 из них — но это ранний опыт, а не доказательство универсальной эффективности сканеров.

OpenAI пустит четыре внешние команды внутрь своих систем безопасности
18 ноября 2026 г.
OpenAI пустит четыре внешние команды внутрь своих систем безопасности

OpenAI запускает первую фазу встроенных независимых оценок: Apollo Research, METR, Transluce и Goodfire получат доступ к части внутренних моделей, данных и процессов. Формат обещает больше прозрачности, но независимость публикаций ограничена правом компании скрывать конфиденциальные детали.

Microsoft выпустила MAI Code 2 для GitHub Copilot и Foundry
18 ноября 2026 г.
Microsoft выпустила MAI Code 2 для GitHub Copilot и Foundry

Microsoft представила MAI Code 2 и более быструю MAI Code 2 Flash — собственные модели для повседневной работы с кодом. Основная версия уже доступна в GitHub Copilot и Azure AI Foundry, а Flash в Foundry пока остаётся в ограниченном предпросмотре.

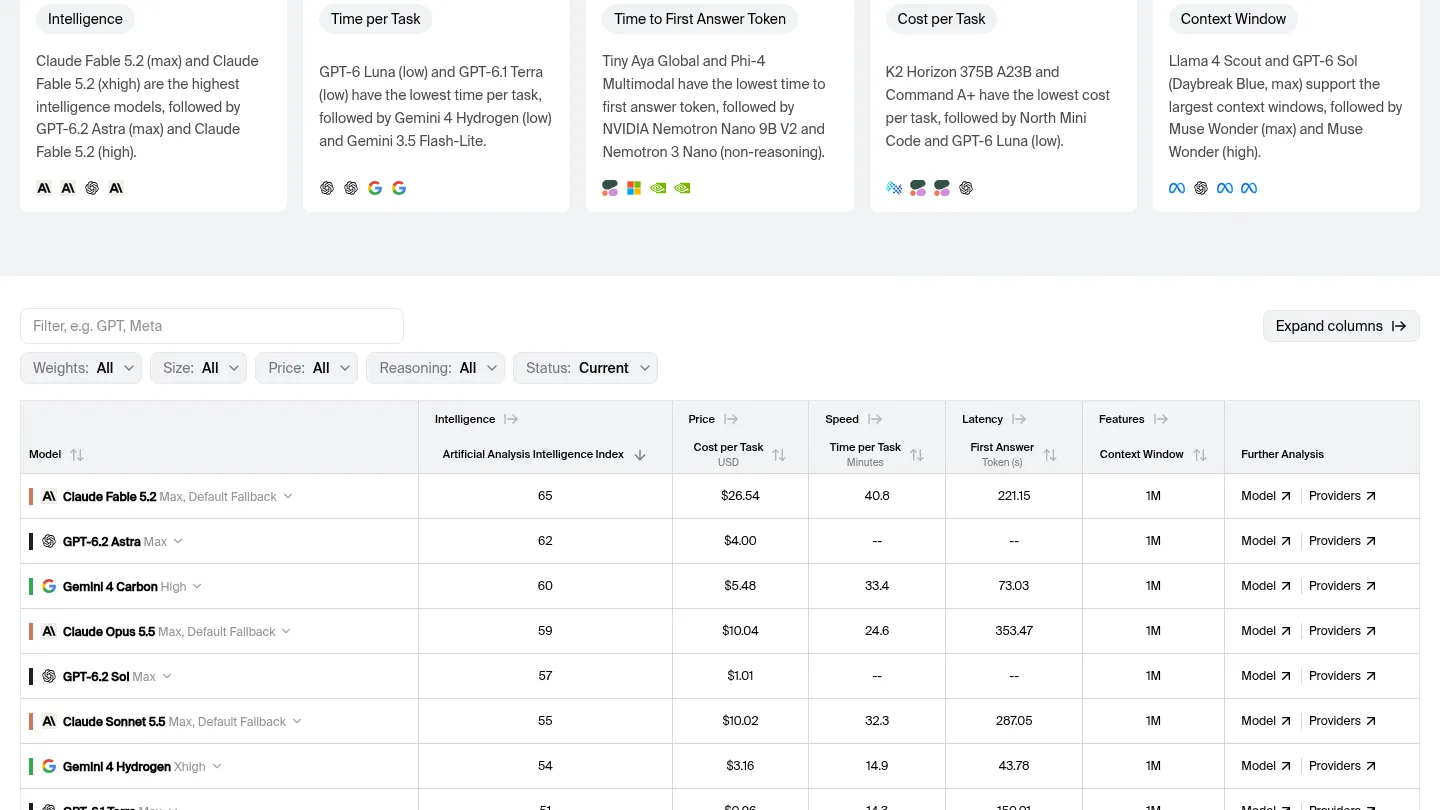
GPT‑6.2 Astra прибавила пять пунктов, но лидером рейтинга остаётся Claude
17 ноября 2026 г.
GPT‑6.2 Astra прибавила пять пунктов, но лидером рейтинга остаётся Claude

В независимом сводном рейтинге Artificial Analysis GPT‑6.2 Astra получила 62 из 100 — на пять пунктов больше, чем GPT‑6 Astra. Это заметный скачок OpenAI, но первое место остаётся у Claude Fable 5.2 Max с 65 баллами; Sol выросла с 55 до 57.