Mercury 3 обещает 1 068 токенов в секунду — и цену ниже $1 за миллион
Inception представила Mercury 3 — диффузионную языковую модель, которая, по данным разработчика, выдаёт 1 068 токенов в секунду на GPU NVIDIA. Для сравнения, обычная LLM формирует текст последовательно, токен за токеном; диффузионная модель уточняет несколько токенов параллельно. Выигрыш здесь не в красивой цифре на слайде, а в сценариях, где пользователь ждёт ответ прямо в интерфейсе.
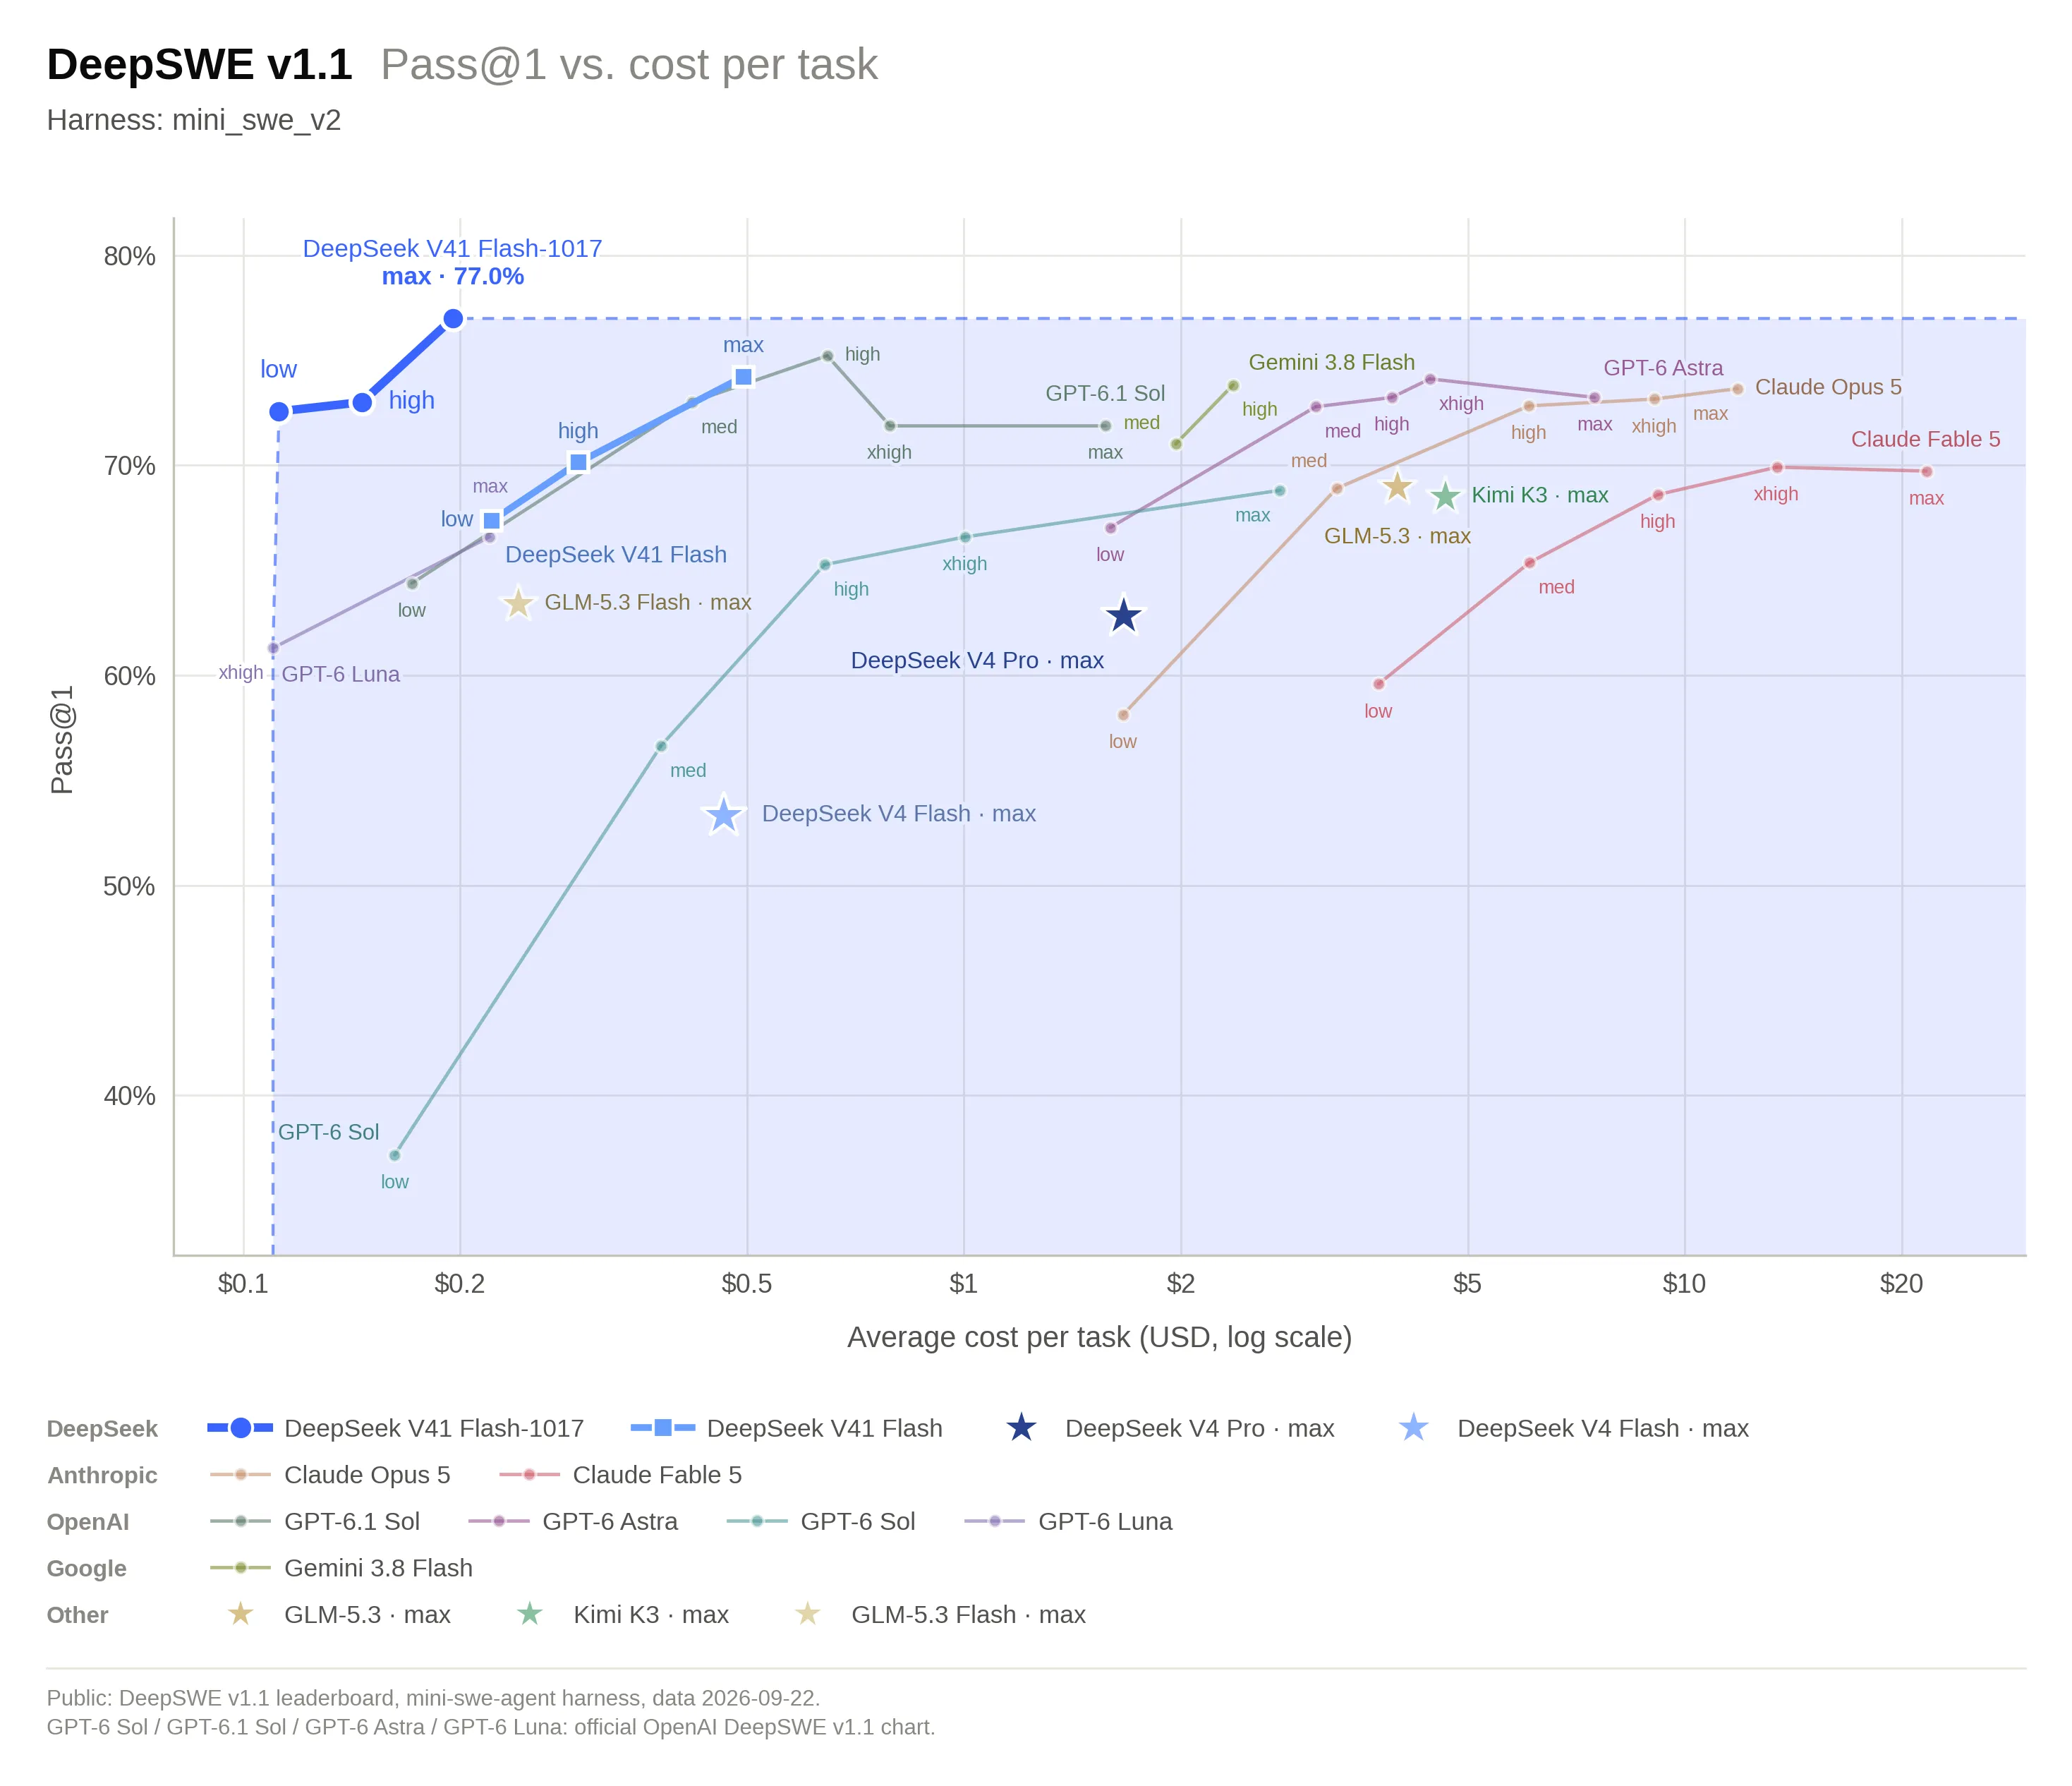
Компания называет Mercury 3 своей самой мощной открыто доступной диффузионной моделью. В её собственных сравнениях новинка обходит GPT-6 Luna и Claude Haiku 5.5 на части бенчмарков, оставаясь в 4–8 раз быстрее. Это заявления самого вендора, поэтому переносить их на все задачи без независимых тестов пока рано.
Быстрый ответ становится частью продукта
Mercury 3 уже доступна в API Inception, а также через OpenRouter, Baseten и Vercel. Интерфейс совместим с OpenAI API: команде не нужно переписывать клиентский код, чтобы проверить модель в существующем пайплайне.
Inception ориентирует релиз на голосовых и чат-агентов, поиск в реальном времени, обучение и веб-навигацию. В собственном тесте на 50 задачах Mind2Web модель выполнила 50% заданий браузерного агента; методика и сопоставление с конкурентами остаются ответственностью компании. Но направление понятно: при агентном поиске и голосовом интерфейсе лишние секунды — уже не мелочь, а причина, по которой пользователь перебивает систему.
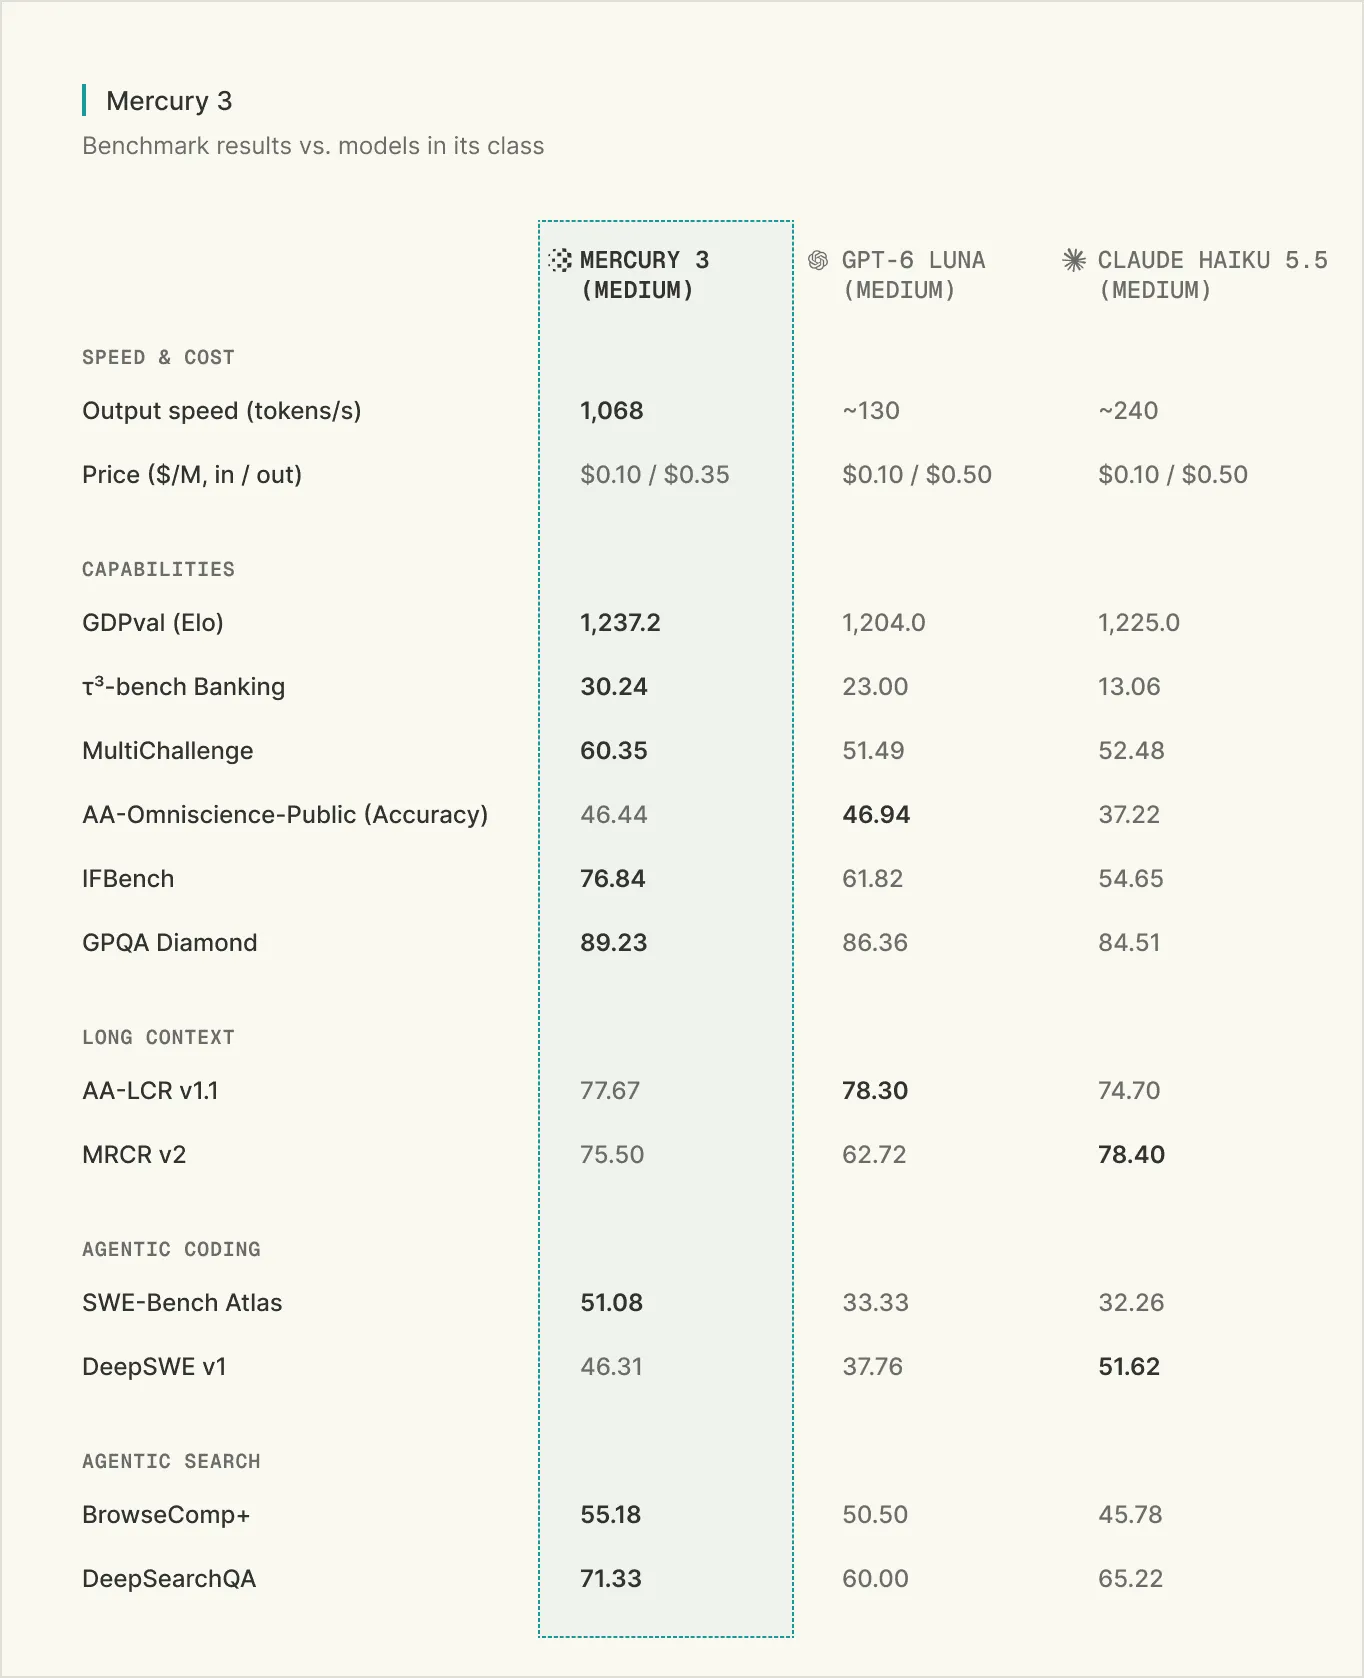
График: Inception.
Цена делает эксперимент проще
Базовая цена Mercury 3 составляет $0,20 за миллион входных и $0,70 за миллион выходных токенов. На запуск Inception предлагает 50‑процентную скидку: $0,10 и $0,35 соответственно; кэшированные входные токены дешевле на 90%.
Для разработчиков это повод не менять основную модель вслепую, а поставить Mercury 3 на узкий участок: быстрый черновой ответ, классификацию, поиск или агентный шаг с жёстким лимитом задержки. Если качество на реальных данных выдержит обещанную скорость, диффузионные LLM могут стать отдельным рабочим слоем — не заменой универсальным моделям, а способом убрать ожидание там, где оно действительно ломает продукт.