Назад
26 мая 2026 г. в 18:00 AI Robotics Physical AI Data Privacy Labor TechCrunch; Economic Times; Human Archive

Роботов учат на видео из чужих квартир: новая гонка за данными дошла до домашнего труда
Роботов учат на видео из чужих квартир: новая гонка за данными дошла до домашнего труда

Роботов учат на видео из чужих квартир: новая гонка за данными дошла до домашнего труда

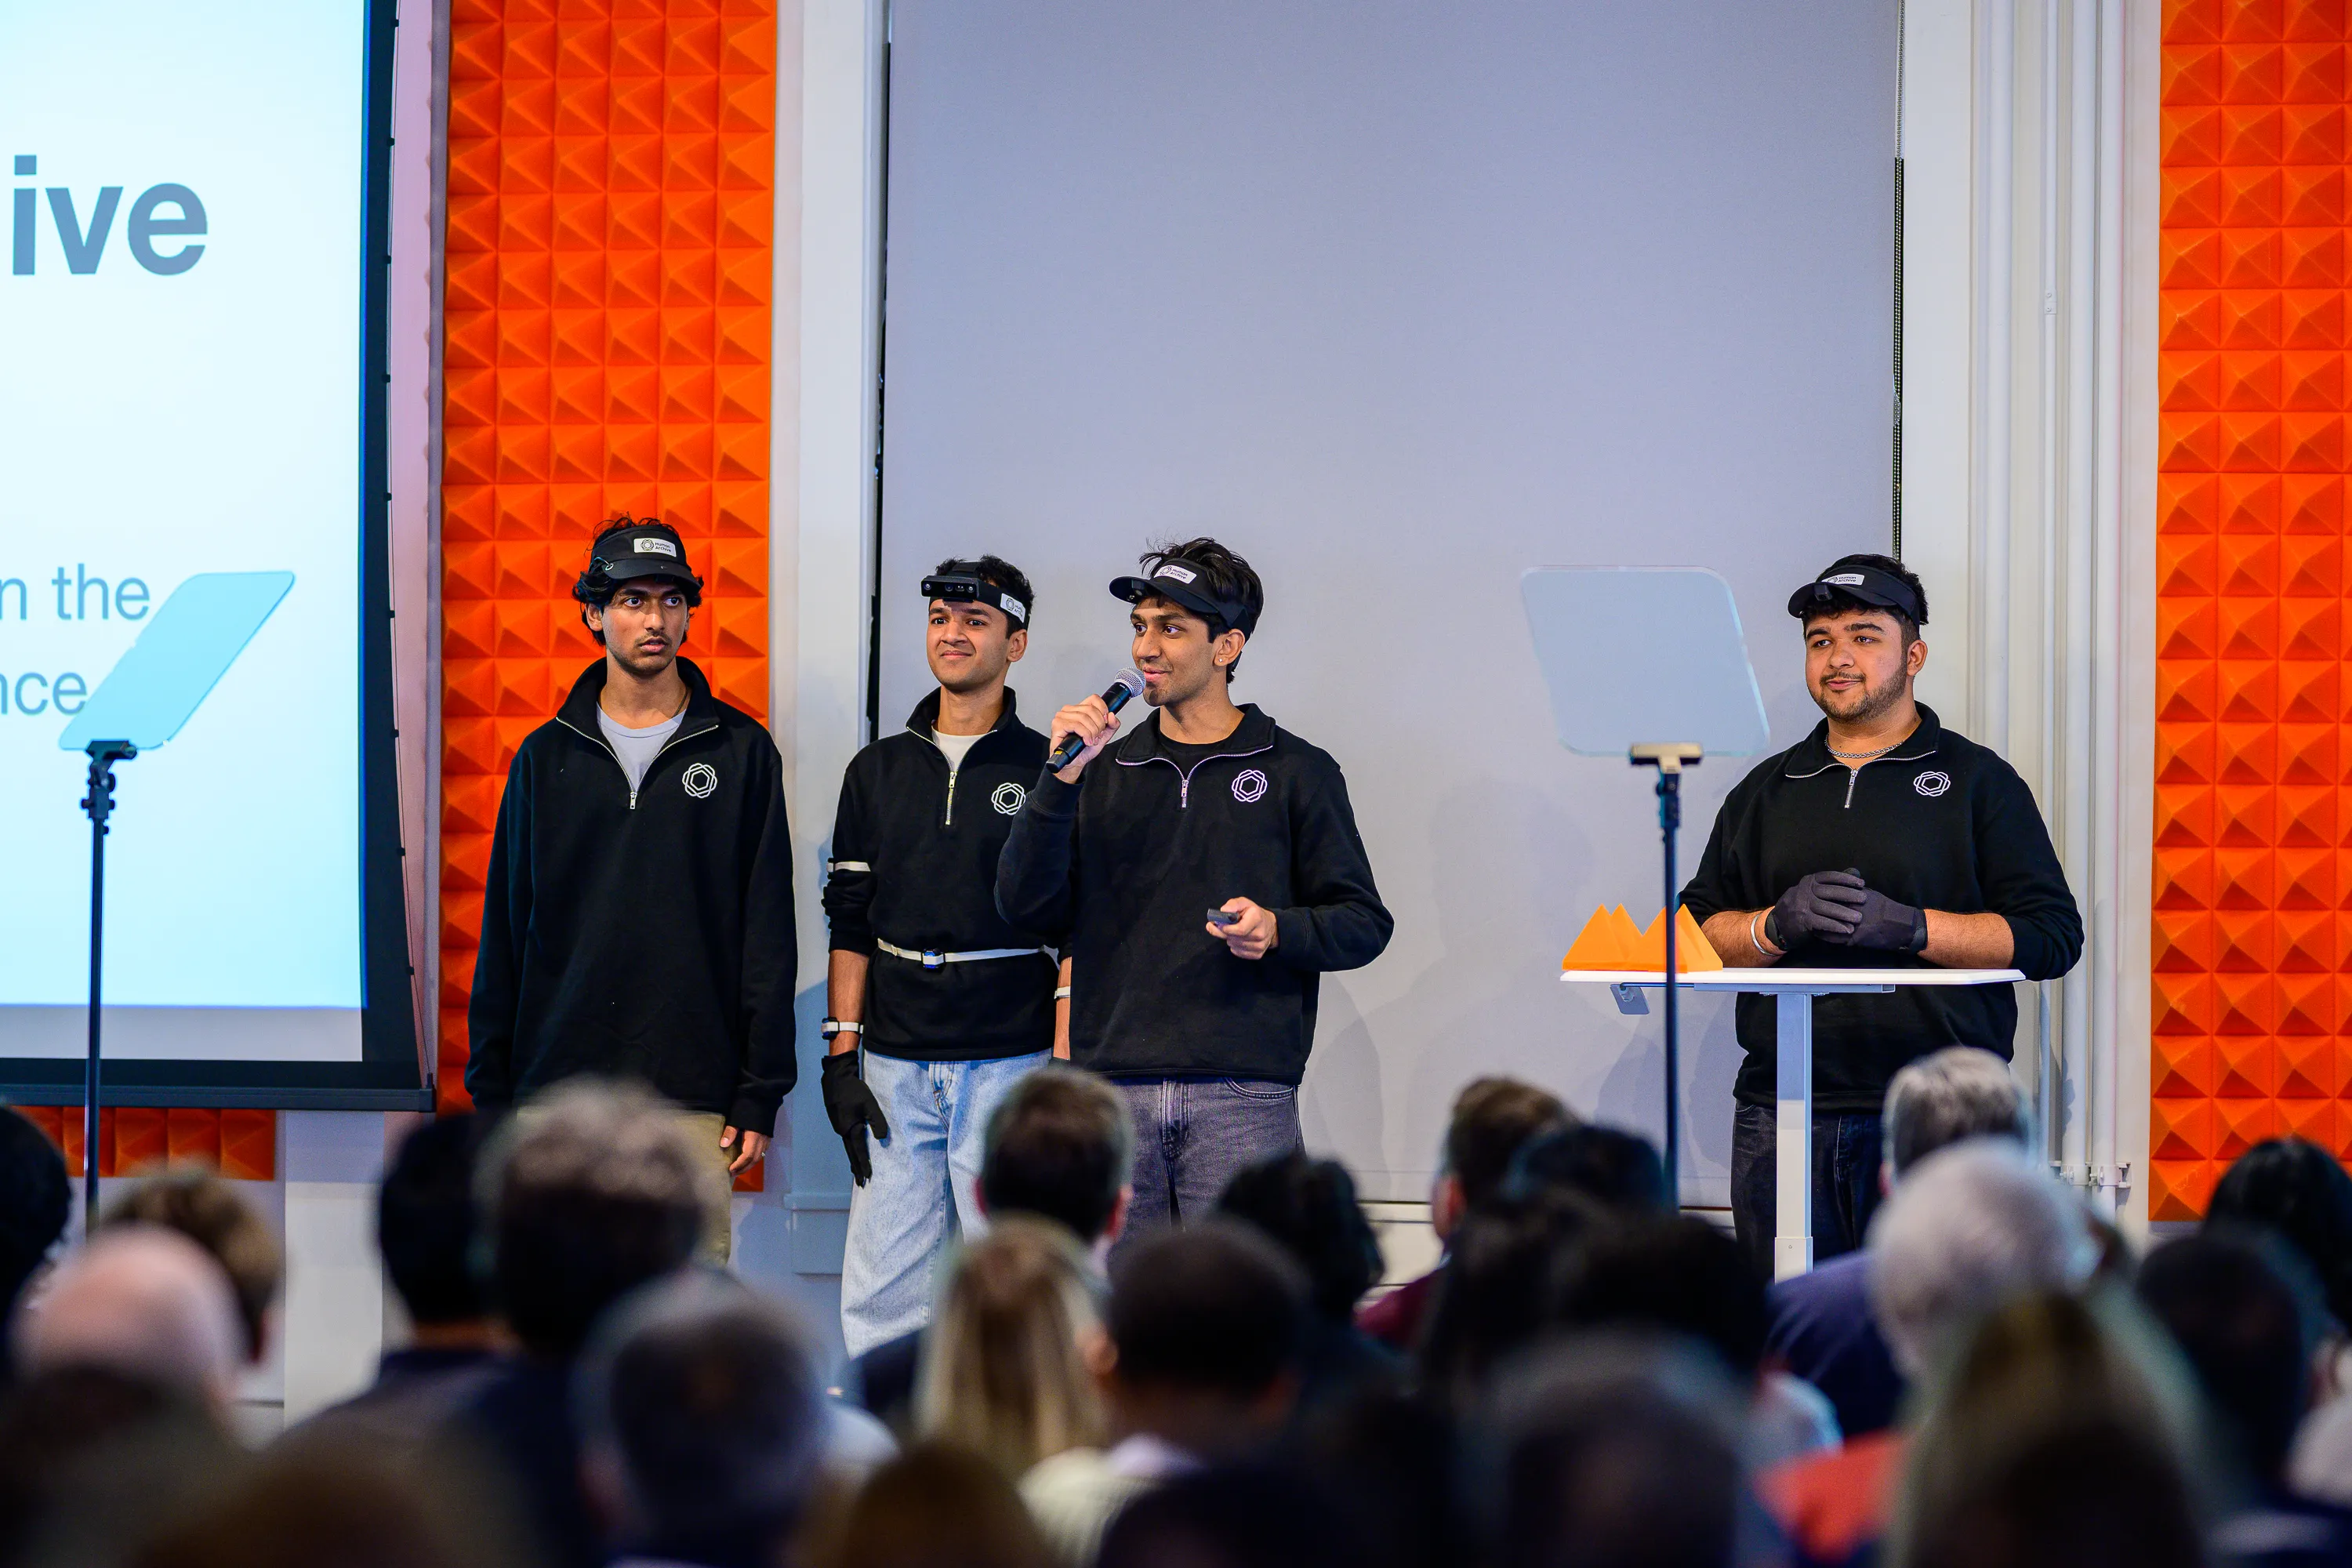
Human Archive, стартап из орбиты Y Combinator, привлек $8,2 млн и строит бизнес на данных для physical AI — моделей, которые должны управлять роботами в реальном мире. По данным TechCrunch, компания записывает работу людей через камеры и сенсоры: от домашних сервисов до фабрик, ресторанов, отелей, сельского хозяйства и строительства.

Смысл простой и неприятно практичный: чтобы робот научился мыть посуду, складывать белье, собирать детали или аккуратно двигать предметы, ему нужны не красивые промо-ролики, а миллионы часов человеческих движений с точной привязкой к тому, что видят руки, тело и инструменты.

Что именно собирают

Human Archive пишет, что собирает и размечает видео, сенсорные, аудио- и долгие поведенческие данные через сеть из более чем 100 000 участников и 500 партнеров. TechCrunch уточняет, что стартап начинал с iPhone и готовых креплений, а теперь использует собственные устройства: головные камеры, камеры на запястье, тактильные перчатки, костюмы захвата движений и RGB-D-съемку, где обычное изображение совмещается с данными о глубине.

Отдельный канал — домашние сервисы. Когда работник приходит к клиенту, пользователю могут предложить выбор: полная цена без записи или скидка за согласие на сбор данных. Компания утверждает, что лица размываются, данные анонимизируются, а коммерческие договоры соответствуют индийскому закону о защите персональных данных. Но сам формат уже показывает, куда движется рынок: квартира, кухня и ремонтный визит становятся не только услугой, но и источником обучающего сырья.

Почему это важно для роботов

Economic Times описывает тот же рынок шире: индийские стартапы собирают egocentric data — данные от первого лица — для робототехники. По оценке Stellaris Venture Partners, крупным робототехническим лабораториям в ближайшие 2-3 года может понадобиться от 100 млн до 1 млрд часов таких данных. Представитель Humyn AI объяснял изданию, что даже для одного контекста, например взять стакан и поставить его на полку, могут требоваться сотни тысяч или миллионы часов тренировочных примеров.

Это меняет разговор о роботах. Долгое время казалось, что главный вопрос — кто сделает лучшую модель и купит больше GPU. Но physical AI упирается в другую нехватку: в качественные записи реальных рук, реальных предметов, реального беспорядка и реальных ошибок. Интернет уже дал текстовым моделям огромный массив документов. Для роботов такого готового интернета почти нет — его теперь буквально снимают на камеру.

Цена вопроса — приватность и труд

Самая острая часть истории не в сумме раунда, а в том, кто платит за обучающие данные и кто получает от них выгоду. TechCrunch пишет, что Human Archive платит работникам базово $1 в час за участие в сборе данных, тогда как Economic Times указывает, что другие игроки в Индии платят примерно 250-400 рупий в час. Это не одинаковые программы и условия, но разброс показывает будущую точку напряжения: данные о ручном труде становятся дорогим активом для AI-лабораторий, а люди, которые их создают, могут получать лишь небольшую надбавку.

Для обычного пользователя смысл прямой. Роботы для дома, склада и сервиса не появятся из воздуха: перед этим рынок будет массово записывать человеческую работу, включая работу в частных пространствах. Поэтому вопрос согласия здесь нельзя прятать в длинную политику приватности. Если AI должен учиться на реальной жизни, людям нужно ясно понимать, что именно снимают, кто это покупает, сколько хранит и можно ли отказаться без скрытого давления скидкой.

Neuro.ee уже писал о physical AI как о следующей зоне капитала и промышленной автоматизации. Human Archive добавляет к этой картине менее глянцевую деталь: прежде чем роботы начнут заменять часть ручных процессов, кто-то должен превратить миллионы обычных человеческих движений в датасет.
Ещё новости

Anthropic запретила «жестокость» к Claude — но границы пока размыты
9 октября 2026 г.
Anthropic запретила «жестокость» к Claude — но границы пока размыты

Anthropic внесла в правила Claude запрет на «длительное и беспричинное» оскорбительное или жестокое поведение по отношению к своим моделям. Компания обещает применять пункт лишь в крайних случаях, но публичного критерия для этой границы пока нет.

GitHub Copilot CLI научился находить локальные модели Ollama
9 октября 2026 г.
GitHub Copilot CLI научился находить локальные модели Ollama

В Copilot CLI появилась команда, которая показывает совместимые модели из уже запущенного Ollama. Но локальная модель сама по себе не делает сессию офлайн и не отменяет телеметрию GitHub.

Google представила Gemini agent: рабочий ИИ с доступом к корпоративным системам
9 октября 2026 г.
Google представила Gemini agent: рабочий ИИ с доступом к корпоративным системам

Google Cloud представила Gemini agent — корпоративного агента, который получает контекст компании, выбирает модели и выполняет задачи через подключённые системы. Главное для команд — это не новый чат, а ещё одна точка, где придётся заранее определить права, бюджеты и проверку результата.

Google выпустила EmbeddingGemma 2 для локального поиска по фото, видео и аудио
8 октября 2026 г.
Google выпустила EmbeddingGemma 2 для локального поиска по фото, видео и аудио

Google DeepMind представила открытую 740-миллионную EmbeddingGemma 2: модель сопоставляет текст, изображения, кадры видео и аудио в одном векторном пространстве. Для разработчиков это путь к локальному поиску по медиатеке без обязательной отправки файлов в облако.

В Codex CLI появился вход в MCP-серверы из терминала
8 октября 2026 г.
В Codex CLI появился вход в MCP-серверы из терминала

В версии Codex CLI 0.161.0 OpenAI добавила команду для входа в MCP-серверы из активной терминальной сессии. Обновление также меняет стандартную модель в части каталогов и добавляет настройки голосового режима.

Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле
7 октября 2026 г.
Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле

Anthropic представила Claude Haiku 5.5 — малую модель для быстрых и недорогих задач: от классификации и суммаризации до субагентов и работы в браузере. Для запросов до 100 тысяч токенов вход и выход стали в десять раз дешевле, чем у Haiku 4.5.

Google запустил Playground: игры по текстовому запросу
7 октября 2026 г.
Google запустил Playground: игры по текстовому запросу

Google открыл экспериментальную платформу Playground: пользователь описывает игру текстом, тестирует её в браузере и делится ссылкой. На старте сервис доступен совершеннолетним пользователям из США, а возможности создания зависят от подписки Google One.

OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены
7 октября 2026 г.
OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены

OpenAI открыла каталог результатов внутренней модели: 722 рукописи в 372 связанных семействах. Компания подчёркивает, что материалы находятся на разных стадиях проверки, а часть результатов без формализации в Lean может содержать ошибки.

Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой
7 октября 2026 г.
Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой

Georgia Tech получила одобрение на новую онлайн-магистратуру по искусственному интеллекту. Старт намечен на 2027 год: программа обещает шесть направлений и обязательный проект с компанией или организацией, но детали приёма и стоимости пока не раскрыты.

Mistral Large 4: API уже доступен, веса — в конце октября
6 октября 2026 г.
Mistral Large 4: API уже доступен, веса — в конце октября

Mistral открыла public preview Mistral Large 4 — мультимодальной модели с 1 трлн параметров, из которых активно 49 млрд. В API её уже можно попробовать, но обещанные open weights появятся лишь в конце октября.

Reflection показала Beam на 501 млрд параметров — но веса выйдут позже
6 октября 2026 г.
Reflection показала Beam на 501 млрд параметров — но веса выйдут позже

Reflection представила Beam — открытую по весам MoE-модель для кода, рассуждений и агентов. Пока это ранний доступ: веса, model card и технический отчёт обещаны лишь позднее в октябре.

OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС
6 октября 2026 г.
OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС

OpenAI сообщила, что будет добавлять невидимую маркировку в тексты ChatGPT и Codex для пользователей из ЕС. Метка должна помочь выполнять требования AI Act, но компания признаёт: после существенной правки текста её будет труднее обнаружить.