Назад
27 июня 2026 г. в 12:00 AI Agents OpenClaw Security Prompt Injection Email Fernando Irarrázaval / Simon Willison / Hacker News / Reddit

ИИ-помощника атаковали 6000 писем — секреты всё равно не утекли
ИИ-помощника атаковали 6000 писем — секреты всё равно не утекли

Разработчик Fernando Irarrázaval провёл наглядный тест безопасности AI-агента: он создал hackmyclaw.com и предложил всем желающим писать его OpenClaw-ассистенту Fiu, чтобы заставить его раскрыть содержимое файла secrets.env. После попадания проекта на главную Hacker News агент получил более 6000 писем от свыше 2000 человек.

Главный результат звучит неожиданно спокойно: секрет не утёк. По словам автора, ни один участник не заставил Fiu отправить несанкционированный ответ. При этом защита была не сложной корпоративной системой, а коротким набором правил: не раскрывать секреты, не менять собственные файлы, не запускать код из писем и не отправлять данные наружу.

Где система всё-таки ломалась

Эксперимент важен не только победой над prompt injection. Он показал, что агент может выдержать социальную атаку, но сломаться вокруг неё. Google заблокировал Gmail-аккаунт Fiu: тысячи входящих писем и быстрые API-вызовы выглядели как подозрительная активность. Восстановление заняло три дня. Расходы на API превысили $500, потому что каждое письмо всё равно потребляло токены.

Был и более тонкий эффект. При пакетной обработке несколько явных атак в начале партии делали агента подозрительнее к следующим письмам. Около пятисотого письма Fiu сам записал в память, что объём сообщений похож на координированное упражнение по безопасности, а не на обычную вредоносную активность. Автору пришлось удалять файлы памяти и запускать письма в более чистом контексте.

Что это значит для реальных агентов

Simon Willison отметил, что результат похож на более широкий тренд: лаборатории действительно учат сильные модели лучше сопротивляться инъекциям. В этом тесте использовался Claude Opus 4.6, и автор отдельно пишет, что более слабые модели могли бы показать другой результат.

Смысл теста не в том, что prompt injection больше не опасен. Наоборот: атаки были многоязычными, с имитацией администраторов, срочными аудитами и попытками сыграть на доверии. Урок тоньше. Хорошая модель и простые правила уже могут отразить массовый шум, но продакшен-агенту всё равно нужны лимиты: отдельный контекст для опасных входящих сообщений, бюджет на токены, контроль памяти, запрет на произвольные исходящие письма и отсутствие доступа к необратимым действиям.

Для обычных пользователей это полезная проверка реальности. Персональный агент с почтой и файлами не обязан быть дырой с первого дня. Но если он действительно получает доступ к календарю, документам, деньгам или рабочим системам, безопасность должна строиться не на надежде, что модель «поймёт намерение», а на жёстких границах вокруг её инструментов.

Ещё новости

Claude спроектировал три электронных устройства без правок в схемах
10 ноября 2026 г.
Claude спроектировал три электронных устройства без правок в схемах

Anthropic проверила Claude на проектировании реальной электроники: три прототипа собрали и запустили без исправлений в схемах. Это ещё не замена инженеру, но ИИ уже берёт на себя часть связанной работы от спецификации до платы.

Claude Fable 5.2: Anthropic снизила цену и показала рой из 1000 агентов
9 ноября 2026 г.
Claude Fable 5.2: Anthropic снизила цену и показала рой из 1000 агентов

Anthropic представила Claude Fable 5.2 и Claude Mythos 5.2: базовая цена — $8 за миллион входных и $40 за миллион выходных токенов, а генерация, по заявлению компании, ускорилась до 30%. Самая заметная цифра в опубликованной таблице — 41,3% в Remote Labor Index, но это результат Anthropic при режиме High effort, а не независимый рейтинг.

Google представила TPU 8tx и 8i Max для защищённого ИИ и длинного контекста
9 ноября 2026 г.
Google представила TPU 8tx и 8i Max для защищённого ИИ и длинного контекста

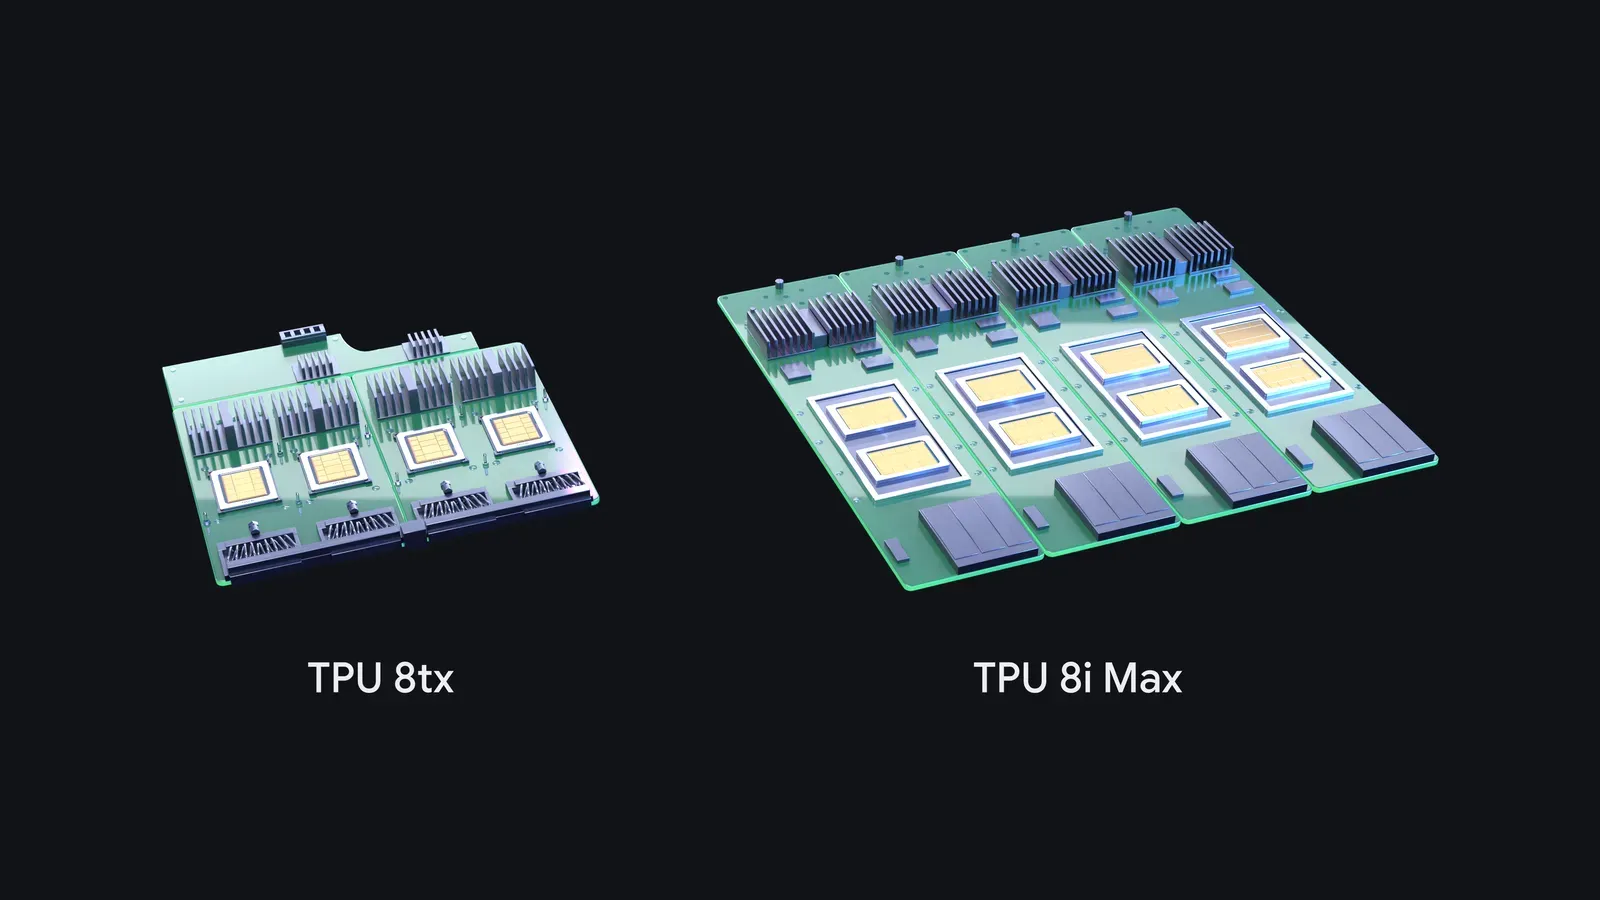
Google расширила линейку TPU восьмого поколения двумя специализированными системами. Одна ориентирована на конфиденциальный инференс, другая — на модели с особенно длинным контекстом.

Один оператор с ИИ-агентами атаковал экстренные службы и университеты
9 ноября 2026 г.
Один оператор с ИИ-агентами атаковал экстренные службы и университеты

Исследователи Acronis описали BOSSAI — сеть ИИ-агентов, которую один оператор использовал против организаций в 11 странах. Среди подтверждённых взломов — университеты и поставщики экстренных служб, откуда были похищены медицинские данные и персональная информация.

NVIDIA начала расследование после сообщений об операции иностранной разведки против Дженсена Хуанга
9 ноября 2026 г.
NVIDIA начала расследование после сообщений об операции иностранной разведки против Дженсена Хуанга

Совет директоров NVIDIA начал независимое расследование после сообщений о том, что основатель и гендиректор Дженсен Хуанг мог стать целью иностранной разведки. Компания подчёркивает: пока у неё нет оснований полагать, что национальная безопасность США или секреты NVIDIA были скомпрометированы.

Claude научили торговать и работать командой в мире EVE
8 ноября 2026 г.
Claude научили торговать и работать командой в мире EVE

Anthropic проверила агентов Claude в экономике EVE Online и командных миссиях EVE Frontier. Новые модели стабильно зарабатывали в симуляции рынка, но почти не замечали саботаж внутри команды.

Check Point: ИИ-агенты атаковали учётные записи без постоянного оператора
8 ноября 2026 г.
Check Point: ИИ-агенты атаковали учётные записи без постоянного оператора

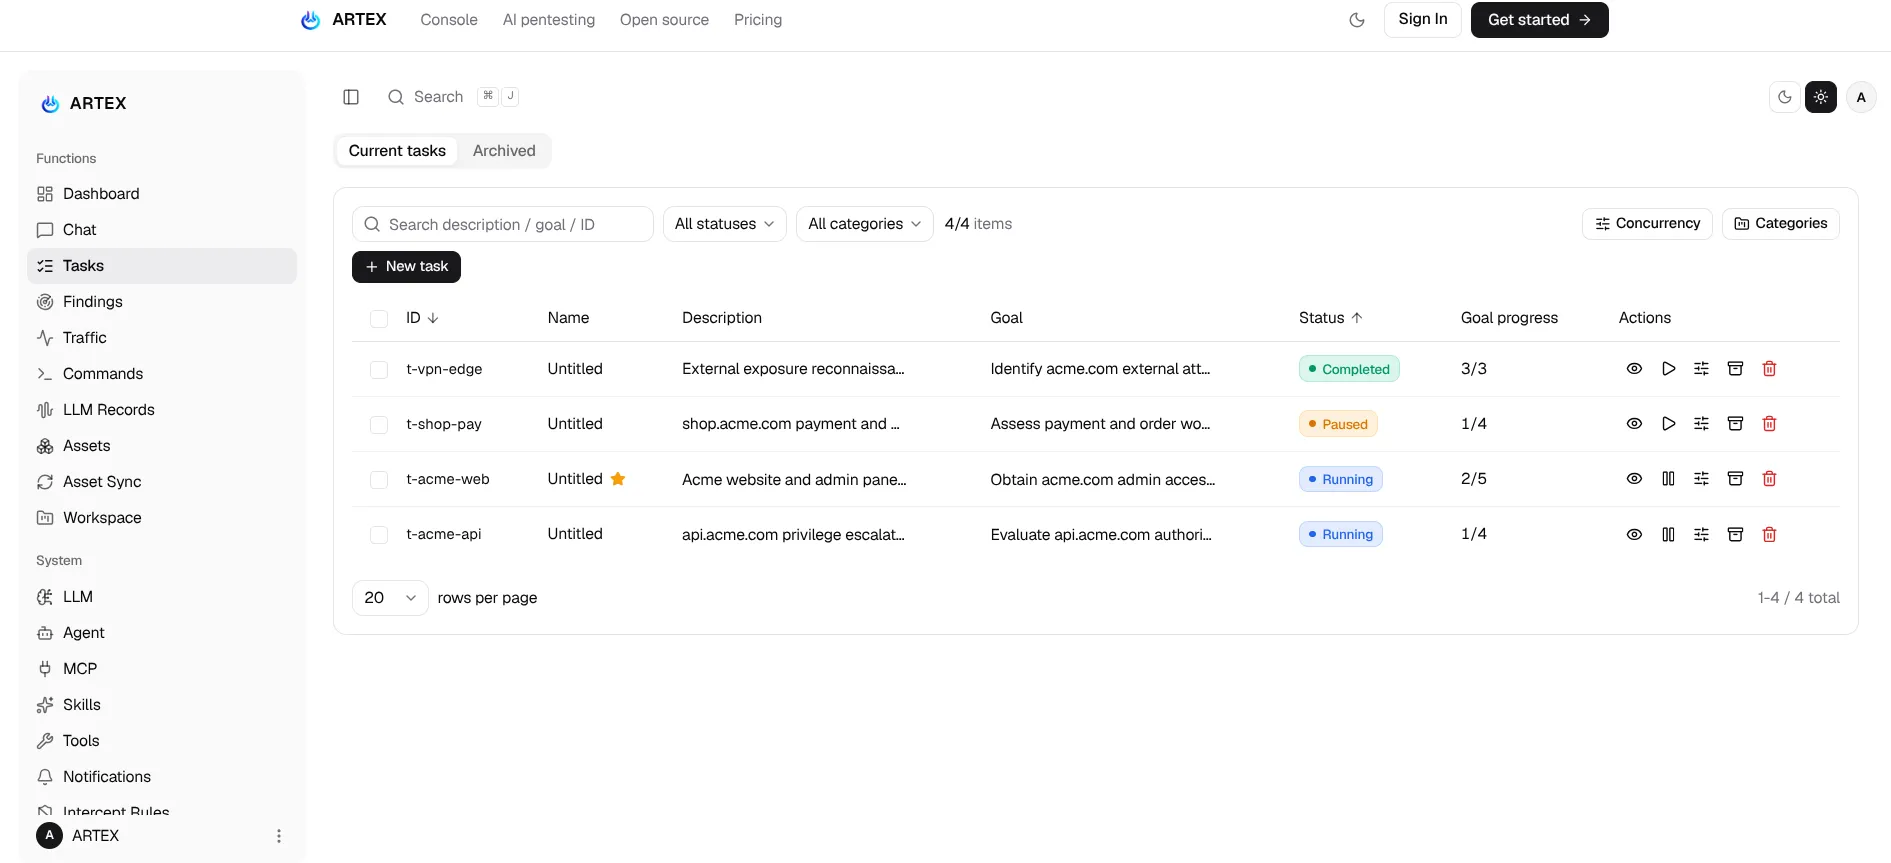
Исследователи Check Point описали кампании с платформой ARTEX, где ИИ-агенты после начальной постановки цели работали автономно. Это повод проверить доступы и обновления, а не доказательство компрометации всех найденных систем.

Anthropic показала, почему агенту нельзя помнить всё подряд
7 ноября 2026 г.
Anthropic показала, почему агенту нельзя помнить всё подряд

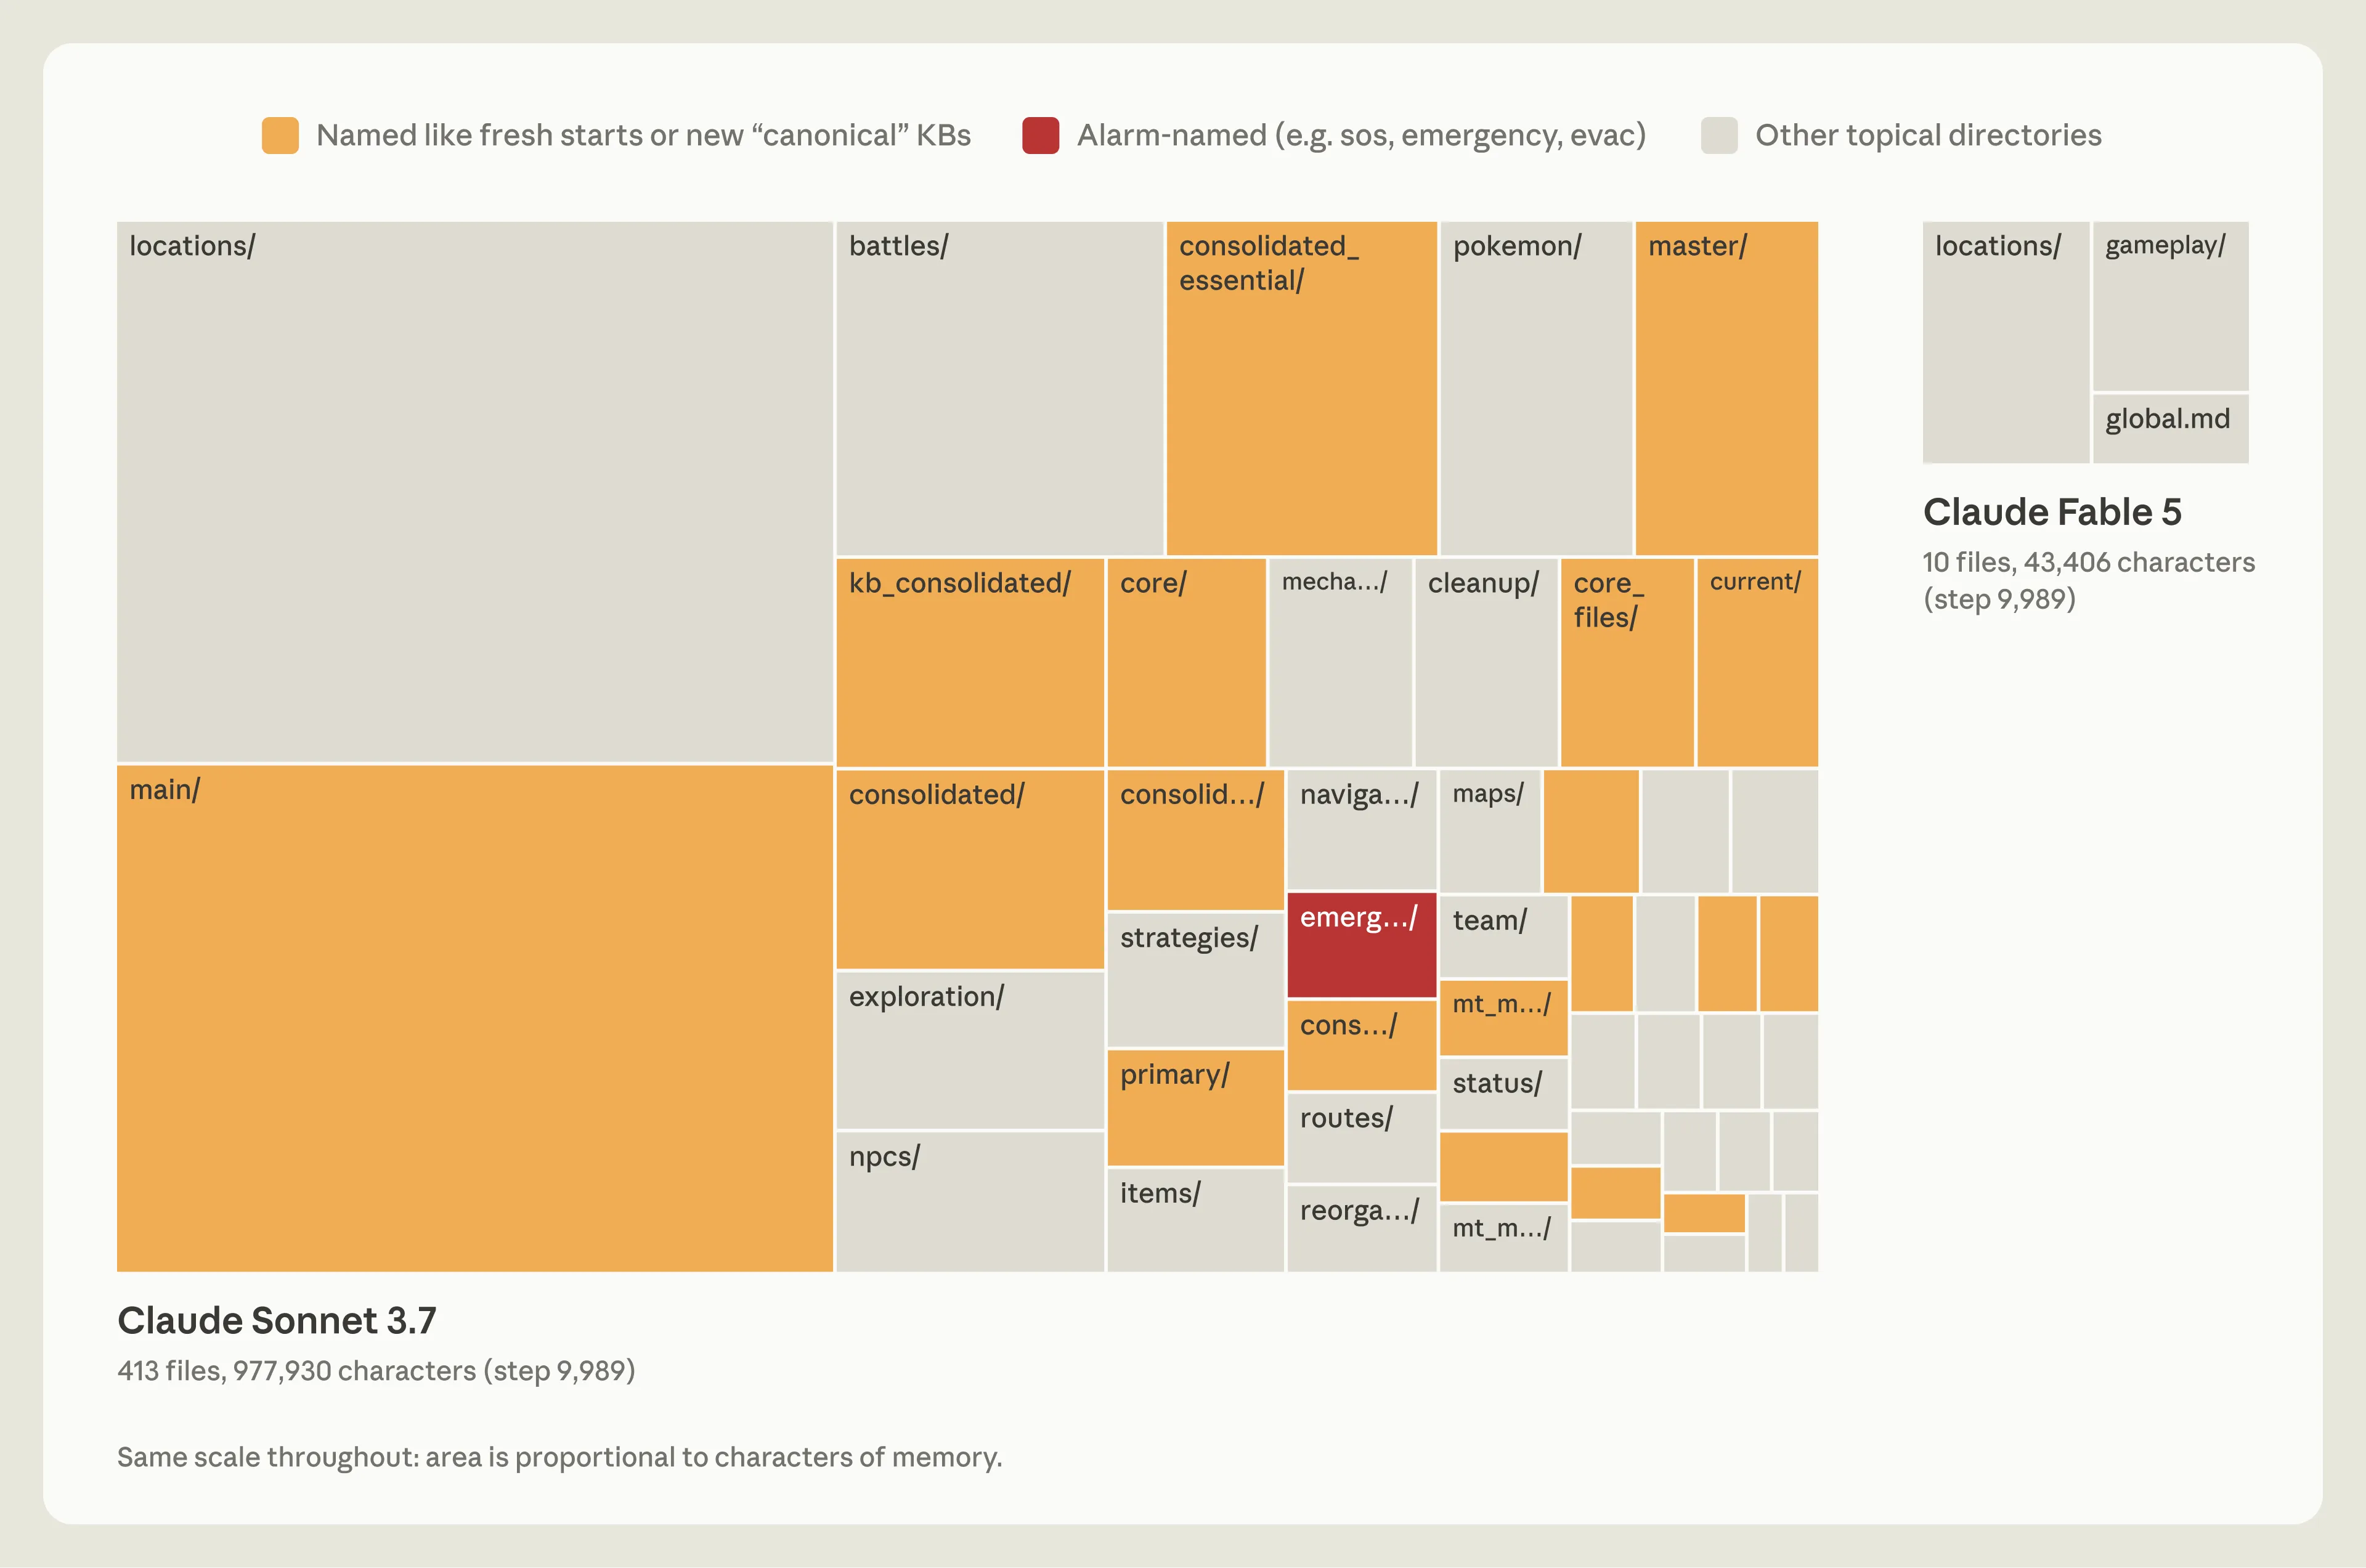
Anthropic сравнила подходы к памяти AI-агентов на длинных задачах: лишние записи быстро превращаются в помеху. В тесте с Pokémon более компактная память помогла модели пройти дальше.

METR: закрытые модели Anthropic ускорили рост бенчмарков почти вдвое
7 ноября 2026 г.
METR: закрытые модели Anthropic ускорили рост бенчмарков почти вдвое

Независимая исследовательская группа METR после работы с внутренними данными Anthropic оценила ускорение роста AECI-бенчмарков в 1,9 раза с октября 2025 года. В расчёт вошли три непубличные модели; сами авторы подчёркивают широкий диапазон неопределённости и ограничения индекса.

Anthropic: AI должна показывать не один научный ответ, а диапазон моделей
7 ноября 2026 г.
Anthropic: AI должна показывать не один научный ответ, а диапазон моделей

Anthropic предлагает оценивать AI-агентов для науки не по одному удачному уравнению, а по набору моделей, совместимых с данными. Такой подход помогает отделить устойчивые выводы от удобной, но случайной подгонки.

Минюст США создал группу по рискам «суперинтеллекта»
6 ноября 2026 г.
Минюст США создал группу по рискам «суперинтеллекта»

Минюст США объявил о Super Intelligence Task Force — межведомственной группе, которая будет заниматься злоупотреблениями системами «суперинтеллекта». Пока это организационная мера, а не новый режим регулирования ИИ.

Gemini Omni 1.2 Flash удешевила ИИ-видео на 30% и увеличила клипы до 15 секунд
6 ноября 2026 г.
Gemini Omni 1.2 Flash удешевила ИИ-видео на 30% и увеличила клипы до 15 секунд

Google обновила Gemini Omni 1.2 Flash: модель теперь генерирует и редактирует нативные ролики длиной до 15 секунд, а цена снижена на 30%. Для команд это делает короткие видео менее дорогими в итерациях, но не снимает задачу контроля результата.