Google выпустила Gemini 3.5 Transcribe: ИИ будет расшифровывать речь без «э-э» и с именами спикеров
Google 26 августа представила Gemini 3.5 Transcribe — отдельную модель для перевода речи в текст — и Gemini 3.5 Transcribe Live для потоковой расшифровки. Обе доступны разработчикам через Gemini API. Компания обещает, что они лучше справляются с фоновым шумом, профессиональной лексикой и живой, сбивчивой речью.
Вторая деталь важнее, чем кажется: сервис должен превращать неаккуратное «ну, я хотел сказать…» в пригодную для чтения фразу. Google называет этот режим умной расшифровкой. Его задача — понимать самокоррекцию говорящего, распознавать названия, номера заказов и другую буквенно-цифровую информацию, а не просто посимвольно воспроизводить звук в разговоре, где человек обычно перебивает сам себя.
Не только диктовка
Для записей встреч, звонков и интервью обычная Transcribe добавляет временные метки для отдельных слов и определение спикеров. Официально заявлена разметка до трёх человек; поддержка большего количества участников пока имеет экспериментальный статус. Можно передать собственный словарь — полезно для медицины, юриспруденции, названий продуктов и внутренних сокращений.
Модель автоматически распознаёт и расшифровывает более 85 языков. Это не означает безошибочность во всех акцентах и условиях: заявление о качестве исходит от Google, а реальные сценарии с плохой связью и смешением языков ещё предстоит проверить разработчикам.
Голосовой интерфейс без ожидания
Gemini 3.5 Transcribe Live предназначена для приложений, которым текст нужен прямо во время разговора. Она работает по двустороннему соединению WebSocket в Live API и отдаёт как промежуточные, так и окончательные фрагменты. Google заявляет задержку менее секунды.
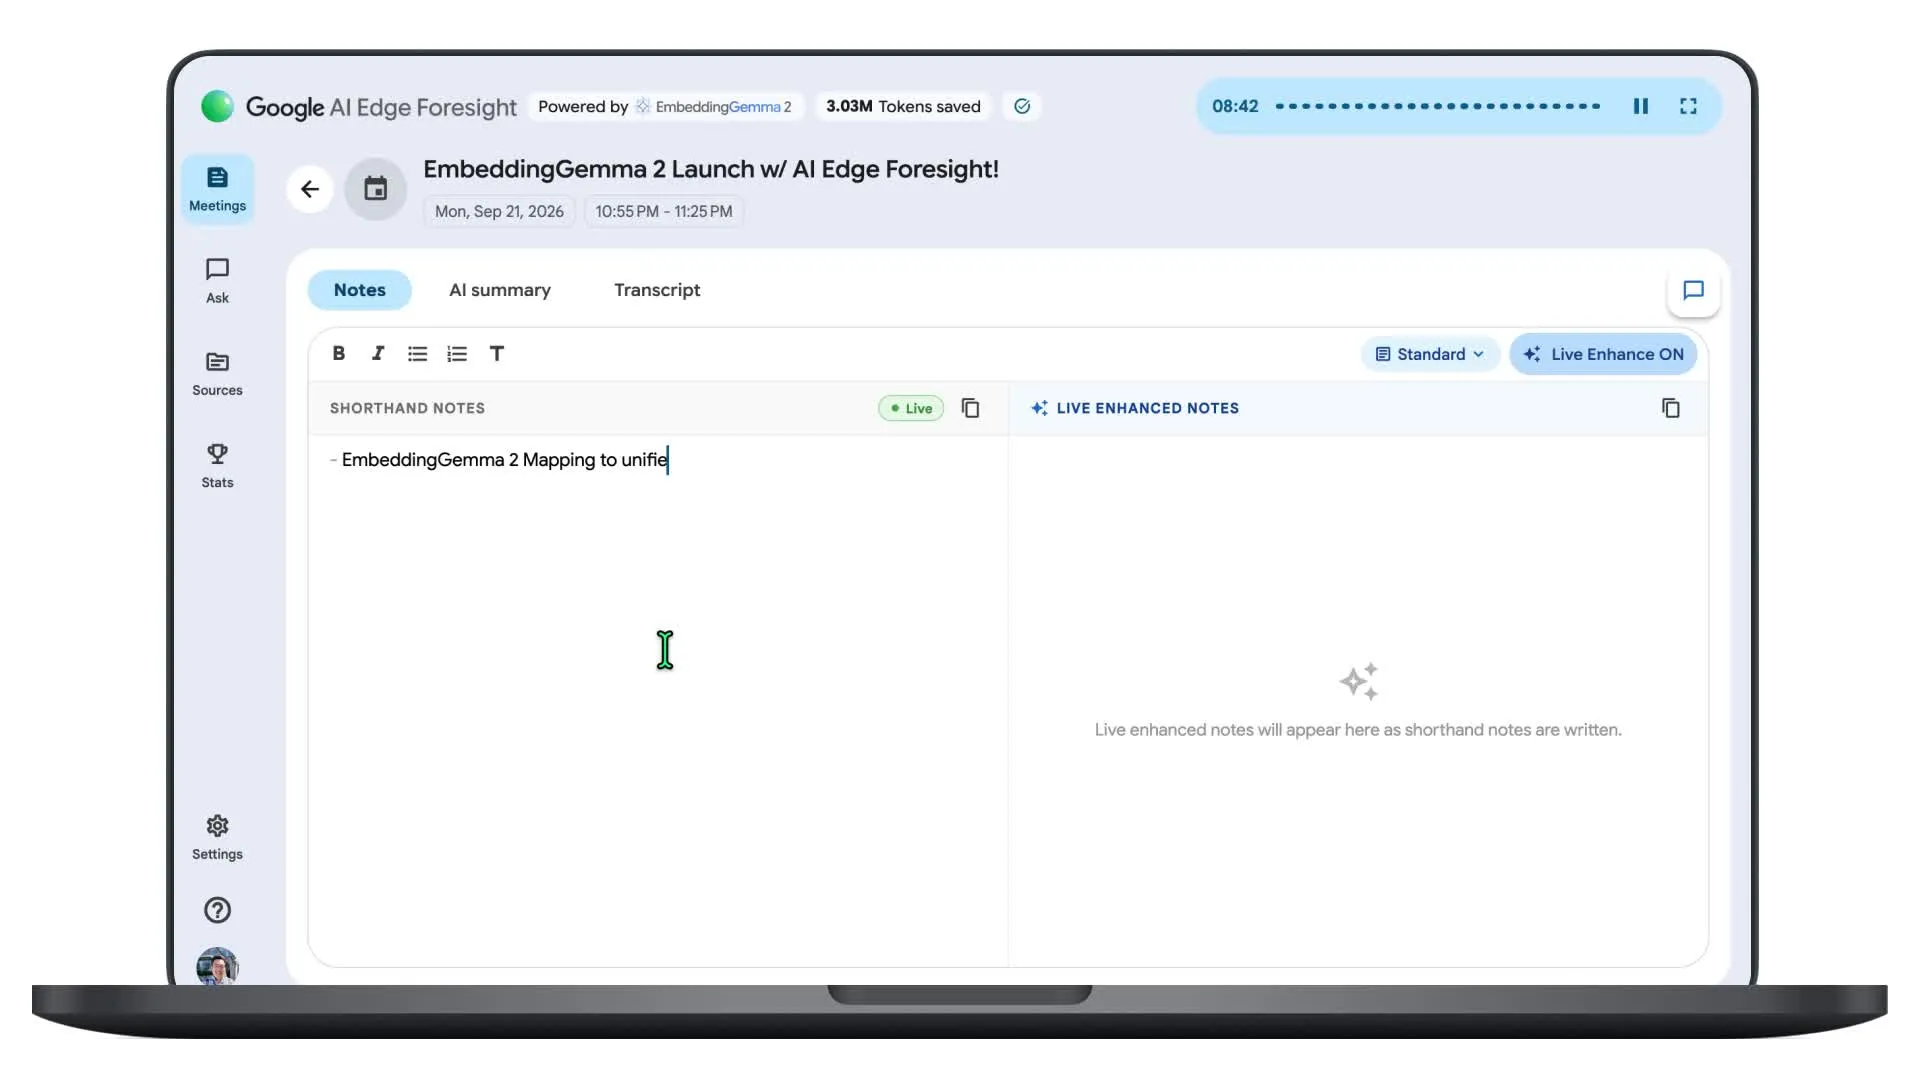
Практическое последствие — голосовой помощник, операторская панель или заметки по встрече могут получать структурированную речь без отдельной цепочки из распознавания, очистки текста и определения говорящих. Но у такого удобства есть цена: разговоры и записи становятся ещё одним чувствительным типом данных, поэтому компаниям придётся отдельно решать, какие аудио можно отправлять во внешний API и как долго хранить результат.