Gemini 3.5 Flash научился управлять браузером, телефоном и рабочим столом
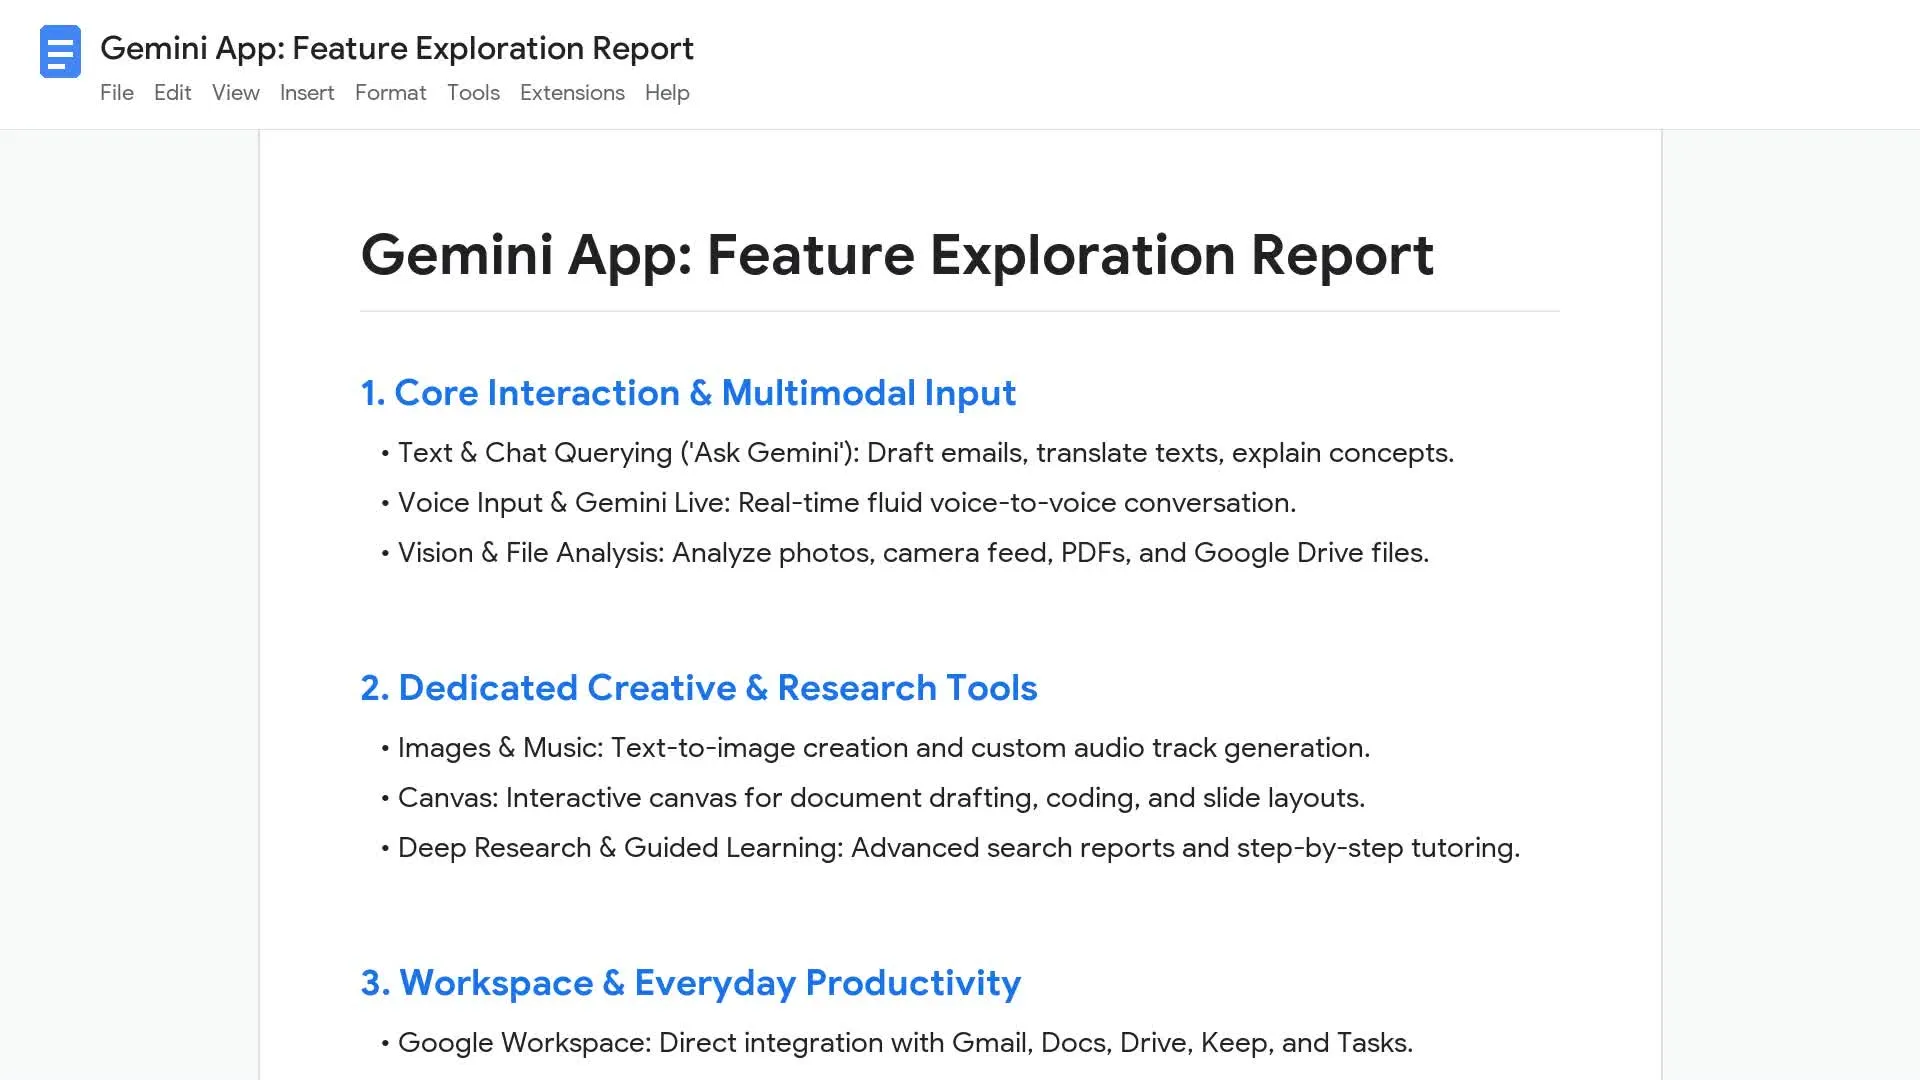
Google добавила Computer Use в Gemini 3.5 Flash: теперь это не отдельная экспериментальная модель, а встроенный инструмент в основной Flash-модели. Public preview доступен через Gemini API и Gemini Enterprise Agent Platform. Для разработчиков это означает более простой способ собирать агентов, которые видят экран по скриншотам и возвращают конкретные UI-действия: клик, ввод текста, переход по адресу, ожидание или работу с приложением.
Главное здесь не в красивой демке. Google переносит «компьютерное зрение + действие» в быстрый массовый класс модели. Если раньше агенту чаще давали API и функции, теперь он может идти через обычный интерфейс: браузер, мобильную среду или desktop. Это важно для старых корпоративных систем, внутренних панелей и сайтов, где нормального API нет или его нельзя быстро подключить.
Как это работает
Приложение запускает цикл: отправляет модели задачу, настройки среды и скриншот, получает предложенное действие, выполняет его на клиентской стороне, делает новый скриншот и снова спрашивает модель. В Gemini 3.5 Flash ответ включает не только координаты, но и intent — короткое объяснение, зачем модель предлагает этот шаг.
Google приводит типовые сценарии: заполнение форм, тестирование пользовательских путей, сбор информации с разных сайтов, проверка документации и работа с профессиональными приложениями. В официальном демо Gemini исследует мобильное приложение Gemini и собирает отчёт о функциях, а в другом примере проверяет документацию на проблемы доступности.
Безопасность стала частью продукта
Computer Use остаётся preview-возможностью, и Google прямо предупреждает: её нельзя пускать без присмотра в критические решения, чувствительные данные и необратимые действия. Это честная оговорка. Агент, который читает экран, может также прочитать спрятанную на странице инструкцию и попытаться выполнить её вместо задачи пользователя.
Поэтому в Gemini 3.5 Flash появились настраиваемые политики безопасности, категории действий, которые требуют подтверждения, и опциональное сканирование скриншотов на prompt injection. Клиентское приложение всё равно должно само выполнять действия, масштабировать координаты под экран, вести журнал и останавливать запрещённые шаги.
Почему это важно
Рынок агентов быстро движется от «помощник советует» к «помощник делает». OpenAI, Anthropic и Google сходятся в одной точке: модель должна не только писать текст, но и ходить по инструментам. Разница теперь в том, кто даст разработчикам более надёжный контур исполнения.
Для бизнеса это практический выбор ближайших месяцев. Такие агенты могут закрывать рутинные операции там, где интеграции годами откладывались. Но выигрыш появится только у тех, кто строит песочницы, лимиты, подтверждения и аудит заранее. Иначе «агент умеет пользоваться компьютером» быстро превращается из преимущества в источник тихих ошибок.