Назад
29 мая 2026 г. в 18:05 AI Voice AI Video Localization ElevenLabs Creators ElevenLabs; Techmeme

ElevenLabs научила AI-дубляж сохранять эмоции голоса на 90 языках
ElevenLabs научила AI-дубляж сохранять эмоции голоса на 90 языках

ElevenLabs научила AI-дубляж сохранять эмоции голоса на 90 языках

ElevenLabs запустила Dubbing v2 — новую модель для AI-дубляжа видео и аудио. Компания обещает, что система переводит речь на 90+ языков и сохраняет не только смысл фраз, но и манеру исходного спикера: эмоцию, тон, темп, паузы, акценты в подаче и голосовую идентичность. Для зрителя это должно звучать не как сухая озвучка по тексту, а как более естественная локализованная версия оригинального выступления.

Главное техническое отличие ElevenLabs формулирует прямо: Dubbing v2 работает от исходного аудио, а не только от расшифровки. Обычные системы дубляжа часто сначала превращают речь в текст, переводят его, а затем заново генерируют голос. В таком маршруте легко потерять интонацию, нерв, сомнение, энергию или шутливую паузу. Новая модель пытается переносить саму performance-часть речи — как человек говорит, а не только что он сказал.

Что именно автоматизирует Dubbing v2

В продуктовой версии ElevenLabs описывает полный автоматический конвейер: перевод, клонирование голоса, дубляж и синхронизацию. Модель должна учитывать, что разные языки требуют разной длины фраз и другого ритма. Поэтому в системе есть sync-aware translation: она подгоняет начало, конец и темп реплик под исходный ролик, чтобы переведенная речь не разваливалась по таймингу.

Для авторов это означает более быстрый путь к международной аудитории: YouTube-ролик, курс, подкаст или презентацию можно локализовать без отдельной команды переводчиков, дикторов и инженеров звука. Для маркетинга — быстрее выпускать кампании на несколько рынков. Для студий и вещателей — дешевле тестировать версии на разных языках, не запуская полный процесс профессионального дубляжа каждый раз.

Почему это важно не только блогерам

Локализация долго была дорогим фильтром доступа. Большие студии могли переводить контент на десятки рынков, а независимый автор чаще выбирал один язык и терял аудиторию за его пределами. Если AI-дубляж становится достаточно естественным, меняется экономика распространения знаний, развлечений, рекламы и обучения. Маленькая команда получает шанс звучать сразу в нескольких странах, а зритель — получать больше материалов на своем языке.

Есть и обратная сторона. Чем лучше модель сохраняет голос и эмоцию, тем важнее согласие человека, права на голос, маркировка синтетической речи и защита от подделок. ElevenLabs продает Dubbing v2 как инструмент для легальной локализации, но сама технология находится рядом с более широким конфликтом вокруг AI-голосов: кто может воспроизводить голос, где проходит граница между переводом и имитацией, и как аудитория понимает, что именно она слышит.

Куда движется рынок медиа

Dubbing v2 показывает общий тренд: AI-инструменты для медиа уходят от отдельных фокусов вроде «переведи текст» или «сгенерируй голос» к производственным цепочкам. Пользователю нужен не набор моделей, а готовый результат: ролик на другом языке, с похожим голосом, нормальным темпом и без часов ручной правки.

Если качество окажется стабильным на реальных роликах, AI-дубляж станет одним из самых понятных применений генеративного ИИ для массового рынка. Его пользу легко объяснить: меньше языковых барьеров, ниже стоимость локализации, быстрее выход на новые аудитории. Но доверие будет зависеть не только от звучания. Чем убедительнее синтетическая речь, тем важнее прозрачные правила: кто дал разрешение на голос, где хранится исходное аудио и как зрителю сообщают, что перед ним AI-дубляж.

Ещё новости

GitHub Copilot CLI научился находить локальные модели Ollama
9 октября 2026 г.
GitHub Copilot CLI научился находить локальные модели Ollama

В Copilot CLI появилась команда, которая показывает совместимые модели из уже запущенного Ollama. Но локальная модель сама по себе не делает сессию офлайн и не отменяет телеметрию GitHub.

Google представила Gemini agent: рабочий ИИ с доступом к корпоративным системам
9 октября 2026 г.
Google представила Gemini agent: рабочий ИИ с доступом к корпоративным системам

Google Cloud представила Gemini agent — корпоративного агента, который получает контекст компании, выбирает модели и выполняет задачи через подключённые системы. Главное для команд — это не новый чат, а ещё одна точка, где придётся заранее определить права, бюджеты и проверку результата.

Google выпустила EmbeddingGemma 2 для локального поиска по фото, видео и аудио
8 октября 2026 г.
Google выпустила EmbeddingGemma 2 для локального поиска по фото, видео и аудио

Google DeepMind представила открытую 740-миллионную EmbeddingGemma 2: модель сопоставляет текст, изображения, кадры видео и аудио в одном векторном пространстве. Для разработчиков это путь к локальному поиску по медиатеке без обязательной отправки файлов в облако.

В Codex CLI появился вход в MCP-серверы из терминала
8 октября 2026 г.
В Codex CLI появился вход в MCP-серверы из терминала

В версии Codex CLI 0.161.0 OpenAI добавила команду для входа в MCP-серверы из активной терминальной сессии. Обновление также меняет стандартную модель в части каталогов и добавляет настройки голосового режима.

Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле
7 октября 2026 г.
Anthropic выпустила Claude Haiku 5.5: массовые ИИ-агенты стали дешевле

Anthropic представила Claude Haiku 5.5 — малую модель для быстрых и недорогих задач: от классификации и суммаризации до субагентов и работы в браузере. Для запросов до 100 тысяч токенов вход и выход стали в десять раз дешевле, чем у Haiku 4.5.

Google запустил Playground: игры по текстовому запросу
7 октября 2026 г.
Google запустил Playground: игры по текстовому запросу

Google открыл экспериментальную платформу Playground: пользователь описывает игру текстом, тестирует её в браузере и делится ссылкой. На старте сервис доступен совершеннолетним пользователям из США, а возможности создания зависят от подписки Google One.

OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены
7 октября 2026 г.
OpenAI выложила 722 математические рукописи — но не все доказательства уже проверены

OpenAI открыла каталог результатов внутренней модели: 722 рукописи в 372 связанных семействах. Компания подчёркивает, что материалы находятся на разных стадиях проверки, а часть результатов без формализации в Lean может содержать ошибки.

Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой
7 октября 2026 г.
Georgia Tech готовит онлайн-магистратуру по ИИ с обязательной практикой

Georgia Tech получила одобрение на новую онлайн-магистратуру по искусственному интеллекту. Старт намечен на 2027 год: программа обещает шесть направлений и обязательный проект с компанией или организацией, но детали приёма и стоимости пока не раскрыты.

Mistral Large 4: API уже доступен, веса — в конце октября
6 октября 2026 г.
Mistral Large 4: API уже доступен, веса — в конце октября

Mistral открыла public preview Mistral Large 4 — мультимодальной модели с 1 трлн параметров, из которых активно 49 млрд. В API её уже можно попробовать, но обещанные open weights появятся лишь в конце октября.

Reflection показала Beam на 501 млрд параметров — но веса выйдут позже
6 октября 2026 г.
Reflection показала Beam на 501 млрд параметров — но веса выйдут позже

Reflection представила Beam — открытую по весам MoE-модель для кода, рассуждений и агентов. Пока это ранний доступ: веса, model card и технический отчёт обещаны лишь позднее в октябре.

OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС
6 октября 2026 г.
OpenAI начнёт маркировать тексты ChatGPT и Codex в ЕС

OpenAI сообщила, что будет добавлять невидимую маркировку в тексты ChatGPT и Codex для пользователей из ЕС. Метка должна помочь выполнять требования AI Act, но компания признаёт: после существенной правки текста её будет труднее обнаружить.

GitHub открыла API для запуска проверок кода Copilot
5 октября 2026 г.
GitHub открыла API для запуска проверок кода Copilot

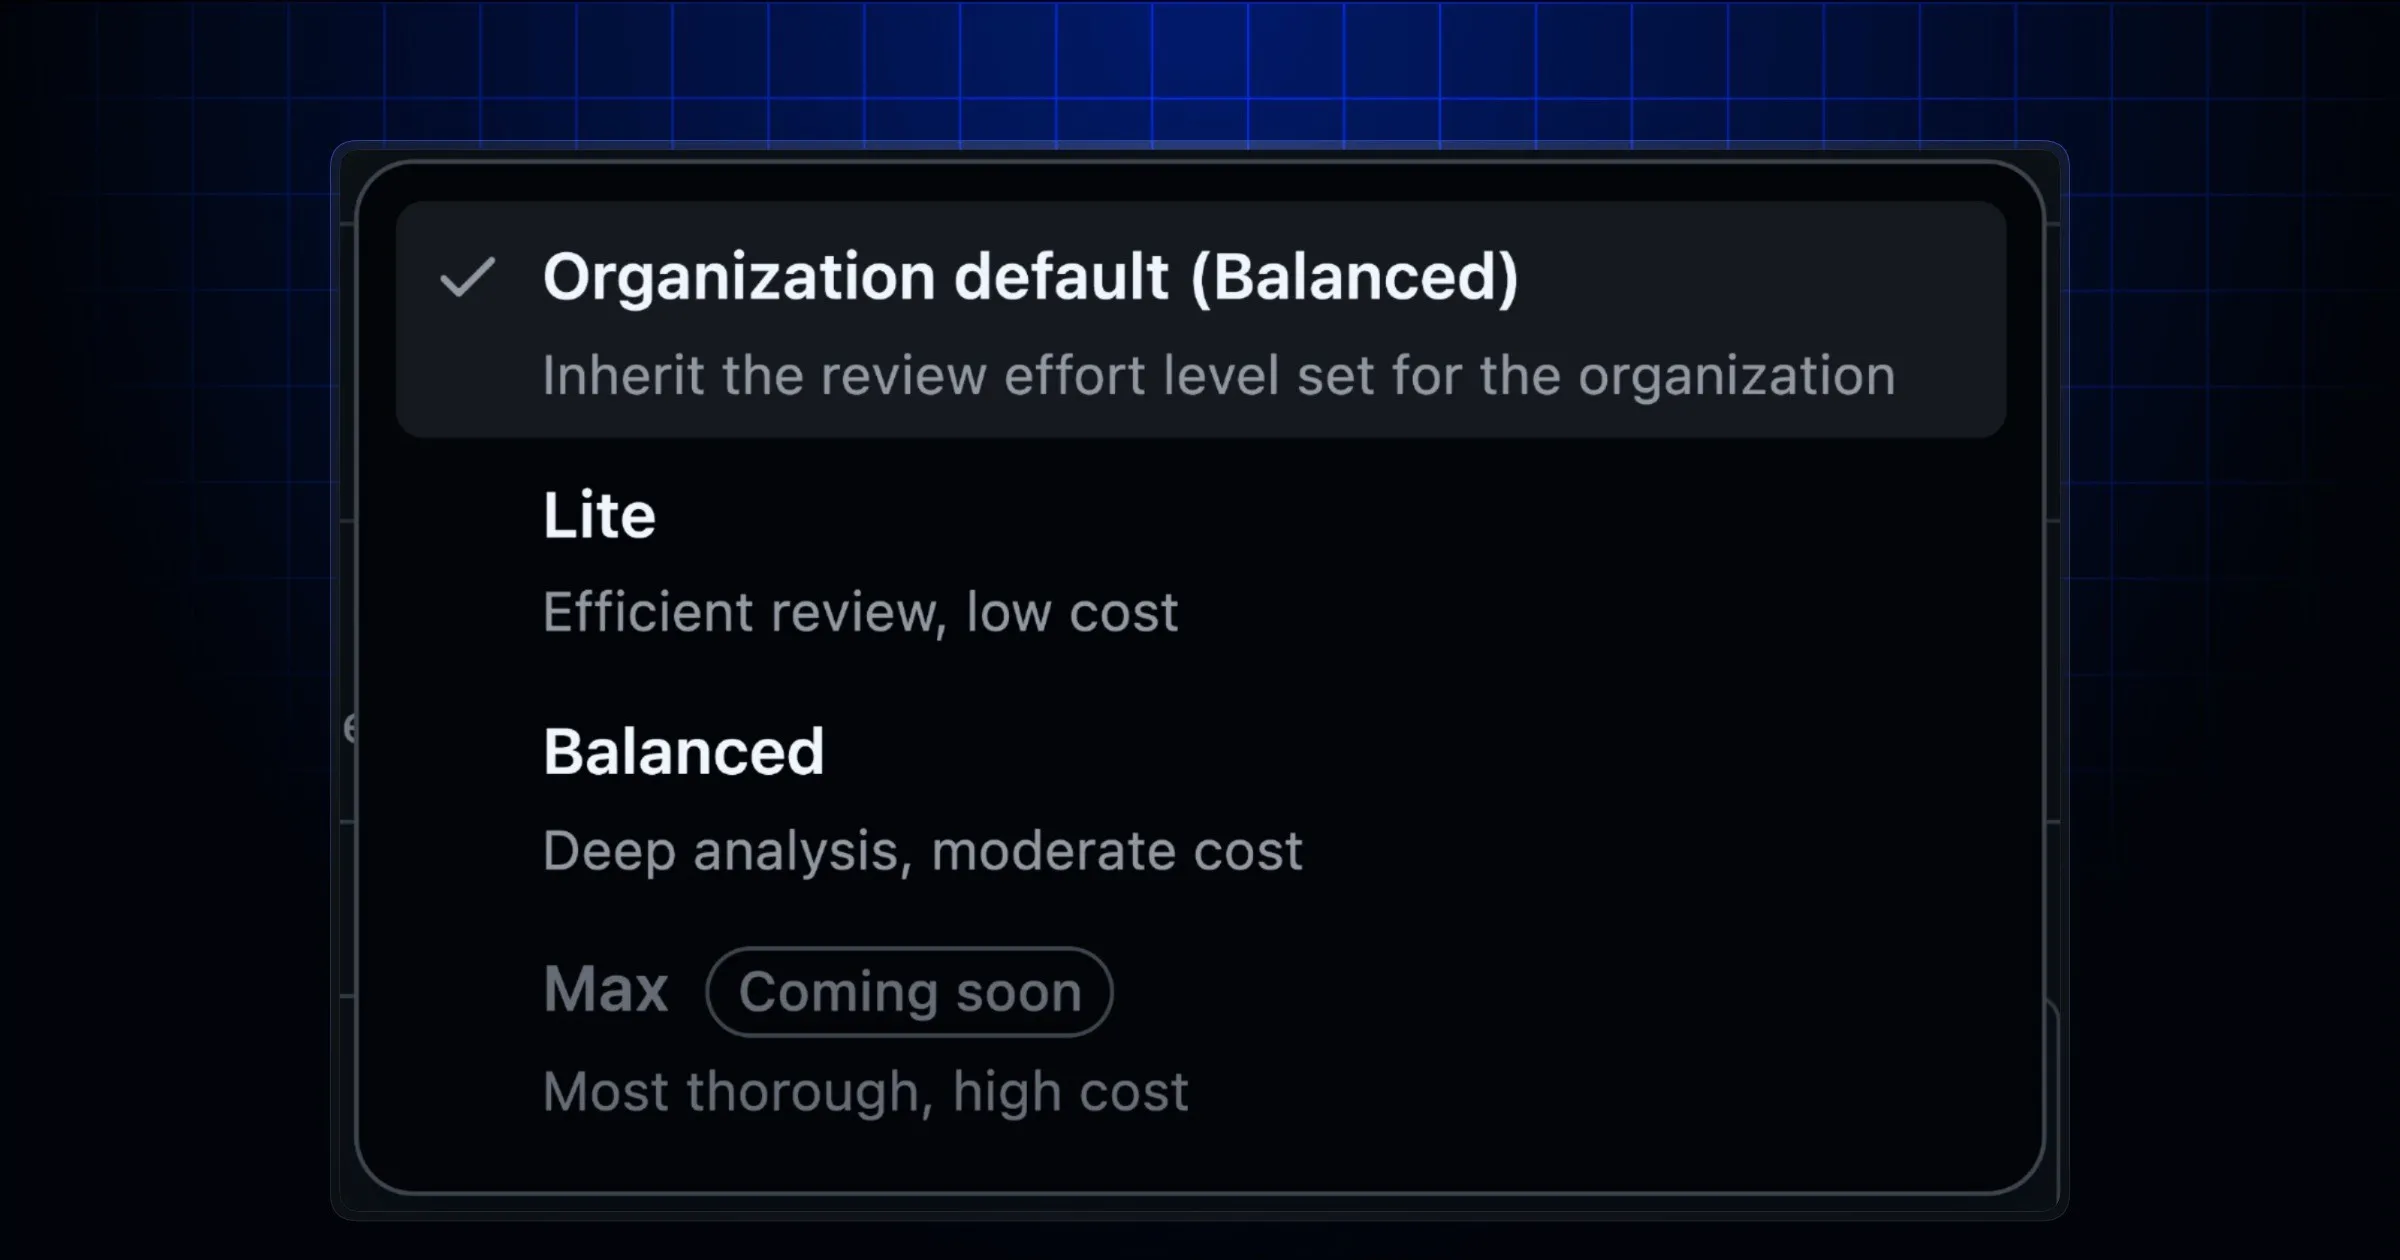
GitHub разрешила запускать проверку pull request’ов Copilot через REST и GraphQL API. Одновременно для новых и уже существующих репозиториев стандартным уровнем тщательности стал Balanced.