DeepSeek открыла свой движок инференса — но не весь сервер
DeepSeek открыла исходный код DeepInfer — фреймворка инференса, который, по заявлению компании, используется в её высоконагруженных продуктах. Для разработчиков это редкий случай: наружу вышел не очередной API-обёрток, а часть производственного контура, отвечающая за запуск и выдачу ответов модели.
Репозиторий опубликован под Apache 2.0. Сейчас он поддерживает только DeepSeek-V4.1-Flash; среди заявленных возможностей — параллельная обработка, асинхронное планирование пакетов, структурированный вывод по JSON Schema и детерминированная выборка. Первичный источник — репозиторий DeepInfer.
Что именно можно забрать
DeepInfer предназначен для офлайн-инференса и включает оптимизированные ядра, рантайм модели и семплера, а также механизмы распределения работы между ускорителями. В документации отдельно упомянуты NVIDIA SM100 и Huawei Ascend 950.
Однако это не готовый «сервер DeepSeek у себя». В README прямо перечислены недостающие части полного сервиса: система KV-кэша, раздельные этапы prefill/decode и балансировка между репликами. Нужны также Linux, Python 3.12, GCC 13+, а для NVIDIA — CUDA 13. То есть проект скорее даёт инженерам основу для экспериментов и сборки собственного контура, чем кнопку для быстрого запуска.
Производственный код без магии
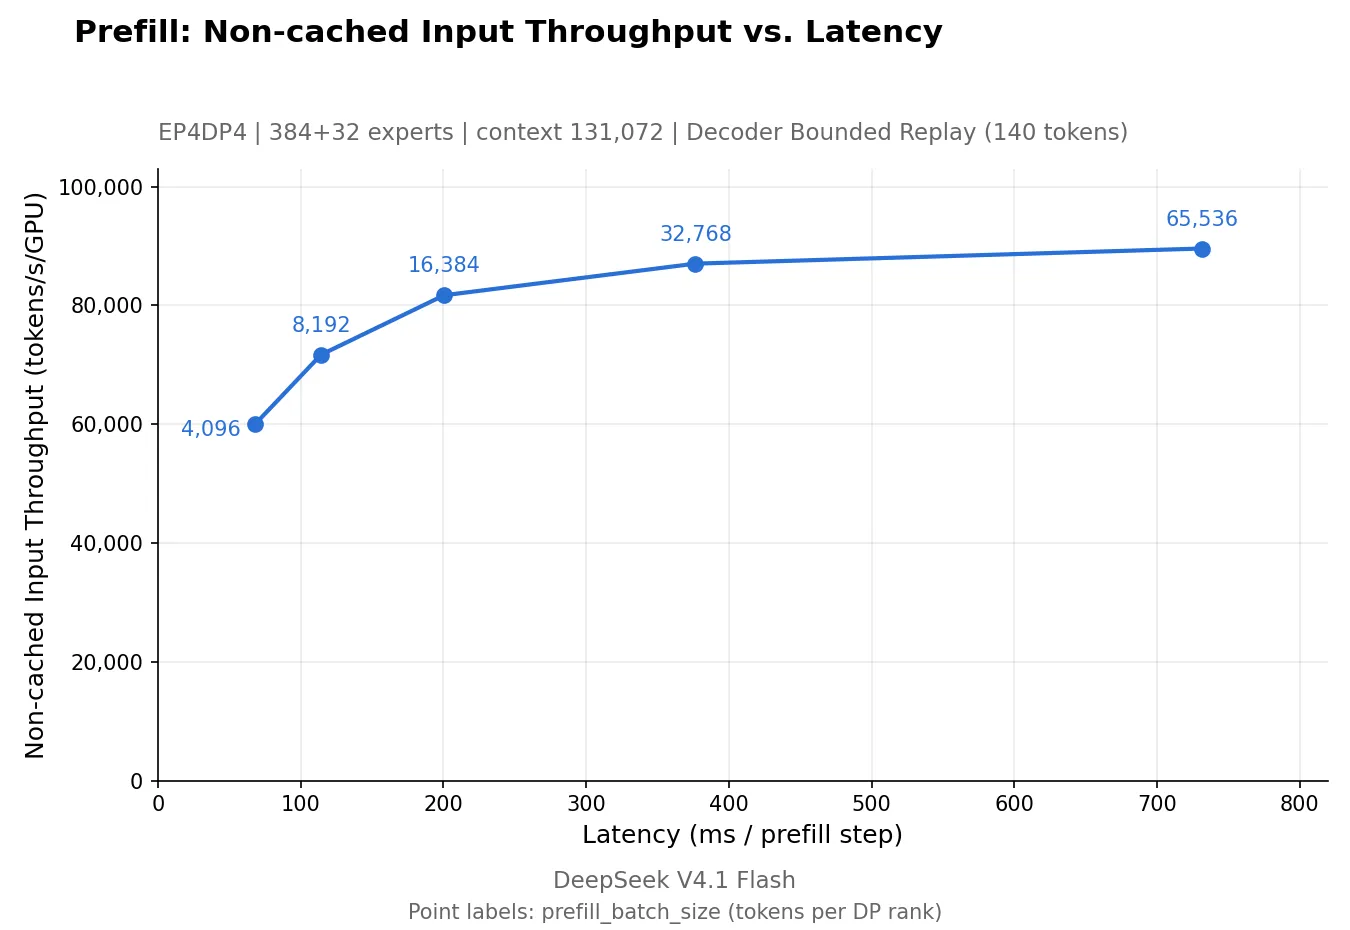
DeepSeek приложила графики пропускной способности и задержки для предзаполнения контекста и генерации токенов. Компания указывает, что тесты prefill проводились на четырёх SM100, а decode — на 64 ускорителях в одном scale-up-домене. Эти результаты нельзя переносить на одиночную видеокарту или обычный сервер, но они показывают, на какой масштаб нацелен проект.
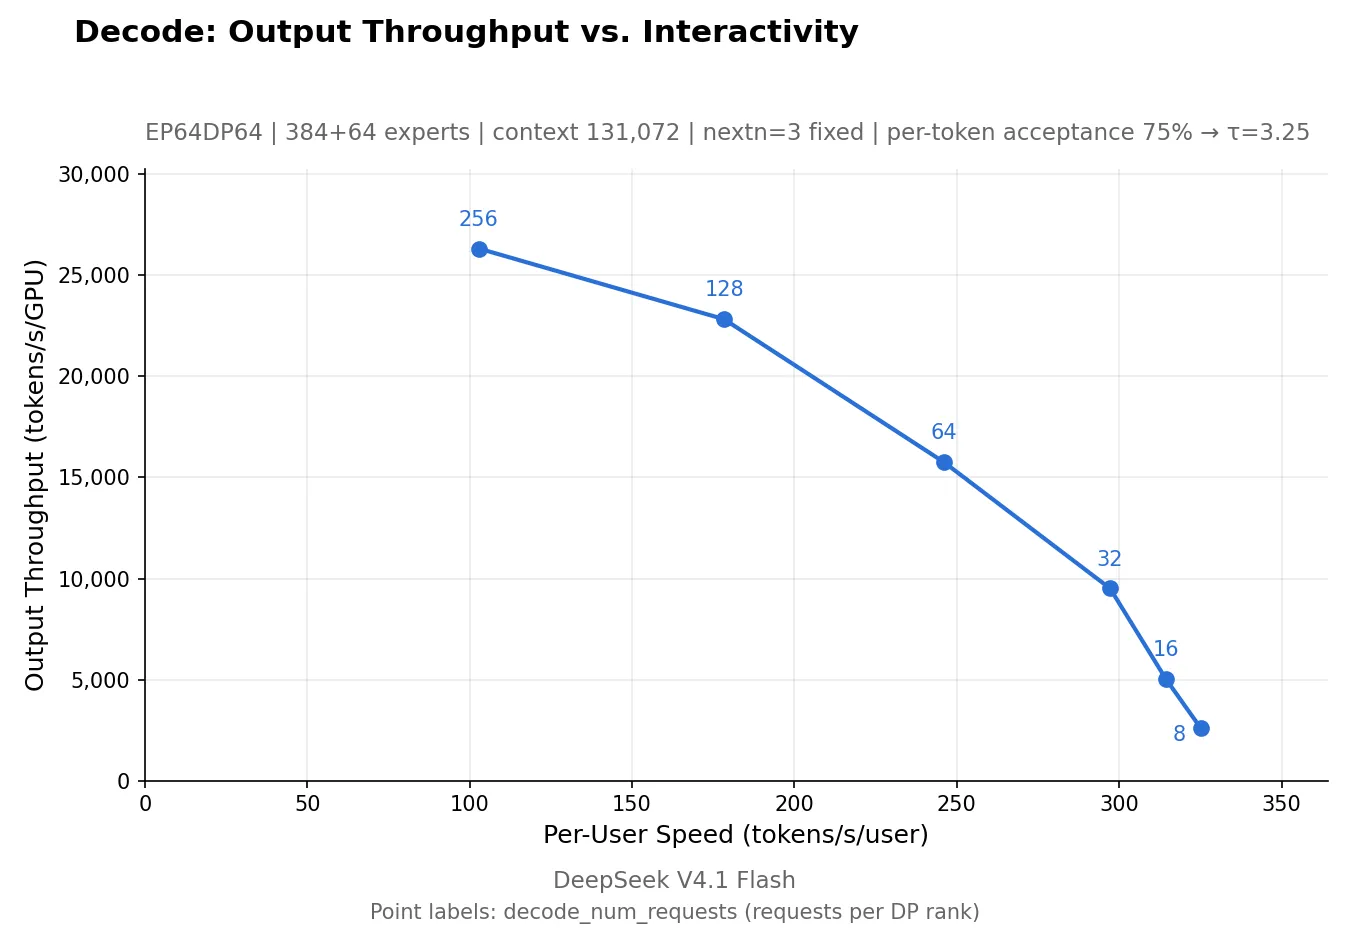
График: DeepSeek, DeepInfer.
Практический смысл открытия — не в обещании мгновенно удешевить запуск моделей. Оно позволяет изучить конкретные решения DeepSeek вокруг планировщика, параллелизма и воспроизводимой генерации — и проверить, какие из них переживут перенос в собственную инфраструктуру.