Назад
22 мая 2026 г. в 15:00 AI DeepSeek API Models China Pricing DeepSeek API Docs

DeepSeek оставит 75% скидку на API после промо
DeepSeek оставит 75% скидку на API после промо

DeepSeek указала в официальной документации, что 75-процентная скидка на API для deepseek-v4-pro не закончится как обычная промоакция. После 31 мая 2026 года цена модели будет «официально скорректирована» до четверти от прежнего уровня: $0,435 за 1 млн входных токенов при cache miss, $0,003625 при cache hit и $0,87 за 1 млн выходных токенов.

Для обычного пользователя это звучит как бухгалтерия. Для разработчика, который строит агентов, аналитические пайплайны, поиск по документам или автоматизацию с длинным контекстом, это очень конкретная новость: одна из самых заметных китайских моделей пытается забрать не внимание, а рабочую нагрузку.

Что именно подешевело

В таблице DeepSeek deepseek-v4-pro описана как модель с контекстом до 1 млн токенов, поддержкой режима рассуждения, JSON-вывода, вызовов инструментов, автодополнения диалогового префикса и дописывания кода в обычном режиме. Это не нишевая демка для чата, а набор возможностей, который нужен для прикладных сценариев: работы с большими документами, кодом, внутренними базами знаний и агентными цепочками.

Снижение цен особенно важно для задач, где стоимость быстро растет из-за длинного ввода и множества промежуточных вызовов. Агент, который читает репозиторий, проверяет документы или делает серию вызовов инструментов, тратит не один красивый запрос, а десятки и сотни операций. В таких сценариях разница между «дорого, но можно протестировать» и «достаточно дешево, чтобы встроить в продукт» часто решает судьбу проекта.

DeepSeek отдельно отмечает, что для всех моделей цена cache hit уже снижена до одной десятой от стартовой. Это бьет ровно в практические сценарии с повторяющимся контекстом: корпоративные инструкции, кодовая база, справочник, история клиента или память агента могут кэшироваться и удешевлять последующие запросы.

Почему это важнее обычной скидки

На этой неделе Techmeme также вынесло сообщение Bloomberg о том, что DeepSeek продвигает раунд финансирования примерно на $10 млрд, а менеджмент говорит инвесторам о приоритете фундаментальных исследований над быстрой коммерциализацией. В связке с постоянным снижением API-цен это выглядит как понятная стратегия: сначала сделать модель массовой инфраструктурой, а уже потом монетизировать поверх масштаба.

Для западных провайдеров это неприятная форма конкуренции. Пользователи сравнивают модели не только по лидербордам, но и по тому, сколько стоит реальный рабочий процесс: прогнать тысячу документов, держать агента в длинной сессии, автоматически проверять код или обрабатывать клиентские обращения. Если качество достаточно близко, цена начинает менять архитектурные решения.

Кому стоит следить

Разработчикам и компаниям, которые уже платят за API, стоит пересчитать не один запрос, а полный рабочий процесс: входной контекст, кэш, число вызовов инструментов, выходные токены и повторные проходы. Именно там дешевые модели обычно оказываются не «заменой ChatGPT», а экономическим слоем для фоновых задач, где важна цена за объем.

Но низкая цена не отменяет обычные вопросы: надежность, приватность, юрисдикция, задержки, совместимость с инструментами и качество на конкретном языке или домене. DeepSeek усиливает ценовое давление на рынок, но не снимает с команд обязанность тестировать модель на своих данных.

Главный вывод простой: гонка моделей снова перешла из презентаций в прайс-листы. И если 2025 год показал, что открытые и китайские модели могут догонять по качеству, то 2026-й все чаще показывает другую ставку: кто сделает интеллект достаточно дешевым, чтобы его стали использовать везде.

Ещё новости

AWS добавила в Textract ИИ-проверку полей по страницам документа
21 ноября 2026 г.
AWS добавила в Textract ИИ-проверку полей по страницам документа

Amazon Textract Insights извлекает поля из смешанных пакетов документов и возвращает для каждого значения оценку уверенности и привязку к странице. AWS позиционирует сервис как способ автоматизировать обработку без отказа от проверки человеком.

Математик Anthropic заявил о доказательстве гипотезы Римана с Claude
20 ноября 2026 г.
Математик Anthropic заявил о доказательстве гипотезы Римана с Claude

Математик Anthropic Левент Альпёге заявил, что вместе с Claude получил формальное доказательство гипотезы Римана и её обобщения. Код на Lean уже скомпилировался у независимого математика, но математическому сообществу ещё предстоит разобрать и подтвердить сам результат.

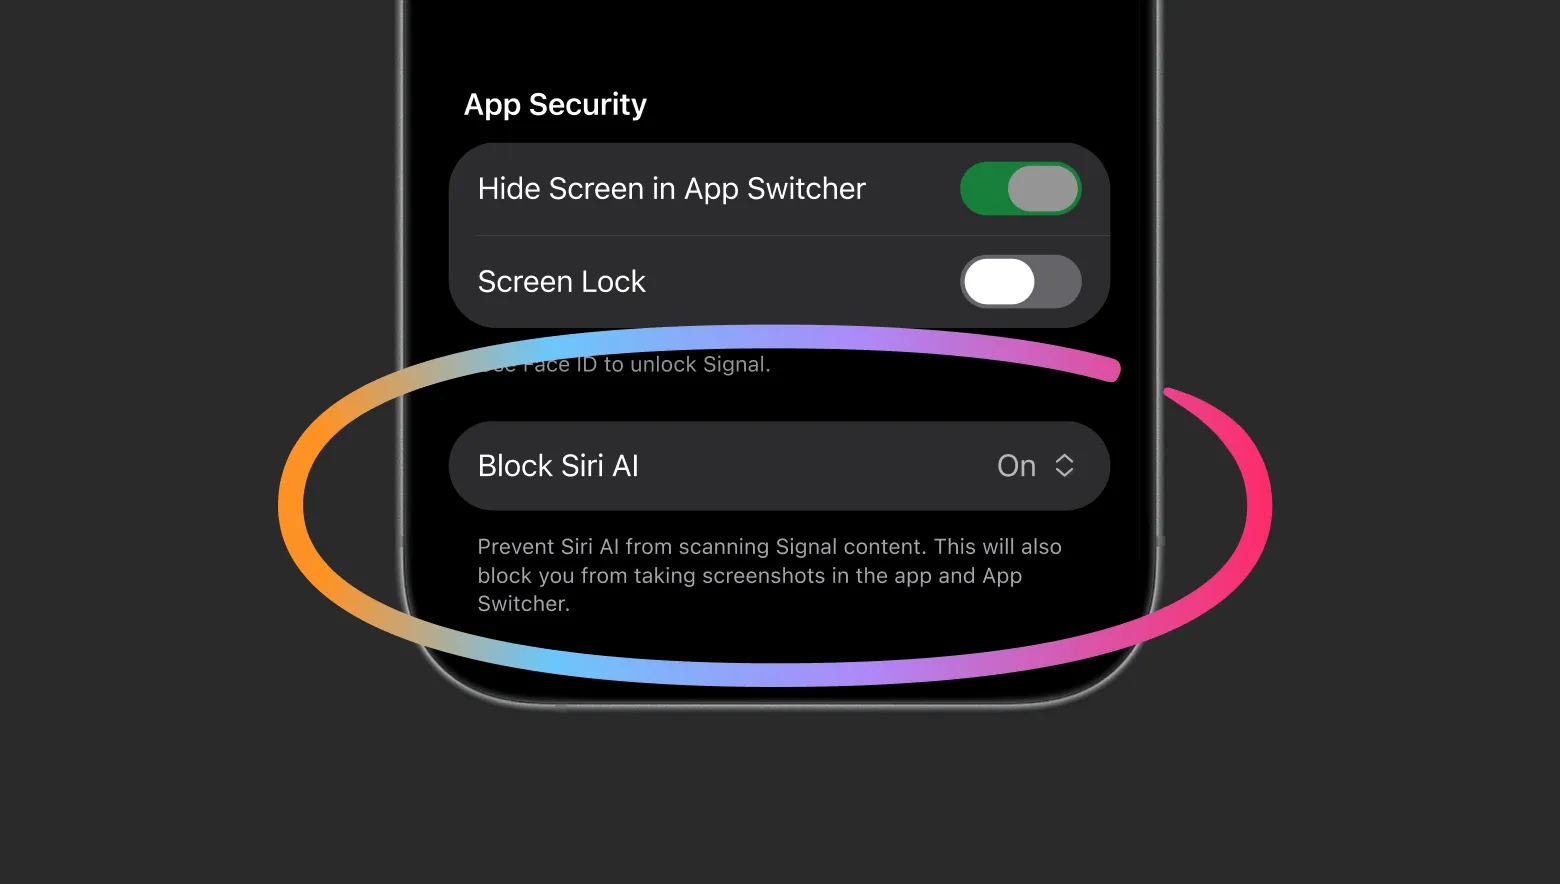
Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты
20 ноября 2026 г.
Signal блокирует захват экрана, чтобы ИИ-агенты не читали чаты

Signal вводит защиту от захвата экрана на iOS 27 и при обнаружении ИИ-помощника на Android. Мессенджер предупреждает: мера не закрывает все пути доступа и на macOS пока не работает.

В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты
20 ноября 2026 г.
В отчёте Reco — восемь захваченных аккаунтов Microsoft 365 за минуты

В отчёте Reco описан инцидент с восемью захваченными аккаунтами Microsoft 365: после кражи сессии злоумышленники быстро меняли правила почты. Компания не утверждает, что атаку выполнил ИИ — и это важная граница для интерпретации.

DeepMind описал четыре пути от AGI к сверхинтеллекту
20 ноября 2026 г.
DeepMind описал четыре пути от AGI к сверхинтеллекту

Исследователь Google DeepMind Тим Генвейн предлагает смотреть на переход от человеческого уровня ИИ к сверхинтеллекту как на набор проверяемых технических сценариев. Это не прогноз сроков, а карта возможных ускорителей и ограничений.

Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены
19 ноября 2026 г.
Google выпустила Gemini 4 Neon: скорость Carbon за 60% цены

Google представила Gemini 4 Neon — модель для сложных задач в коде, офисной работе и науке. Компания заявляет качество уровня Gemini 4 Carbon при трёхкратной скорости и 60% стоимости; проверять это стоит на собственных задачах.

GitHub открыла протокол для сессий AI-агентов между устройствами
19 ноября 2026 г.
GitHub открыла протокол для сессий AI-агентов между устройствами

GitHub описала открытый Agent Host Protocol: он сохраняет состояние AI-агента при переходе между VS Code, Copilot, телефоном и облаком. Это не новый агент, а общий способ подключать клиентов к уже работающей сессии.

Google представила Stitch Loop для непрерывной доработки приложений
19 ноября 2026 г.
Google представила Stitch Loop для непрерывной доработки приложений

Google Labs открыла лист ожидания Stitch Loop — агента, который подключается к коду и рабочим метрикам, находит проблемы и готовит pull request’ы. Сливать изменения без проверки человека сервис не должен.

GitHub отсеял 9 791 AI-находку до 99 отчётов для open source
18 ноября 2026 г.
GitHub отсеял 9 791 AI-находку до 99 отчётов для open source

В пилоте GitHub и Microsoft превратили тысячи сигналов AI-сканера в 99 проверенных закрытых отчётов для шести open-source-проектов. К 15 ноября мейнтейнеры исправили 55 из них — но это ранний опыт, а не доказательство универсальной эффективности сканеров.

OpenAI пустит четыре внешние команды внутрь своих систем безопасности
18 ноября 2026 г.
OpenAI пустит четыре внешние команды внутрь своих систем безопасности

OpenAI запускает первую фазу встроенных независимых оценок: Apollo Research, METR, Transluce и Goodfire получат доступ к части внутренних моделей, данных и процессов. Формат обещает больше прозрачности, но независимость публикаций ограничена правом компании скрывать конфиденциальные детали.

Microsoft выпустила MAI Code 2 для GitHub Copilot и Foundry
18 ноября 2026 г.
Microsoft выпустила MAI Code 2 для GitHub Copilot и Foundry

Microsoft представила MAI Code 2 и более быструю MAI Code 2 Flash — собственные модели для повседневной работы с кодом. Основная версия уже доступна в GitHub Copilot и Azure AI Foundry, а Flash в Foundry пока остаётся в ограниченном предпросмотре.

GPT‑6.2 Astra прибавила пять пунктов, но лидером рейтинга остаётся Claude
17 ноября 2026 г.
GPT‑6.2 Astra прибавила пять пунктов, но лидером рейтинга остаётся Claude

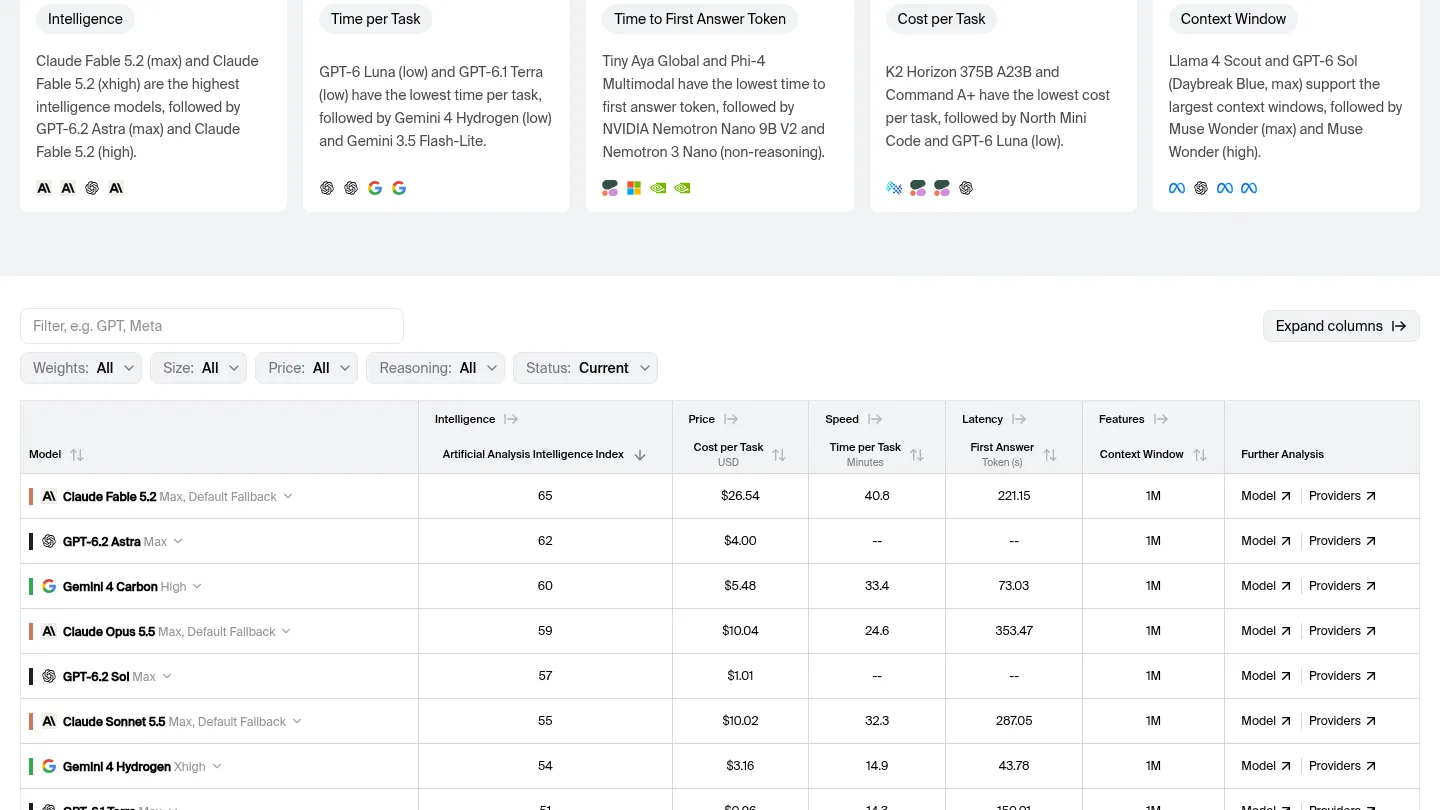
В независимом сводном рейтинге Artificial Analysis GPT‑6.2 Astra получила 62 из 100 — на пять пунктов больше, чем GPT‑6 Astra. Это заметный скачок OpenAI, но первое место остаётся у Claude Fable 5.2 Max с 65 баллами; Sol выросла с 55 до 57.