Китайский LineShine обошел США в TOP500: гонка вычислений для ИИ стала сложнее
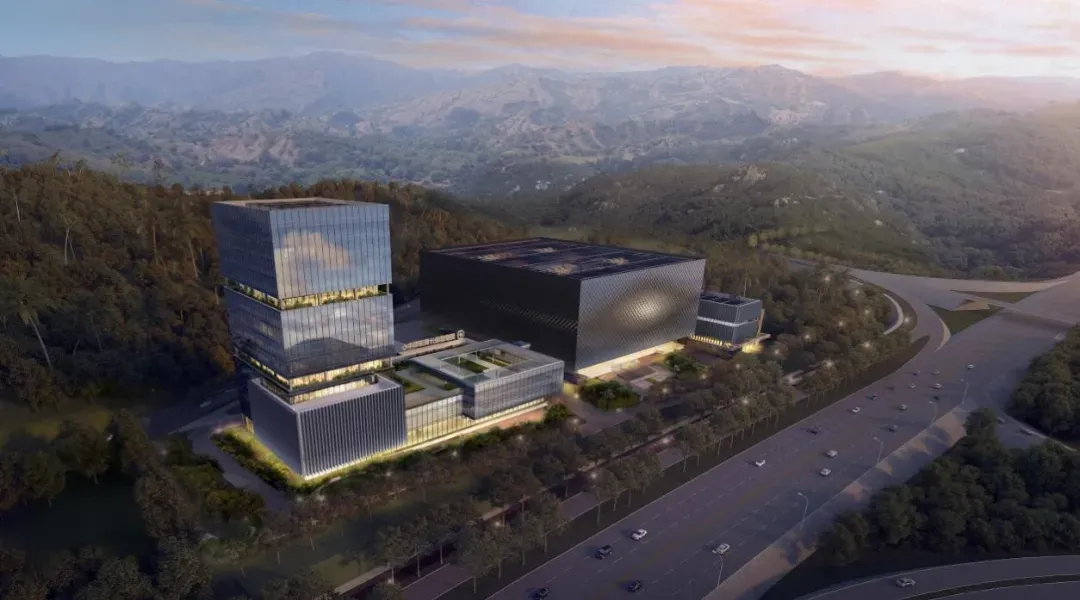
Июньский рейтинг TOP500 принес редкую смену лидера: китайский LineShine впервые вошел в список и сразу занял первое место. По данным TOP500, система в Национальном суперкомпьютерном центре в Шэньчжэне показала 2,198 exaflop/s в тесте High Performance Linpack и более чем на 20% обошла американский El Capitan.
Это первая китайская система на вершине TOP500 со времен Sunway TaihuLight в 2017 году. В цифрах LineShine выглядит как демонстрация масштаба: 13 789 440 ядер, платформа LingKun, процессоры LX2 с 304 ядрами, собственная сеть LingQi и Kylin OS. В рейтинге HPCG, который лучше отражает часть научных нагрузок, LineShine тоже вышел на первое место.
Почему это важно для ИИ
Главная интрига не в национальном счете Китай против США. Reuters верно отмечает: результат не означает, что Пекин автоматически обогнал американские AI-кластеры, построенные вокруг GPU. HPL измеряет один тип высокопроизводительных вычислений, а обучение больших моделей зависит от памяти, сетей, софта, смешанной точности и доступности ускорителей.
Но именно поэтому LineShine интересен. Китай сталкивается с ограничениями на закупку самых мощных GPU и показывает другой маршрут: собрать огромную CPU-ориентированную систему, пригодную для научных расчетов, инженерного моделирования и части AI-нагрузок. Это не замена Blackwell-кластерам один к одному, а попытка снизить зависимость от чужой цепочки поставок.
Что меняется
Для компаний и исследователей вывод простой: «вычисления для ИИ» перестают означать только аренду GPU у нескольких облаков. Рядом с GPU-гонкой растут альтернативные стеки: TPU у Google, специализированные ускорители, суперкомпьютеры для науки и национальные платформы.
LineShine показывает, что инфраструктурная конкуренция будет идти не только за самую быструю видеокарту. Важны контроль над процессорами, сетью, операционной системой, энергопотреблением и доступом к большим машинам. А значит, ИИ-гонка все больше становится гонкой промышленных систем, а не только моделей.