Artificial Analysis запустила индекс для ИИ-моделей, которые принимают решения
Artificial Analysis 13 октября представила Decision Index v1.0 — отдельный рейтинг для моделей решений. Это не универсальные чат-боты: такие модели за один запрос выбирают вариант из заданного набора и возвращают вероятность для каждого варианта. Их целевые задачи — классификация обращений, маршрутизация, оценка риска и решение, нужно ли агенту вызывать инструмент.
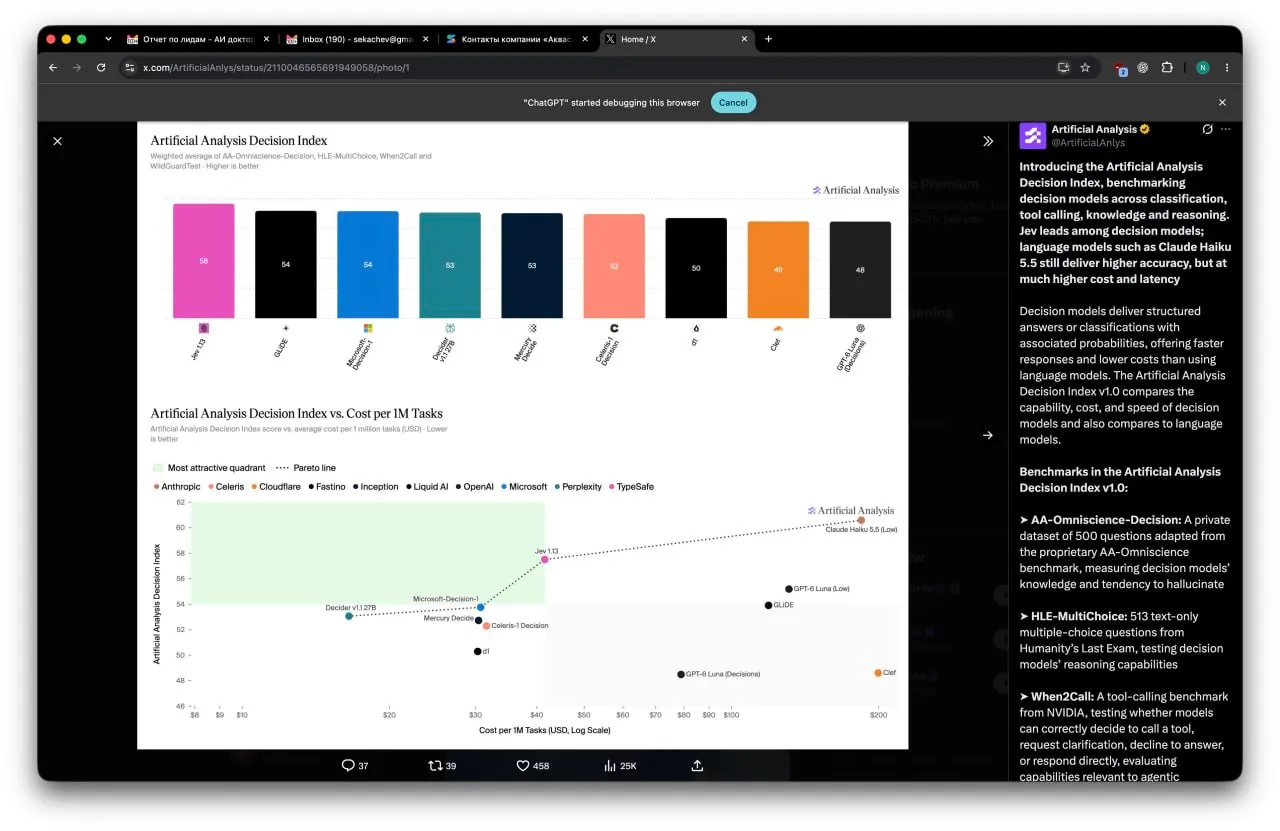
На стартовой таблице лидирует Jev 1.13 с 58 баллами. GLiDE и Microsoft-Decision-1 набрали по 54. Но рейтинг не сводится к одной цифре: он специально показывает компромисс между качеством, стоимостью и временем ответа.
Что именно измеряет индекс
Итоговый балл — взвешенное среднее четырёх оценок. По 25% дают AA-Omniscience-Decision (500 закрытых вопросов о знаниях и галлюцинациях), HLE-MultiChoice (513 текстовых вопросов Humanity’s Last Exam), When2Call от NVIDIA для выбора действия с инструментом и WildGuardTest для классификации безопасности. В первом тесте точность и отказ от ложного ответа делят его вес пополам — по 12,5%.
Для языковых моделей авторы используют фиксированную системную инструкцию, текст задачи и структурированный JSON-ответ. У специализированных моделей берут вариант с наибольшей заявленной вероятностью. Поэтому сравнение ближе к операциям «выбрать, направить, запросить уточнение», а не к написанию длинного текста или многошаговому агенту.
Источник: Artificial Analysis.
Дешевле — не значит умнее
По данным запуска, специализированные модели стоят от $17 до $199 за миллион задач и отвечают за 0,06–0,5 секунды. Jev 1.13 стоит $42 за миллион задач и отвечает за 0,13 секунды; Celeris-1 Decision — 0,06 секунды.
Для сравнения, Claude Haiku 5.5 в режиме Low набрала 61 балл — на три больше Jev, но авторы оценивают её в $184 за миллион задач и 1,4 секунды на задачу. Это 4,4 раза дороже и примерно в 11 раз медленнее Jev в данной методике. Зато на проверке знаний AA-Omniscience-Decision Claude получила 52 против 35 у Jev. На вызове инструментов и классификации разрыв меньше.
Главная оговорка
Это рейтинг Artificial Analysis, а не независимый стандарт отрасли: один из четырёх наборов, AA-Omniscience-Decision, закрытый и создан на основе собственного бенчмарка компании. Веса тестов тоже задаёт составитель. Кроме того, сама команда отмечает завышенную уверенность почти всех проверенных моделей решений: на задачах знаний и рассуждений реальная точность обычно ниже заявленной вероятности.
Поэтому Decision Index полезен как фильтр для выбора кандидатов на массовые одношаговые решения. Перед внедрением всё равно нужен тест на собственных данных, особенно если ошибка влияет на деньги, доступ пользователя или безопасность.