Anthropic: Claude ведёт 26% исследований моделей
Anthropic впервые опубликовала цифры о том, насколько её собственный Claude участвует в разработке следующих ИИ-моделей. В новом материале компании сказано: на август 2026 года Claude «ведёт» 26% измеренных задач AI R&D — то есть способен выполнить большую часть работы по задаче от общего указания, пока человек наблюдает за процессом.
Это не означает, что Claude самостоятельно создаёт своего преемника. Anthropic прямо пишет, что в ни одной из измеренных категорий он не работает полностью автономно. Но более 90% работы уже находится на уровне «ИИ сотрудничает» или выше: модель берёт на себя крупные фрагменты задач под плотным человеческим руководством.
Не один красивый процент
Компания собрала прототип индекса автоматизации: перечислила виды работ в исследованиях и разработке, оценила автоматизацию каждой и свела оценки вместе. Самая интересная часть отчёта — не 26%, а попытка предложить единый язык для наблюдения за тем, как лаборатории используют ИИ для ускорения ИИ.
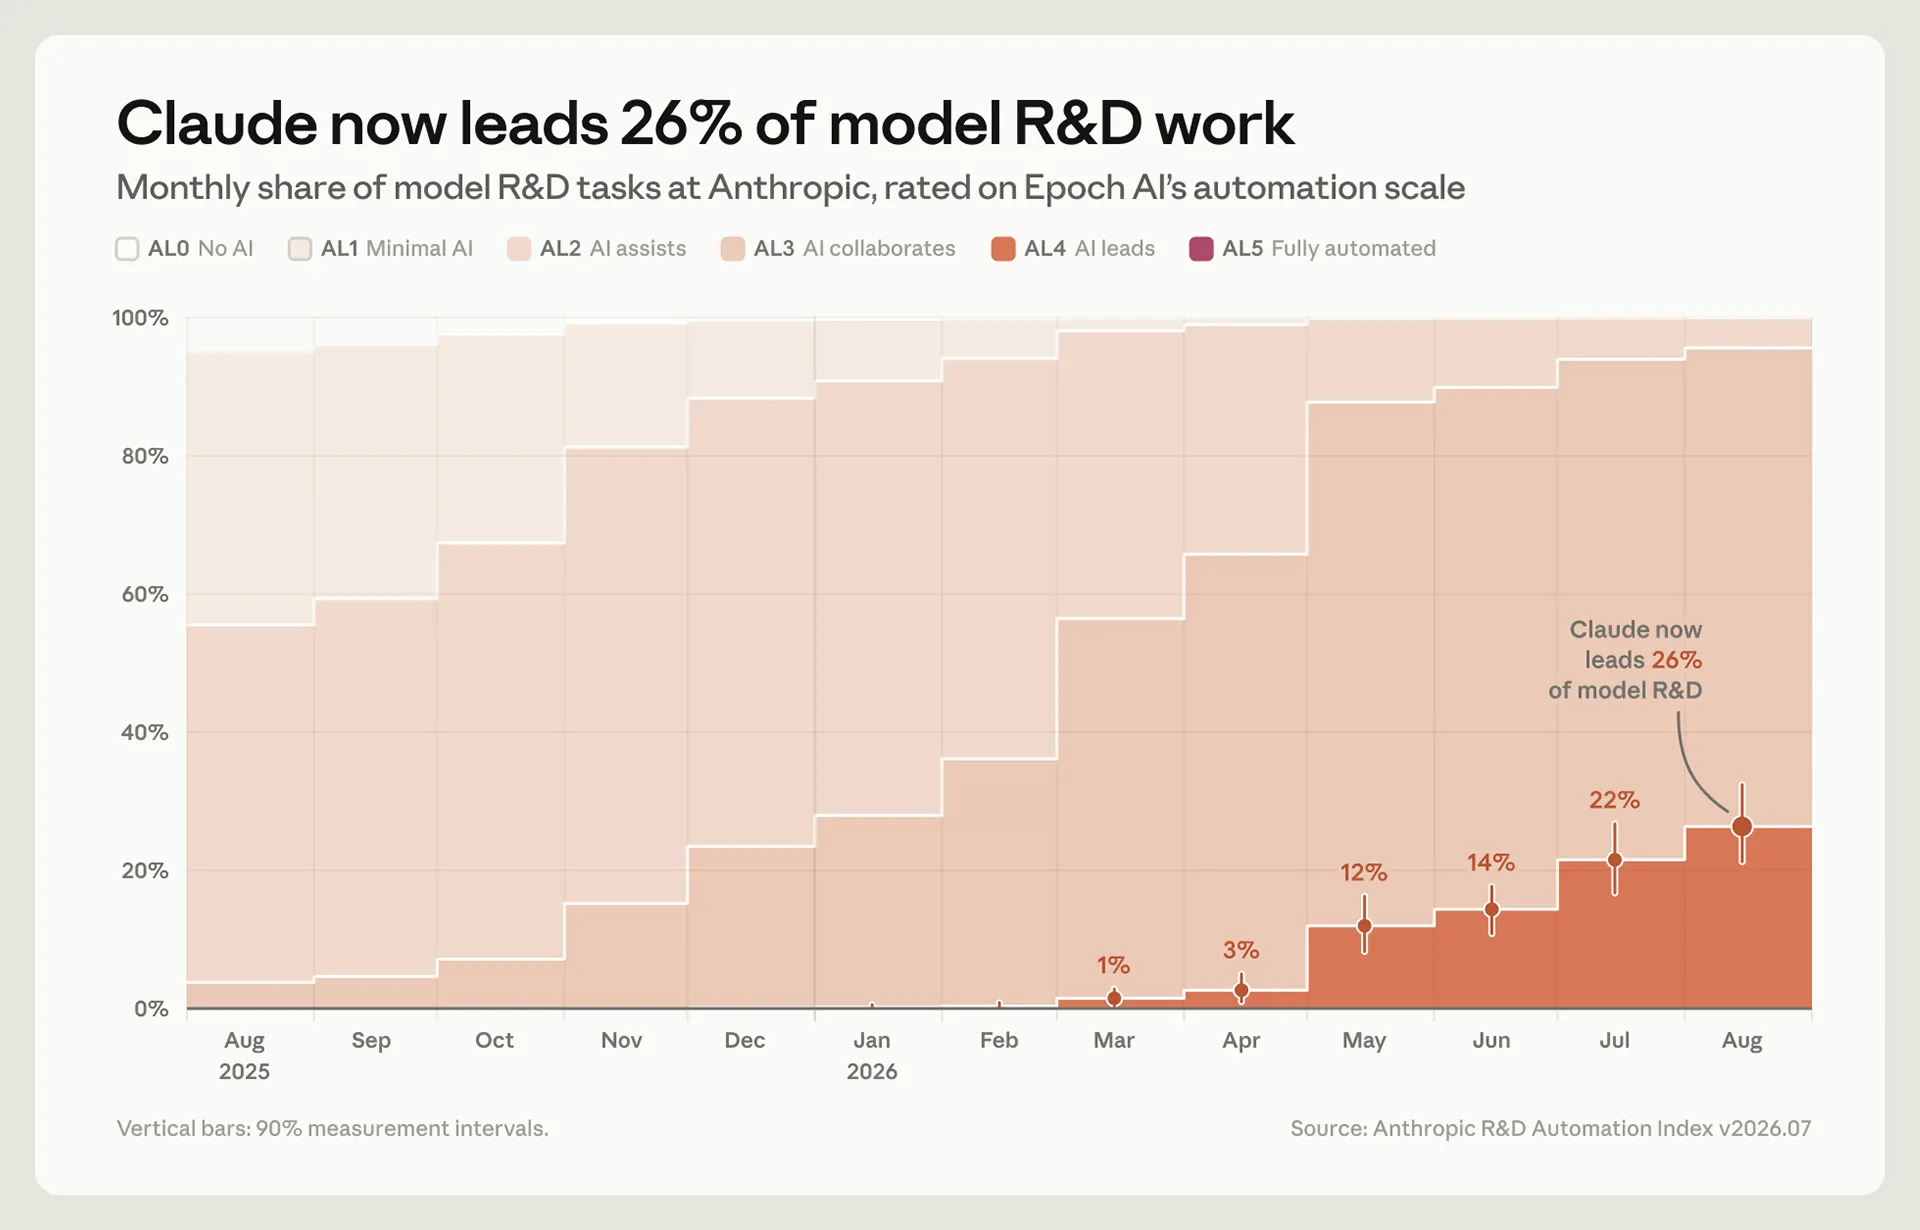
График: Anthropic.
Во внутренней наиболее используемой платформе Anthropic одновременно работают примерно 30 000 агентов для исследований и инженерных задач. Компания заявляет, что все их действия проходят через онлайн-монитор до исполнения и попадают в офлайн-монитор после него. За август монитор заблокировал около 0,002% — примерно одно из 47 000 — решений агентов; это собственные данные компании, а не независимый аудит.
Что это меняет
Для команд, внедряющих агентные инструменты, отчёт полезнее как список метрик, чем как рекламный успех Claude. Anthropic предлагает измерять покрытие мониторингом, задержку проверки и долю заблокированных либо эскалированных действий. Именно эти показатели позволяют отличить «агенту дали доступ» от контролируемого процесса.
Есть и важная оговорка: методику пока нельзя сравнить между лабораториями, а оценки Anthropic частично опираются на её же модели. Компания предлагает внешнюю проверку и публикацию методики. Пока этого нет, 26% — содержательный снимок одной лаборатории, но не универсальная шкала рынка.
Если такие отчёты станут регулярными и сопоставимыми, обсуждение риска агентов наконец сдвинется от общих обещаний к проверяемым вопросам: сколько работы они реально делают, кто видит их действия и как быстро человек может вмешаться.