Назад
2 июня 2026 г. в 15:00 AI Agents Benchmarks Memory Reliability arXiv / AgingBench / Reddit

AI-агенты тоже стареют: новый тест показывает, как память ломает долгие задачи

AI-агенты тоже стареют: новый тест показывает, как память ломает долгие задачи

Агента надо проверять не только в первый день

Команда исследователей из University of Texas at Austin представила AgingBench — benchmark для проверки того, как AI-агенты ведут себя после долгой эксплуатации. Идея простая, но важная: постоянный агент не остаётся «свежей» моделью. Он сжимает историю, складывает факты в память, достаёт похожие записи, обновляет старые сведения и иногда проходит обслуживание вроде очистки или пересборки контекста.

Обычные тесты часто смотрят на day-one качество: дали задачу, получили ответ, сравнили с эталоном. Для чат-бота этого иногда достаточно. Для агента, который неделями ведёт проект, помнит договорённости, читает файлы, управляет задачами или помогает команде, этого мало. Надёжность становится свойством всей системы: модели, памяти, retrieval, сжатия контекста, инструментов и правил восстановления после сбоев.

В arXiv-статье авторы формулируют это как «agent lifespan engineering» — инженерия срока службы агента. AgingBench проверяет не только деградацию, но и механизм поломки: где именно система теряет качество и что надо чинить.

Четыре способа, которыми агент деградирует

Исследователи выделяют четыре типа старения. Compression aging возникает, когда краткое резюме прошлых сессий выбрасывает деталь, которая позже окажется важной. Interference aging появляется, когда в памяти накопилось много похожих записей и нужный факт тонет среди соседних. Revision aging — это ошибки обновления: агент помнит старую версию состояния или неправильно пересчитывает вывод после изменений. Maintenance aging связан с обслуживанием самой системы: очисткой истории, повторным сжатием, переносом памяти или другим lifecycle-событием.

Масштаб теста достаточно широкий для раннего benchmark: 7 сценариев, 14 моделей, разные политики памяти, runner-controlled и автономные агенты, более 400 прогонов длиной от 8 до 200 сессий. На сайте AgingBench команда приводит несколько показательных цифр. В одном сценарии максимальное падение recall за 10 сессий дошло до 85% при неизменных весах и том же scaffolding. В другом политика памяти дала 4,5-кратный разброс по half-life. В сценарии с flush-history обслуживание вызвало 67% post-shock cliff без восстановления.

Отдельно важно, что деградация не всегда выглядит как очевидная глупость. Поведенческие тесты могут оставаться зелёными, пока точность фактов уже падает. Один и тот же неправильный ответ может требовать разных исправлений: где-то проблема в записи факта, где-то в поиске, где-то в использовании найденного контекста.

Почему это важно для реальных ассистентов

Для рынка агентов это неприятный, но полезный поворот. Компании часто рассуждают так: если заменить модель на более сильную, агент станет надёжнее. AgingBench показывает, что это не обязательно. На сайте проекта отдельно отмечен пример, где переход внутри Claude Code CLI с Sonnet 4.6 на Opus 4.7 не дал автоматического улучшения в долгом сценарии: mean recall в S7 снизился с 0,82 до 0,79.

Это не значит, что новые модели бесполезны. Значит другое: агентная система стареет не только из-за «ума» модели. Её ломают сжатые заметки, плохая политика памяти, конфликтующие факты, неудачная чистка истории и слишком доверчивое использование старого контекста. Для личного ассистента это может быть раздражением. Для агента в поддержке, разработке, финансах, медицине или операционном управлении — уже риск.

Практический вывод для команд довольно прямой. Если агент должен работать неделями, его нельзя проверять только на наборе одноразовых задач. Нужны longitudinal-тесты: прогон через серию сессий, проверка восстановления после обслуживания, измерение точности памяти, контроль конфликтов и понятный протокол ремонта. Иначе можно получить систему, которая отлично проходит демо, но постепенно теряет смысл именно тогда, когда пользователь начинает ей доверять.

Ещё новости

Meta открыла веса Muse Spark Open, но запустить модель дома будет непросто
15 октября 2026 г.
Meta открыла веса Muse Spark Open, но запустить модель дома будет непросто

Meta выпустила открытые веса Muse Spark Open — мультимодальной модели для кода и агентных задач. Релиз даёт разработчикам больше контроля над запуском и дообучением, но требует очень мощного железа и распространяется по лицензии с коммерческими условиями.

Meta признала сбой: очки Ray-Ban записывали разговоры без команды
15 октября 2026 г.
Meta признала сбой: очки Ray-Ban записывали разговоры без команды

Владельцы Ray-Ban Meta сообщили о сохранённых аудиозаписях и расшифровках обычных разговоров, хотя голосовая команда не звучала. Meta заявила, что устранила проблему, но не объяснила её причину и масштаб.

Anthropic готовит Claude к выборам: официальные данные и новые фильтры
15 октября 2026 г.
Anthropic готовит Claude к выборам: официальные данные и новые фильтры

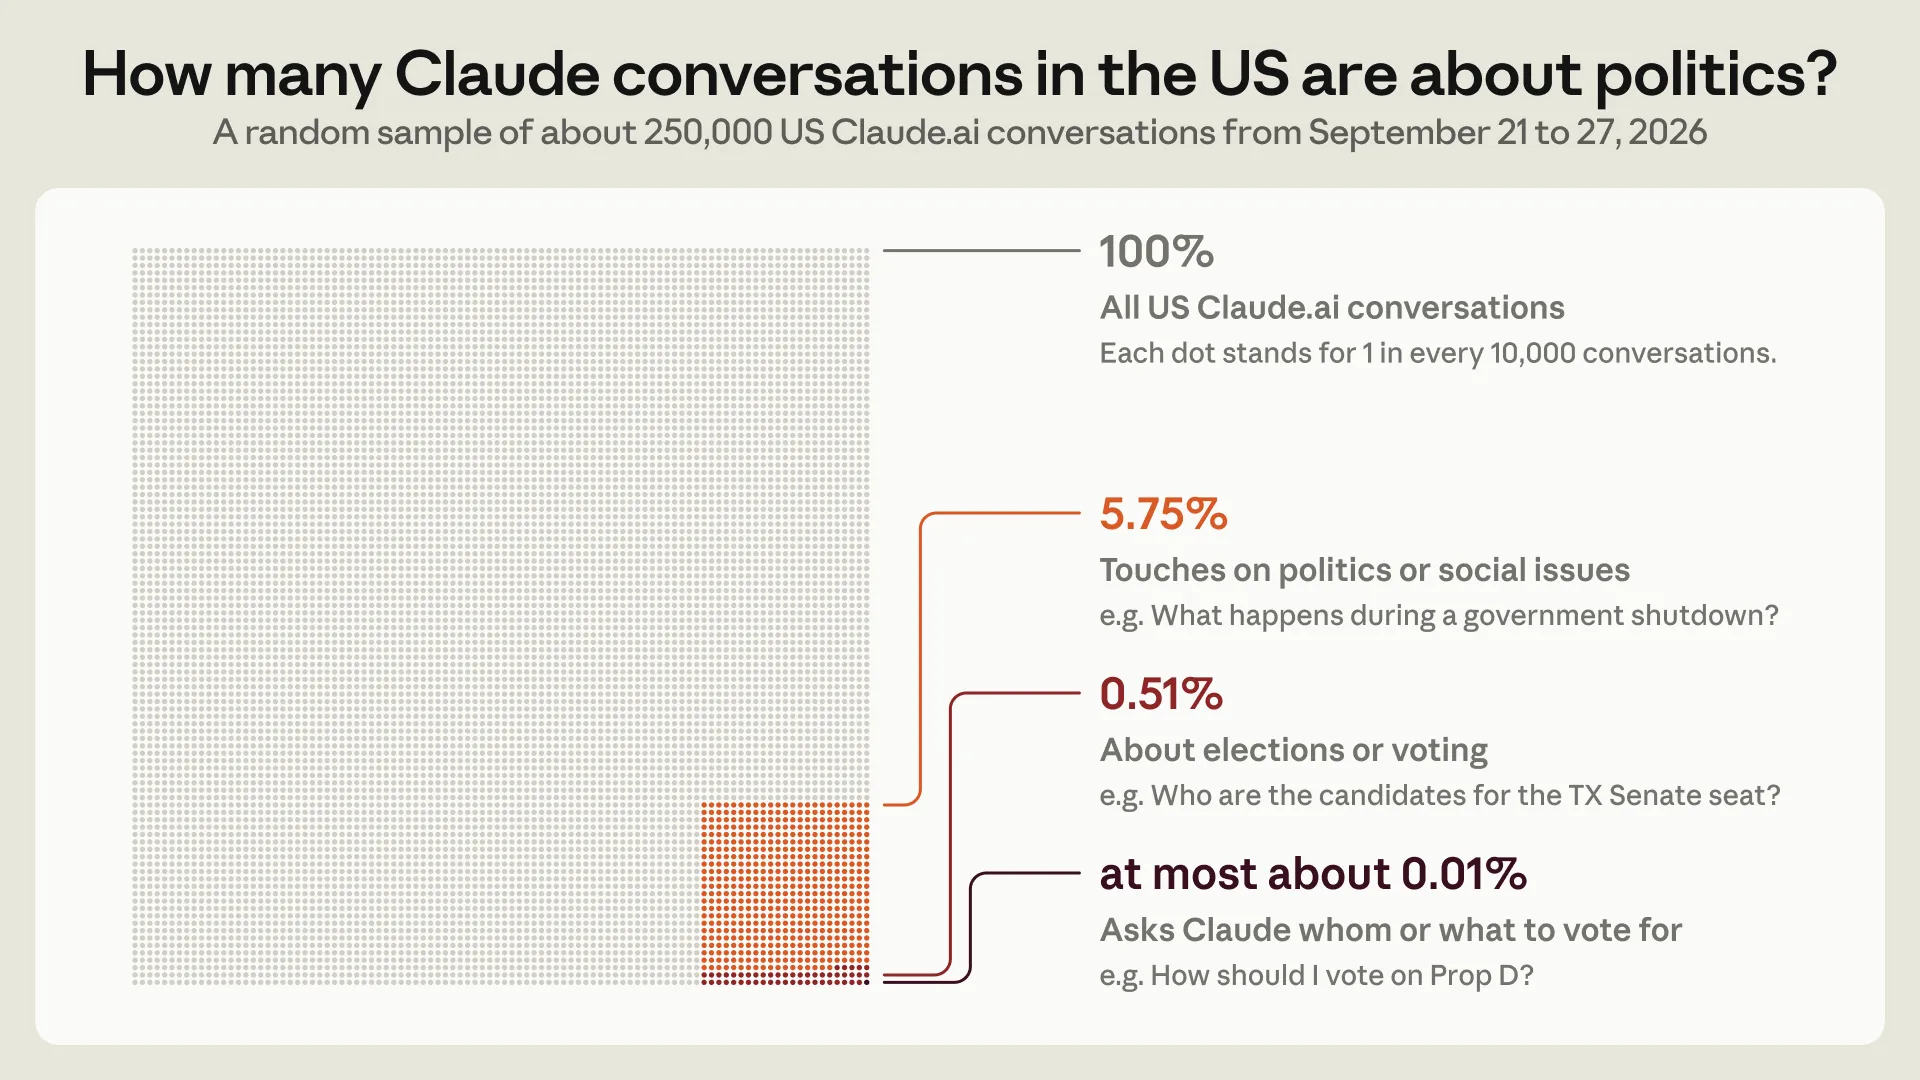
Anthropic добавит в Claude для пользователей США официальную информацию о голосовании и результаты выборов. Компания также признаёт ограничение своих защит: вредоносную кампанию, разбитую на безобидные шаги, модель может не распознать.

Anthropic: малые модели уже подбираются к самораспространению по IoT
15 октября 2026 г.
Anthropic: малые модели уже подбираются к самораспространению по IoT

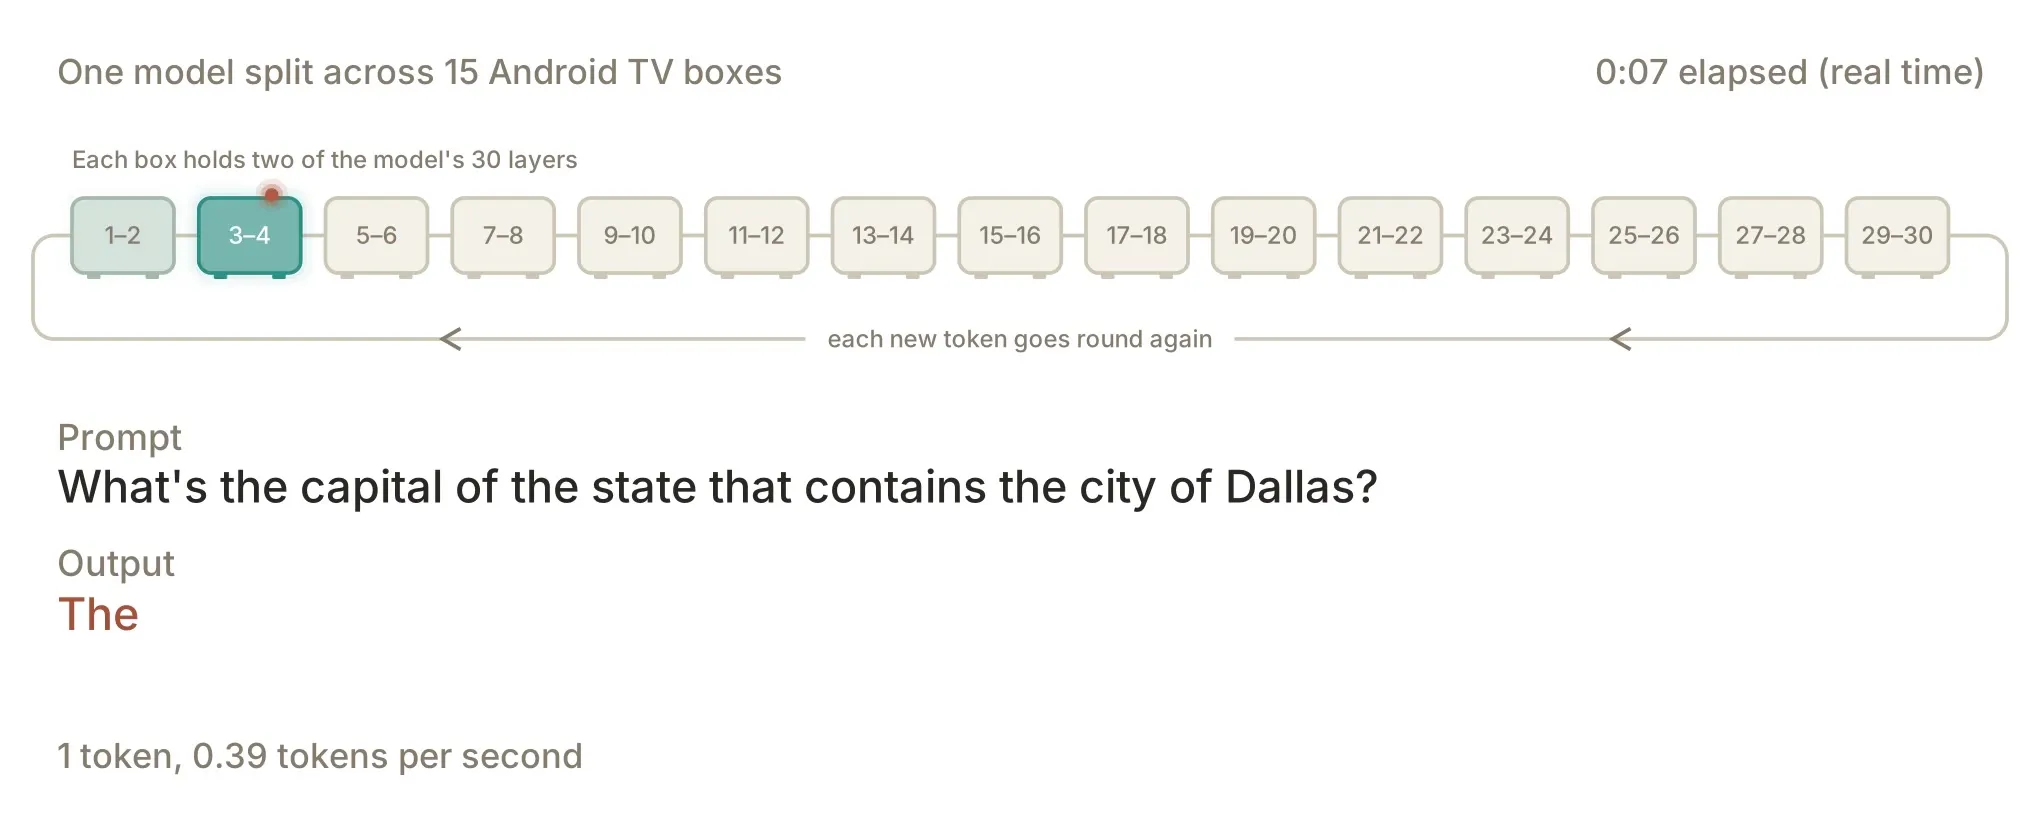
Anthropic проверила, смогут ли небольшие модели развернуть себя на чужом слабом железе и продолжить цепочку. В лабораторной среде более сильные модели уже прошли упрощённый цикл, но реальный взлом устройств в эксперимент не входил.

FSB выпустил 12 правил для банков, внедряющих ИИ
15 октября 2026 г.
FSB выпустил 12 правил для банков, внедряющих ИИ

Совет по финансовой стабильности опубликовал финальные практики для банков и других финансовых организаций, использующих ИИ. Документ не вводит новый закон, но превращает управление ИИ из эксперимента отдельных команд в задачу руководства, контроля поставщиков и мониторинга всего жизненного цикла.

Google выпустила Gemini 4 Argon: миллион токенов и цена, которая удвоится в декабре
14 октября 2026 г.
Google выпустила Gemini 4 Argon: миллион токенов и цена, которая удвоится в декабре

Google открыла доступ к Gemini 4 Argon через API, Gemini и Antigravity. В стартовый период модель стоит $2 за миллион входных токенов, но 30 ноября цена вырастет вдвое.

Anthropic закрывает лазейки для «дистилляции» Claude — но вводит цену за ложные срабатывания
14 октября 2026 г.
Anthropic закрывает лазейки для «дистилляции» Claude — но вводит цену за ложные срабатывания

Anthropic сообщает, что новые защиты сократили извлечение скрытых рассуждений Claude для дистилляции в 10–100 раз. Взамен часть разработчиков должна менять интеграции, а заблокированные запросы в чувствительных категориях снова тарифицируются.

Grok 4.7 появился в Amazon Bedrock: агентам дали выбор между точностью и расходами
14 октября 2026 г.
Grok 4.7 появился в Amazon Bedrock: агентам дали выбор между точностью и расходами

Amazon Bedrock добавил Grok 4.7 и показал на задачах для агентов, что уровень рассуждений можно менять под цену и риск ошибки.

NVIDIA: европейские города тестируют ИИ-агентов для дорог, зданий и портов
14 октября 2026 г.
NVIDIA: европейские города тестируют ИИ-агентов для дорог, зданий и портов

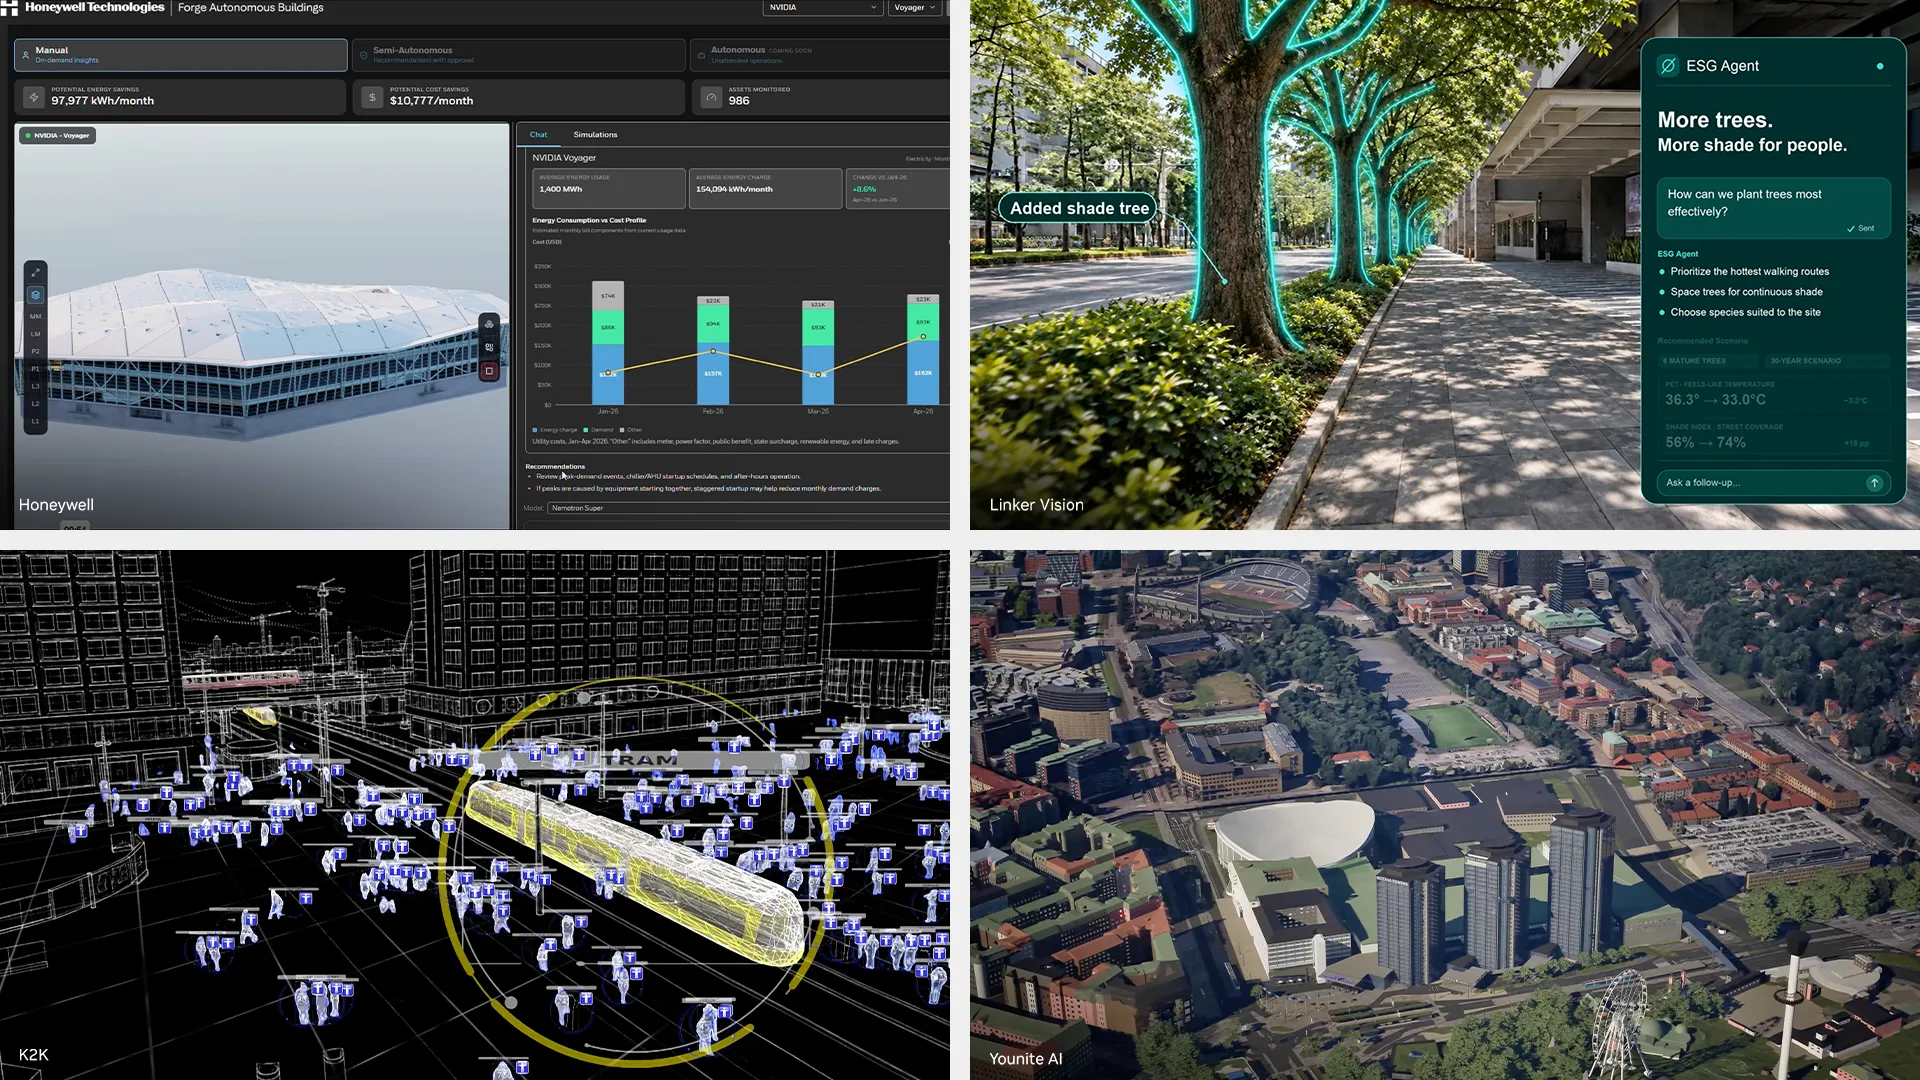
NVIDIA рассказала о европейских проектах, где агентные системы и цифровые двойники помогают городским службам работать с инфраструктурой, энергией и безопасностью. Это пока не единая городская автопилотная система, а набор пилотов и внедрений у местных партнёров.

NVIDIA готовит Nemotron 3.5 Bolt для локальных ИИ-агентов
13 октября 2026 г.
NVIDIA готовит Nemotron 3.5 Bolt для локальных ИИ-агентов

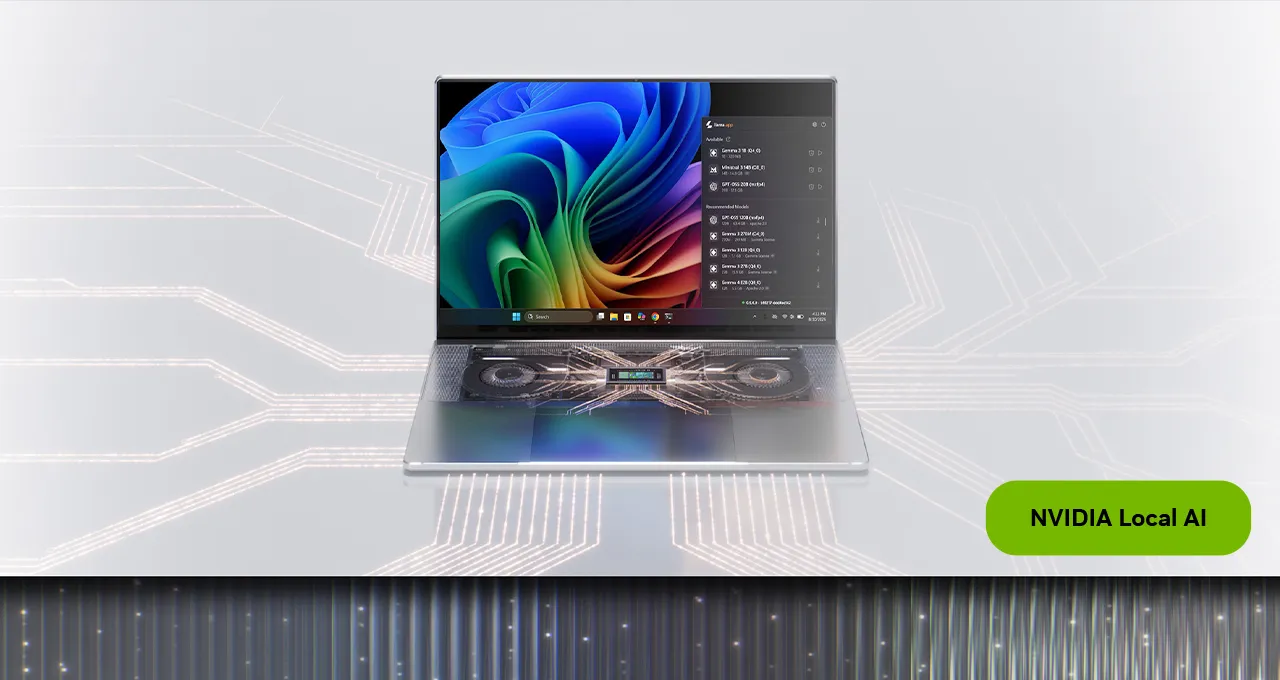
NVIDIA объявила, что 15 октября выпустит открытую модель Nemotron 3.5 Bolt 74B-A9B для локального запуска на RTX Spark. Модель занимает 24 ГБ после 2-битного квантования и рассчитана на агентные сценарии.

Boston Dynamics показала новые руки Atlas: меньше пальцев, больше ставки на обучение
13 октября 2026 г.
Boston Dynamics показала новые руки Atlas: меньше пальцев, больше ставки на обучение

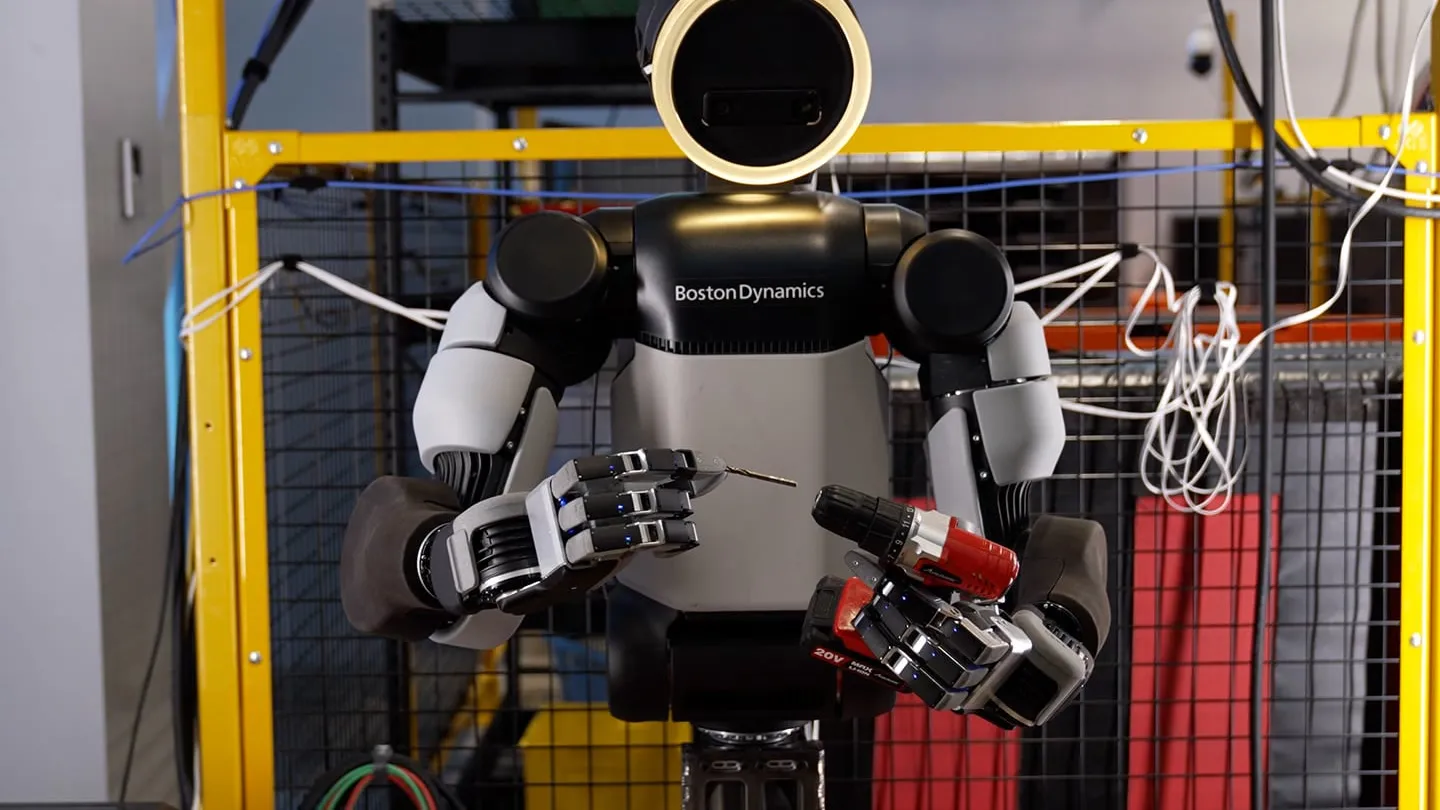
Boston Dynamics представила новую кисть для гуманоидного Atlas: четыре пальца, 13 степеней свободы и прямой привод. Смысл не в имитации человеческой руки, а в том, чтобы робота можно было надёжнее обучать манипуляциям в симуляции и переносить навык в реальный цех.

Character.AI подала на банкротство: сервис пока работает, но пользователям стоит забрать данные
13 октября 2026 г.
Character.AI подала на банкротство: сервис пока работает, но пользователям стоит забрать данные

Character.AI начала добровольную процедуру Chapter 11 ради продажи бизнеса под надзором суда. Платформа и подписки пока продолжают работать, но компания прямо допускает закрытие, если покупателя не найдут.