Alibaba esitles DeepPlanningut: uus standard tehisintellekti agentide keerukuse hindamiseks
DeepPlanning: Alibaba seab lati tuleviku “superagentidele”
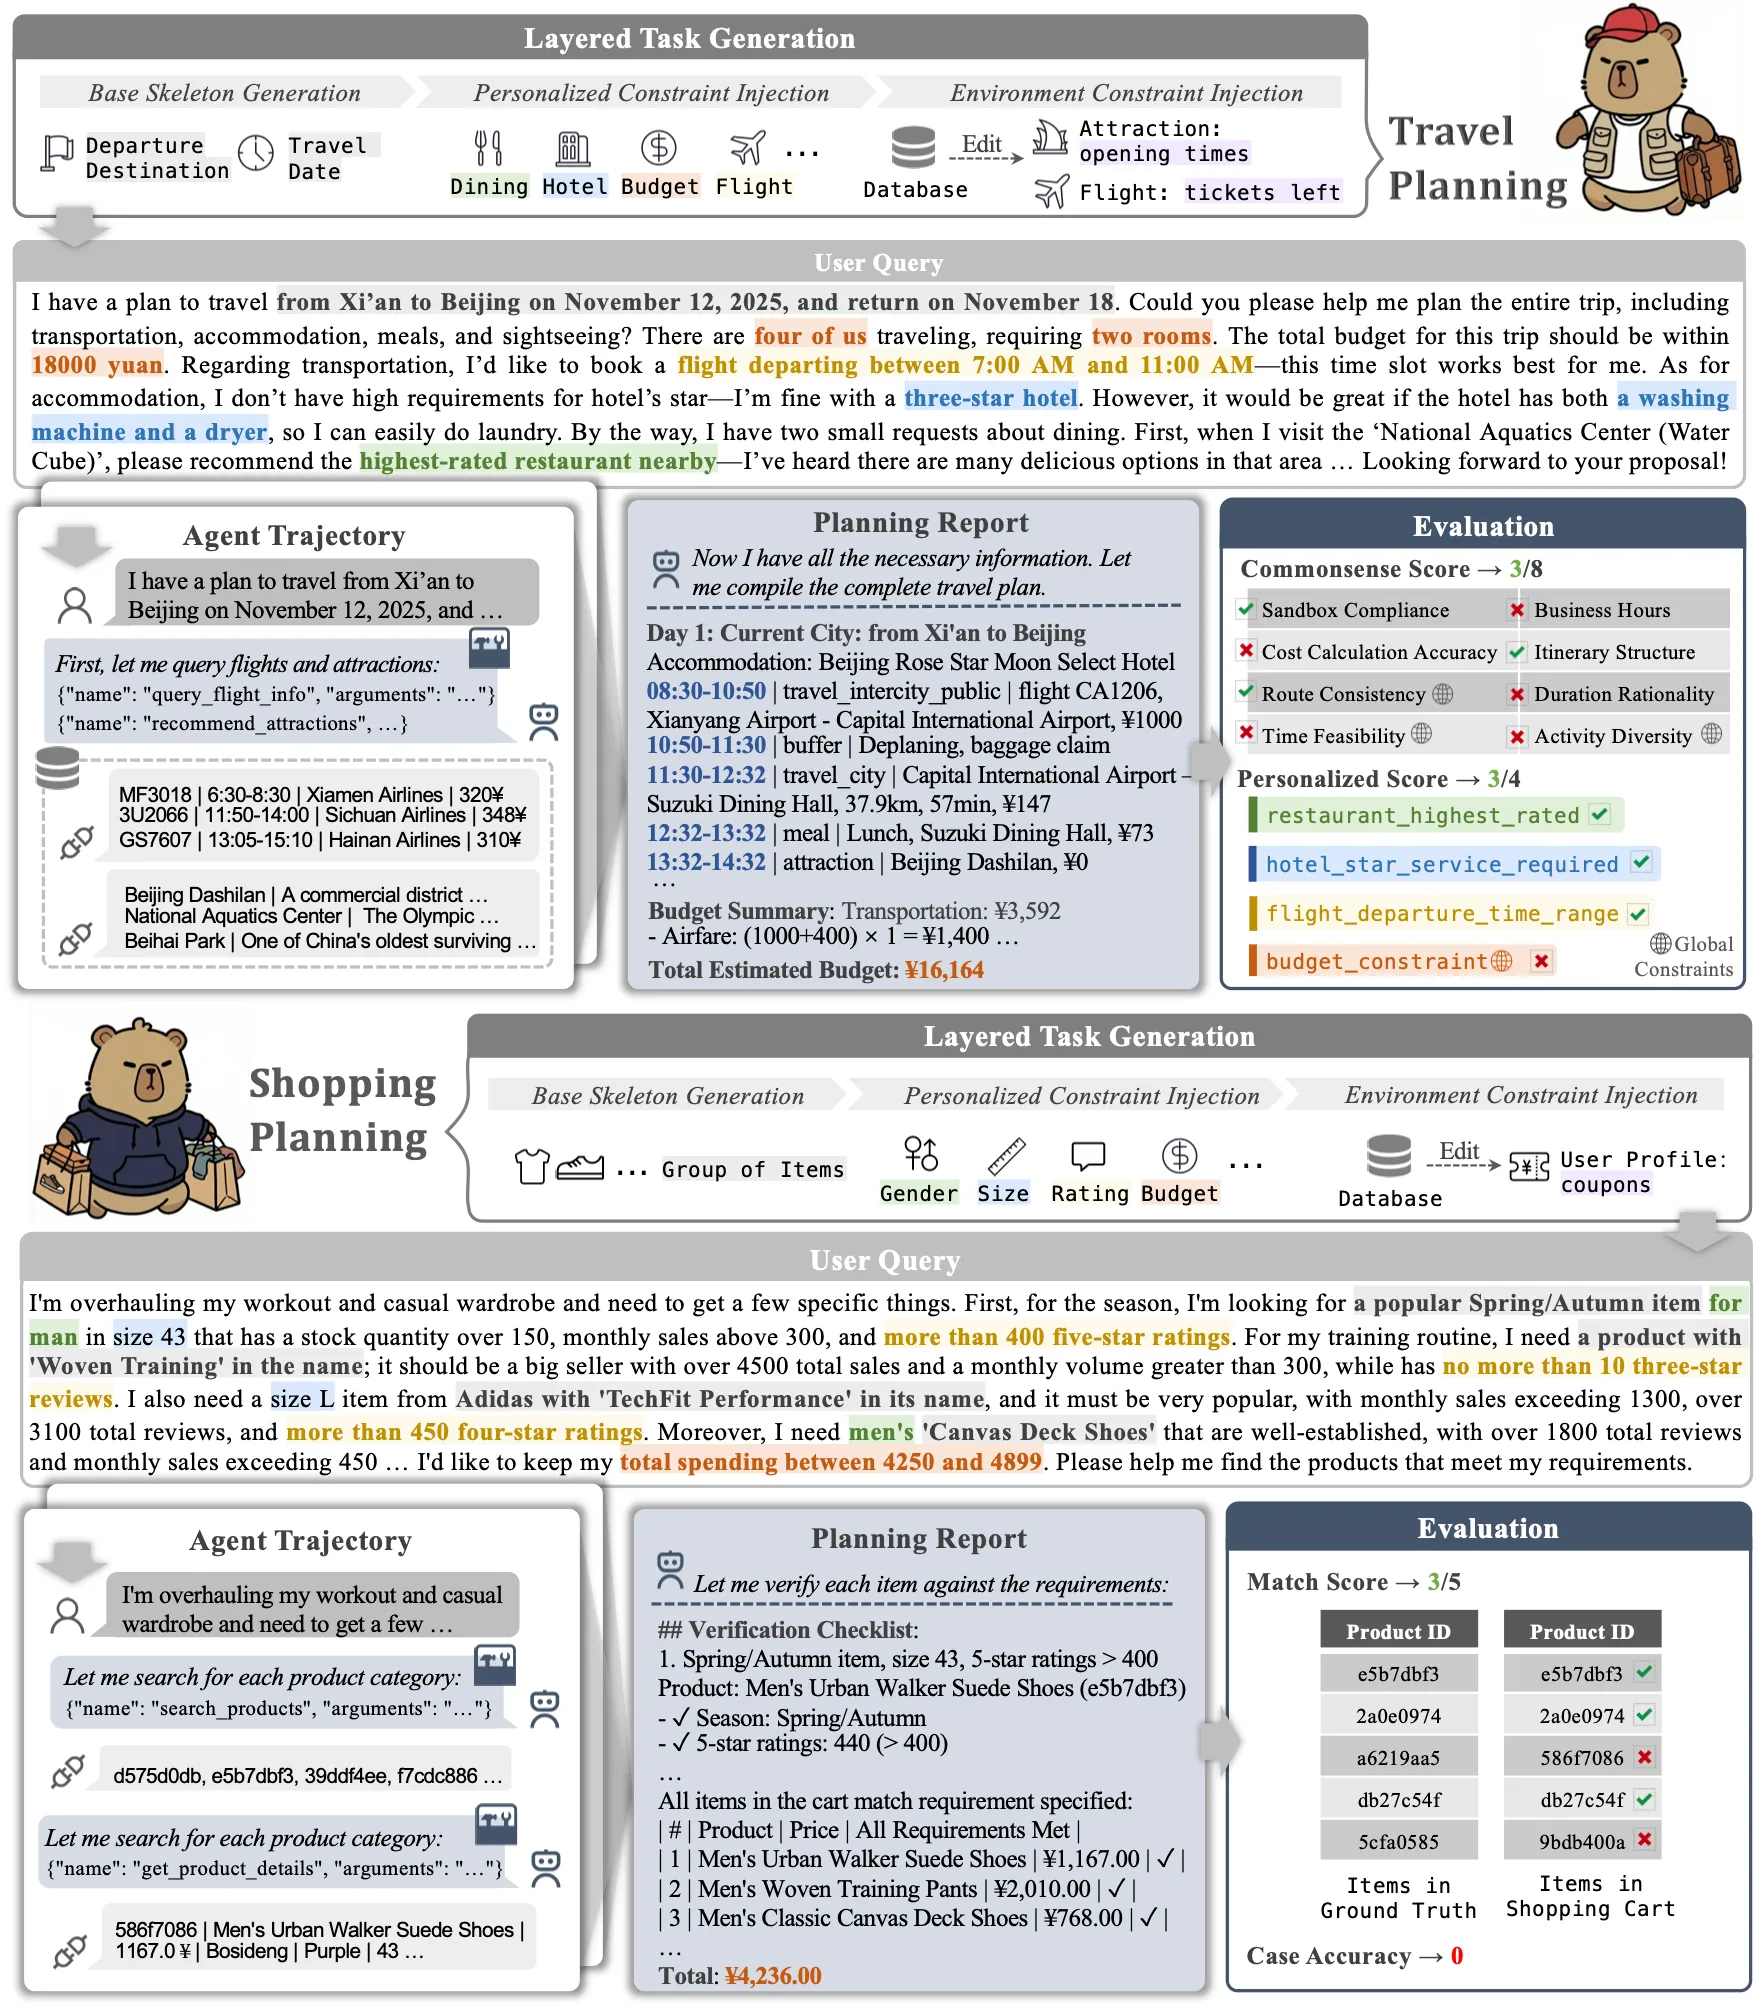
Alibaba Cloudi Qweni arendusmeeskond esitles DeepPlanningut – spetsialiseeritud benchmarki, mis on mõeldud autonoomsete tehisintellekti agentide hindamiseks keerulise mitmeetapilise planeerimise tingimustes. Erinevalt traditsioonilistest testidest, mis kontrollivad loogikat lühikestel distantsidel, keskendub DeepPlanning “pika horisondiga” ülesannetele, kus iga tehisintellekti tegevus peab vastama rangelt kontrollitavatele piirangutele, nagu eelarve, ajaraamid ja kasutaja isiklikud eelistused.
Üleminek chatbot’idelt täitjatele
Tehisintellektitööstus on 2026. aastaks lõplikult nihutanud fookuse lihtsatest tekstivastustest autonoomsete agentide loomisele. Kuid olemasolevad hindamismeetodid ei arvesta sageli tehisintellekti võimega aktiivselt infot koguda ja plaane reaalajas optimeerida. DeepPlanning on mõeldud selle lünga täitmiseks, pakkudes stsenaariume reaalsest elust: mitmepäevaste reiside planeerimine ja keerulised kaubandusostud.
Testi raames ei pea tehisintellekti agent mitte lihtsalt küsimusele vastama, vaid koostama üksikasjaliku marsruudi või ostunimekirja, kasutades spetsialiseeritud API-sid lennupiletite ja hotellide otsinguks ning hindade analüüsimiseks. Peamine keerukus seisneb “globaalsetes piirangutes” – näiteks peab agent planeerima reisi 1000 euro piires, arvestades asutuste lahtiolekuaegu ja linnadevahelist logistikat.
Kaasaegsed mudelid ei toime tule
DeepPlanning raames esimeste testide tulemused osutusid arendajatele kainestavaks. DeepPlanningu raames tehtud esimeste testide tulemused olid arendajatele kainestavad. Qweni meeskonna aruande kohaselt demonstreerivad isegi kõige võimsamad kaasaegsed mudelid, sealhulgas propriteetsed lippulaevasüsteemid, madalat efektiivsust pika planeerimistsükliga ülesannete lahendamisel.
“DeepPlanningu raames tehtav hindamine näitab, et isegi tipptasemel agentide keelemudelid tulevad nende ülesannetega vaevalt toime, mis rõhutab usaldusväärsete järeldamismustrite ja tööriistade paralleelse kasutamise olulisust parema efektiivsuse saavutamiseks,” märkivad uuringu autorid.
Peamised vead tekivad eri allikatest pärinevate andmete integreerimise etapil ja vajadusel plaani korrigeerida, kui avastatakse uusi piiranguid. See viitab sellele, et mudelite “mälu” ja “tähelepanu” vajavad täisväärtuslikuks autonoomseks tööks endiselt arhitektuurilisi täiustusi.
Tehnilised detailid ja avatud lähtekood
Benchmark hõlmab 120 keerukat ülesannet inglise ja hiina keeles, mida toetab 9 spetsialiseeritud tööriistast koosnev komplekt reiside jaoks ja 15 tööriista ostlemise jaoks. Testimine toimub isoleeritud Pythoni liivakastides, mis võimaldab verifitseerida agendi iga tegevust.
Qweni meeskond otsustas DeepPlanningu lähtekoodi kogukonnale avada. See võimaldab kolmandatel arendajatel testida oma mudeleid identsetes tingimustes, mis peaks kiirendama tõeliselt usaldusväärsete digitaalsete abiliste ilmumist, mis suudavad rutiinse organisatsioonilise töö enda peale võtta.
💬 Neuro.ee toimetuse arvamus
DeepPlanningu ilmumine tähistab "tühjade" benchmarkide ajastu lõppu. Kasutajatele tähendab see, et lähima paari aasta jooksul näeme reaalset progressi tehisintellekti abiliste usaldusväärsuses: nad lõpetavad lihtsalt hotellide soovitamise ja hakkavad neid päriselt broneerima, arvestades iga senti teie rahakotis.
- qwenlm.github.ioQwen Agent: AI Agent Framework Documentation
- getmaxim.aigetmaxim.ai
- alibabacloud.comAlibaba Cloud Unveils Strategic Roadmaps for the Next Generation AI Innovations
- huggingface.coQwen (Qwen)
- siliconflow.comUltimate Guide - The Best Qwen Models in 2026
- qwen.aiQwen
- brief.bismarckanalysis.comAI 2026: Alibaba's Qwen Seeks to Encourage AI Adoption