OpenAI tõi välja GPT-5.5 ja nihutab mudelivõistluse autonoomse töö faasi
OpenAI tõi välja GPT-5.5 ja nihutab mudelivõistluse autonoomse töö faasi
OpenAI alustas GPT-5.5 ja GPT-5.5 Pro väljalaset — uut mudeliperekonda, mida ettevõte kirjeldab järgmise sammuna AI suunas, mis suudab teha arvutis keerulist tööd, mitte ainult vestluses vastata. Mudel jõuab juba tasuliste ChatGPT ja Codexi kasutajateni ning 24. aprillil uuendas OpenAI teadet: GPT-5.5 ja GPT-5.5 Pro said kättesaadavaks ka API-s, koos täiendavate kaitsemeetmete nõuetega.
Relisi peamine intriig ei seisne selles, et mudel on eelmisest „targem“. See on võidujooksu ootuspärane osa. Olulisem on muu: OpenAI nihutab toote raskuskeskme selgelt pikkade agentsete ülesannete poole — programmeerimine, uurimistöö, andmeanalüüs, dokumentide loomine ja töö tööriistade kaudu. Teisisõnu valdkondadesse, kus AI ei konkureeri enam otsingu või copywriting’uga, vaid ettevõtete operatiivse töö osaga.
Abilisest täitjaks
OpenAI väitel mõistab GPT-5.5 paremini kasutaja kavatsust, plaanib tööd, kasutab tööriistu, kontrollib tulemust ja jätkab ülesande lahendamist ebakindluse tingimustes. Praktiliselt tähendab see liikumist stsenaariumist „palun kirjuta mulle tekst või koodijupp“ stsenaariumini „anna mudelile mitmeastmeline töö ja oota kontrollitavat tulemust“.
Benchmarkides näitab ettevõte suurimat kasvu just seal, kus mõõdetakse autonoomiat. GPT-5.5 saab 82,7% Terminal-Bench 2.0-s — keerukate käsurea-workflow’de testis, 78,7% OSWorld-Verifiedis — kontrollis, kas mudel suudab töötada päris arvutikeskkondades, ning 84,9% GDPvalis, mis mõõdab majanduslikult tähenduslike knowledge work’i ülesannete täitmist. FrontierMath Tier 4 tulemus ulatub GPT-5.5 puhul 35,4% ja Pro versioonil 39,6% tasemele.
Neid numbreid ei tasu üle tõlgendada otsese prognoosina töötajate asendamise kohta. Benchmarkid jäävad kunstlikuks raamiks. Kuid suund on selge: frontier-mudelid ei võistle enam ainult õige vastuse andmises, vaid võimes hoida eesmärki, liikuda läbi liideste ja töö tervikuna lõpuni viia.
Miks see jätkab Codexi liini
Neuro.ee jaoks näeb see väljalase välja kui jätk veebruarikuisele GPT-5.3-Codexi loole, kus OpenAI näitas juba autonoomsele programmeerimisele mõeldud erimudelit. Siis oli loo keskmes Codex kui eraldi töökiht inseneridele. GPT-5.5 laiendab sama loogikat väljapoole puhast koodi: arendus jääb peamiseks katsepolügooniks, kuid kõrvale tekivad finantsid, operatiivne analüüs, dokumendid, tabelid, sisearuanded ja äriprotsesside tugi.
OpenAI toob näidetena kasutuse omaenda ettevõttes: Codexit kasutab nädalas üle 85% töötajatest, mudel on analüüsinud 24 771 K-1 maksuvormi kogumahuga 71 637 lehekülge, automatiseerinud osa avalike esinemiste päringute töötlemisest ja aidanud koostada regulaarseid äriaruandeid. See pole enam arendajatele mõeldud demo, vaid katse näidata ettevõtteturule uut töömustrit: mudel ei „soovita“, vaid kinnistub tootmisprotsessi.
Turutähendus: konkurentsi uus ühik
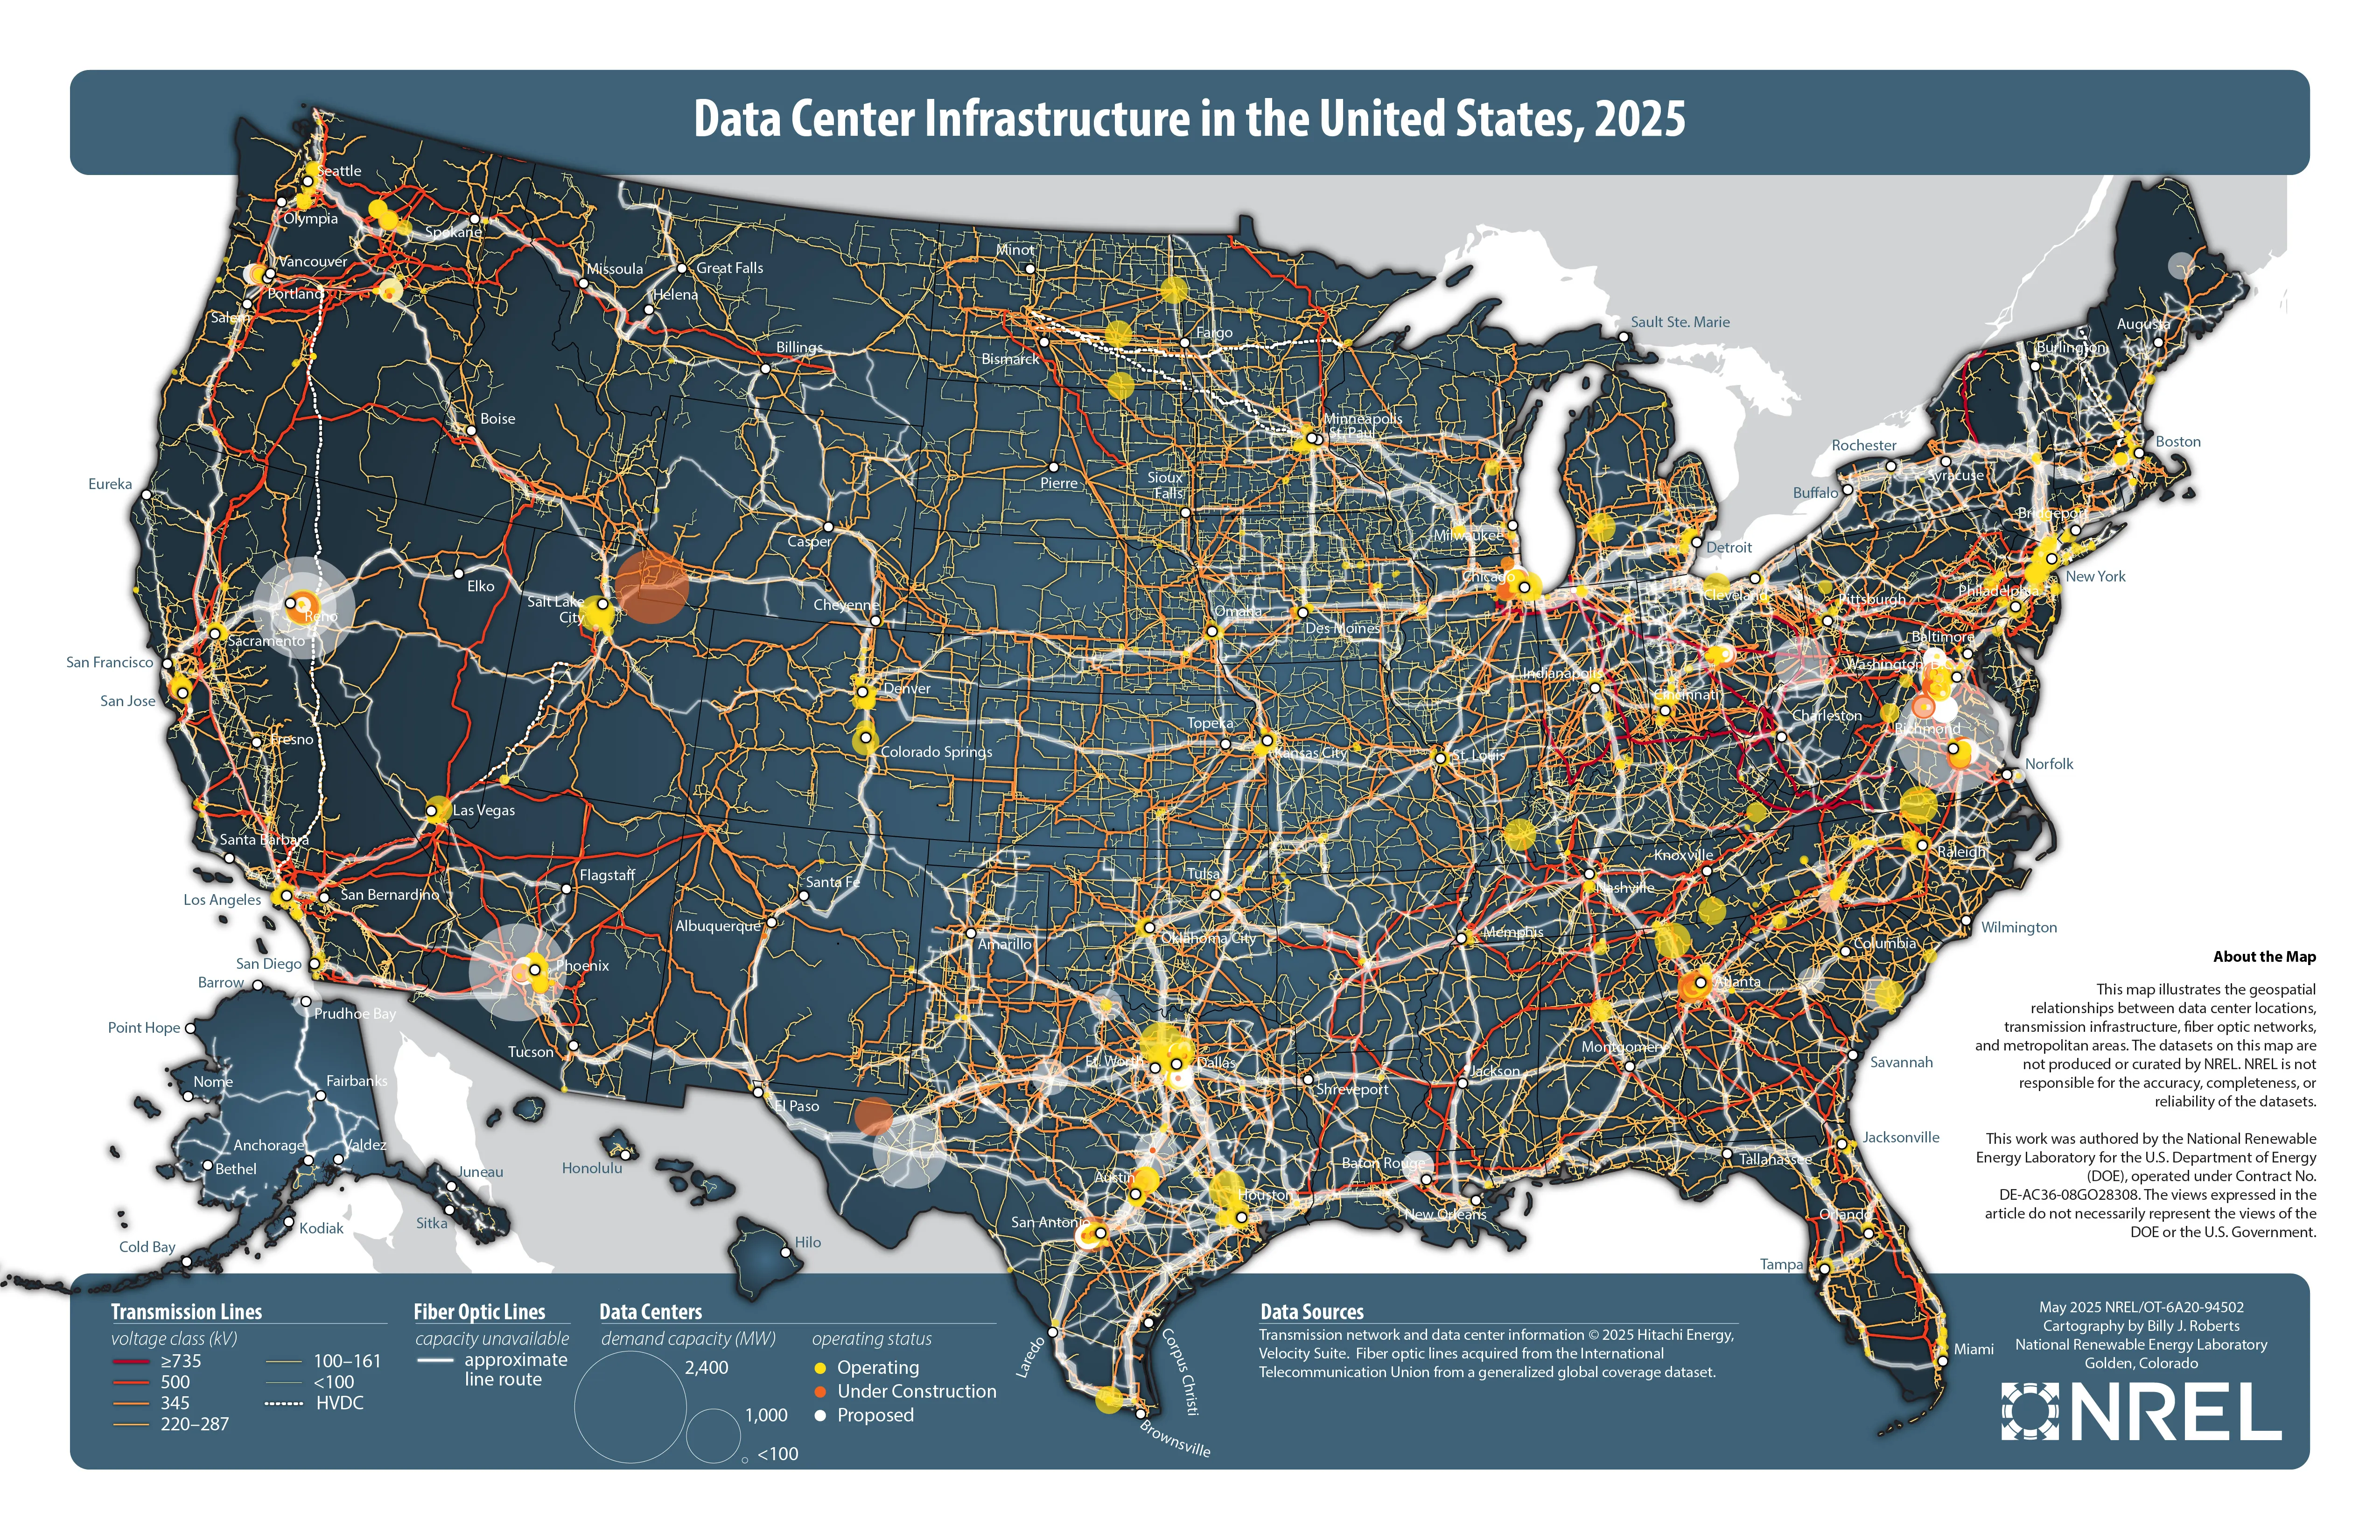
GPT-5.5 väljalase muudab OpenAI, Anthropic’u ja Google’i konkurentsi tooni. Kui viimastel nädalatel arutas turg palju infrastruktuuri — andmekeskusi, energiat, TPU-sid ja kontrolli arvutusvõimsuse üle —, siis siin toob OpenAI vestluse tagasi rakenduskihi juurde: kes saab põhiliseks liideseks töö tegemisel.
Seetõttu on oluline ka Artificial Analysise sõltumatu käsitlus. Nende hinnangul viis GPT-5.5 OpenAI taas selgelt esikohale Intelligence Indexis, edestades Anthropic’ut ja Google’it ligikaudu kolme punktiga. Pilt ei ole siiski täielik triumf: Artificial Analysis märgib, et GPT-5.5 indeksi jooksutamine muutus umbes 20% kallimaks, kuigi tokenikasutus vähenes ligikaudu 40%, ning privaatses AA-Omniscience testis näitab mudel kõrget täpsust, kuid endiselt probleemset kalduvust vastata ka siis, kui kindlusest ei piisa.
Ettevõtteostjate jaoks on see 2026. aasta keskne kompromiss. Neil pole vaja kõige jutukamat mudelit, vaid süsteemi, mille hind, riskid ja vastutusahel on etteaimatavad. Mida rohkem mudel ise tegutseb, seda kallimaks muutub viga — koodis, andmetes, dokumentides või finantsprotsessides.
Turvalisus muutub toote osaks
OpenAI rõhutab eraldi, et GPT-5.5 läbis laiendatud kontrollid Preparedness Frameworki alusel, sealhulgas testimise küberturbe ja bioloogiliste riskide osas, sise- ja välise red-teaming’u ning tagasiside ligi 200 varaselt partnerilt. System card’is kirjutab ettevõte, et API-deploy nõuab täiendavaid kaitsemeetmeid, sest sellise mudeli mastaapne teenindamine muudab riskiprofiili.
See on oluline detail. Juturobotite ajastul mõeldi turvalisusest sageli kui vastuse filtrist. Agentide ajastul on turvalisus tegevuspiirangute süsteem: mida mudel võib käivitada, kuhu kirjutada, milliseid andmeid lugeda, millised operatsioonid nõuavad inimese kinnitust ja kes vastutab tagajärgede eest.
Neuro.ee toimetuse arvamus
GPT-5.5 ei ole lihtsalt järjekordne numbrirelis. See on OpenAI katse kinnistada frontier-mudeli uus standard: mitte „vastab paremini“, vaid „töötab kauem ja usaldusväärsemalt“. Kui GPT-5.3-Codex oli signaal arendajatele, siis GPT-5.5 on signaal kogu ettevõttekihile, kus töö koosneb failidest, liidestest, kontrollidest, tabelitest, ticket’idest ja tagajärgedega otsustest.
AI-turg liigub faasi, kus ei võida see, kes esimesena laval muljetavaldava vastuse näitab, vaid see, kes suudab autonoomsed tegevused turvaliselt igapäevasesse äristruktuuri sisse ehitada. OpenAI panustab praegu just sellele. Kui tal on õigus, ei hakka tavapärane SaaS-turg kahanema ühe funktsiooni tõttu, vaid ostjate uue küsimuse tõttu: milleks maksta kümnete eraldi tööriistade eest, kui agent saab töötada nende peal universaalse täitjana?