NVIDIA NVFP4: rohkem jõudlust vähem mäluga
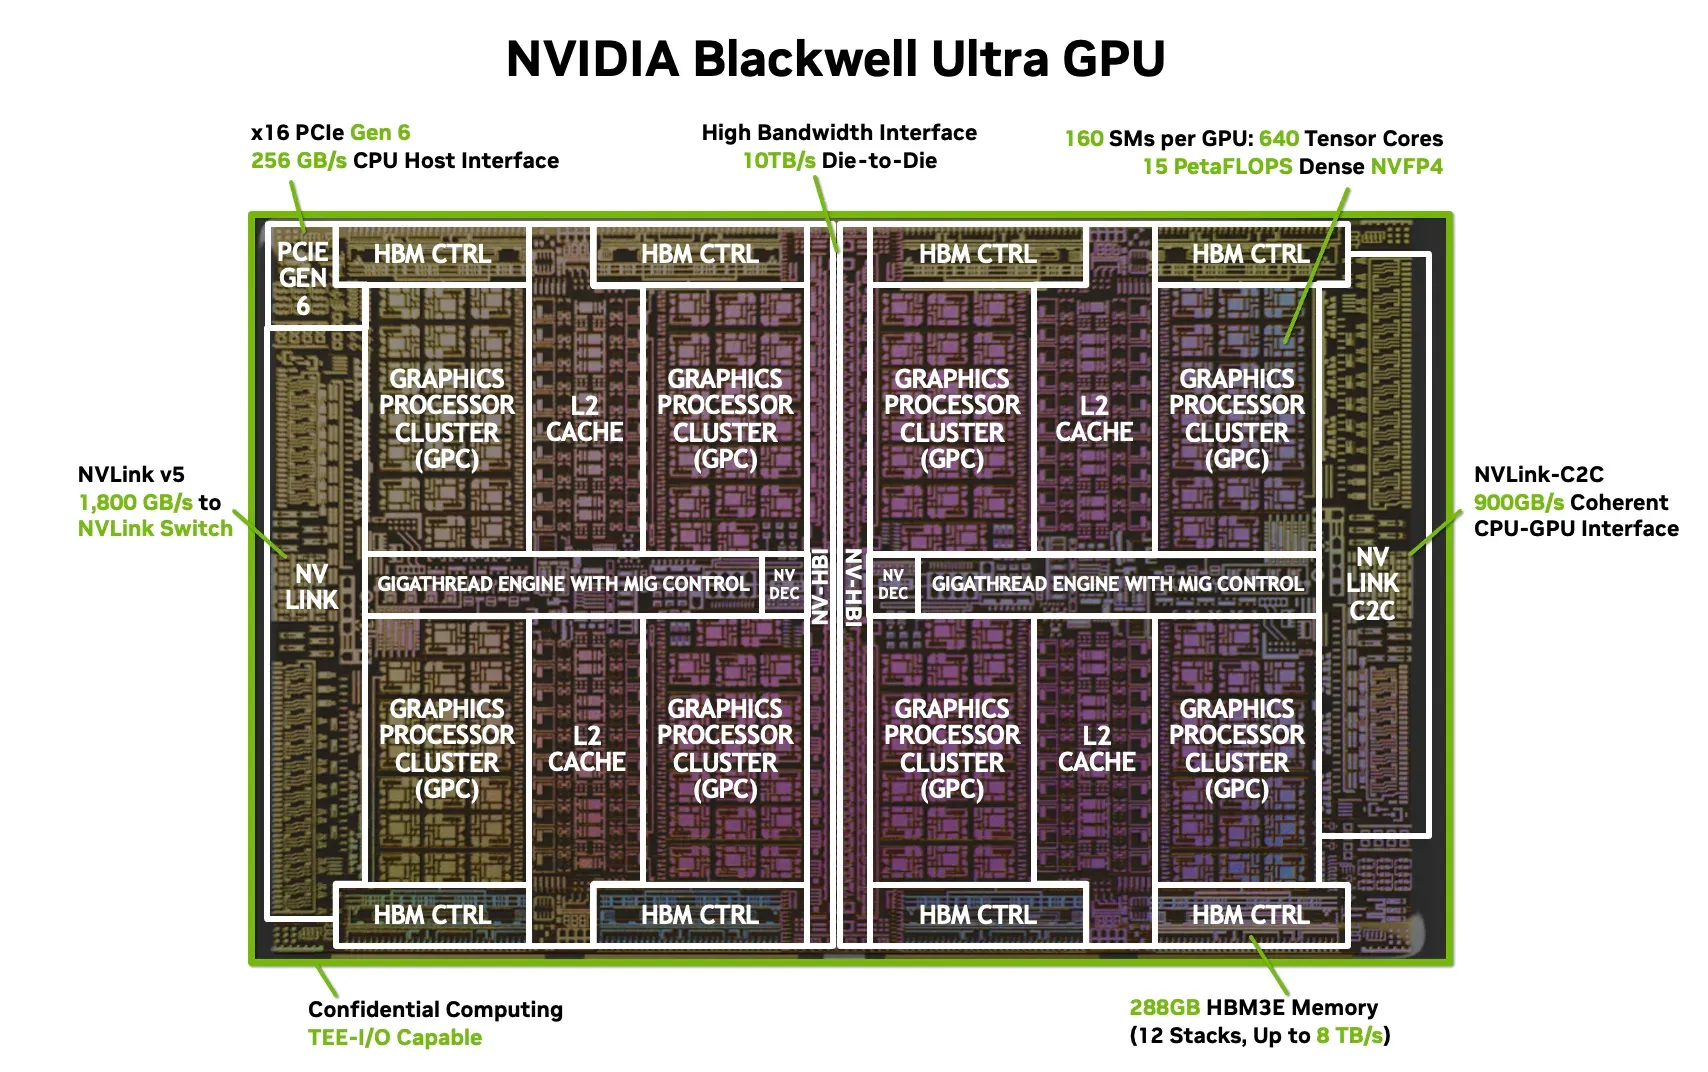
NVIDIA tõi välja NVFP4 vormingu ja NVFP4-le optimeeritud Nemotroni mudelid. Praktiline mõju: samal riistvaral saab käitada suuremaid mudeleid kiiremini.
Mis juhtus?
NVIDIA tutvustas NVFP4 formaati (4-bitine ujukoma), mis on mõeldud eelkõige Blackwelli arhitektuurile. Erinevalt klassikalisest INT4 kvantimisest püüab NVFP4 säilitada täpsust parema skaleerimismehhanismi abil.
Koos sellega avaldati NVFP4 kujul ka Nemotron-3 Nano-30B. NVIDIA sõnul aitab QAD (Quantization-Aware Distillation) hoida täpsust BF16-le lähedal, vähendades samas mudeli mälumahtu.
Miks see ei ole lihtsalt INT4?
NVFP4 kasutab kahetasandilist skaleerimist:
- Mikroplokid (16 väärtust): igal plokil on oma FP8 skaalategur.
- Globaalne FP32 skaala: lisatakse kogu tensori tasandil.
See parandab kompromissi täpsuse ja mahu vahel võrreldes lihtsama 4-bitise kvantimisega.
Miks see oluline on?
- Väiksem mälusurve: suured mudelid mahuvad väiksemale GPU-arvule.
- Ökosüsteemi tugi: NVFP4 tugi jõuab kiiresti tööriistadesse nagu TensorRT-LLM, vLLM ja SGLang.
- Kiirem tootmiskasutus: Blackwelli platvormil tähendab see suuremat läbilaset nii treenimisel kui inferentsil.
Neuro.ee toimetuse arvamus
NVIDIA kinnitab taas, et kontrollib korraga nii riistvara kui optimeerimiskihti. Kui varem oli agressiivne kvantimine pigem hädapärane kompromiss, siis NVFP4-sarnased formaadid nihutavad selle tootmisklassi standardiks.
- aasta lõpuks võib FP16 olla paljudes inferentsikoormustes pigem erand kui vaikimisi valik.