Kohalikud AI-mudelid said kiirendi: llama.cpp lisas MTP ja tegi Qweni märgatavalt kiiremaks
Kohalikud AI-mudelid said kiirendi: llama.cpp lisas MTP ja tegi Qweni märgatavalt kiiremaks
llama.cpp-sse liideti MTP ehk Multi Token Predictioni tugi. Kohaliku AI maailmast väljaspool võib see kõlada nagu järjekordne GitHubi sügavustest pärit lühend, kuid mõte on üsna maine: mudelid õpivad vastama kiiremini ilma eraldi väikese draft-mudelita, mida varem tuli speculative decoding’u jaoks sageli kõrvale lisada.
Tavaline LLM kirjutab vastust tokeni kaupa: ennustab järgmise tekstijupi, lisab selle konteksti ja liigub edasi. MTP lubab mudelil ette pakkuda mitu järgmist tokenit. Seejärel otsustab põhikontroll, millised neist päriselt sobivad. Kui ennustus on õige, hüppab genereerimine mitmest sammust korraga üle. Kui ei ole, visatakse üleliigne ära ja mudel jätkab tavakiirusel.
Peamine uudis ei ole teoorias, vaid selles, et see jõudis nüüd llama.cpp-sse - ühte tähtsaimasse tööriista open-weight mudelite käitamiseks kohalikes arvutites, tööjaamades ja väikestes serverites. Selle kaudu elavad kodused assistendid, kohalikud vestlusliidesed, eksperimendid koodimudelitega ja ettevõttekomplektid, kus andmeid ei taheta pilve saata.
Mida täpselt lisati
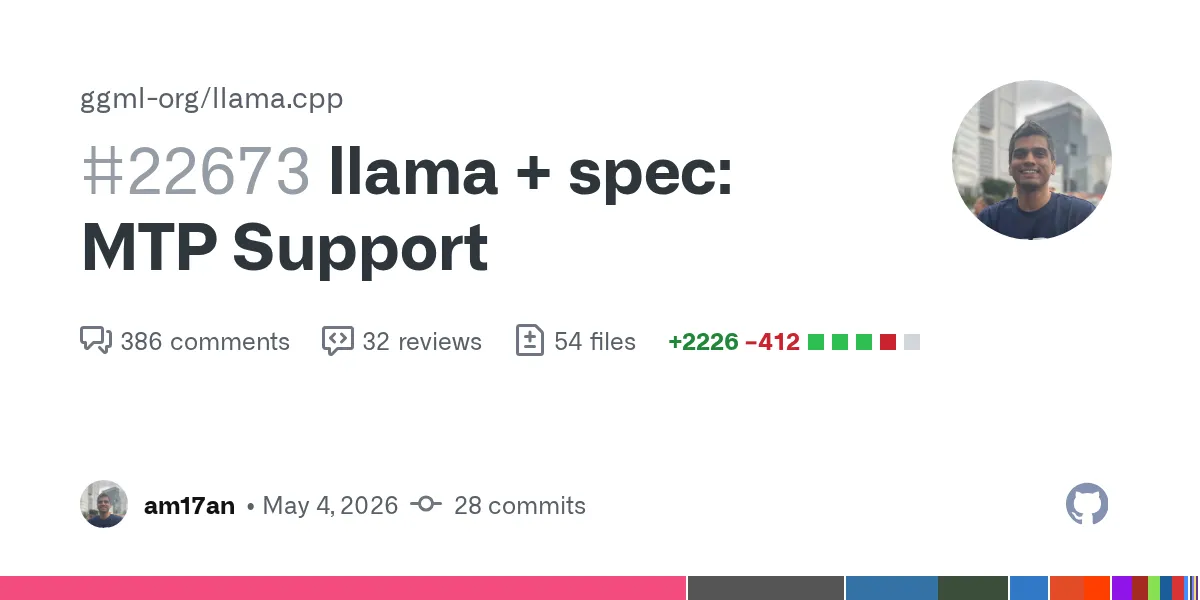
Tugi tuli PR #22673 kaudu. Autor testis mehhanismi Qwen3.6 27B ja Qwen3.6 35B-A3B peal. PR-i kirjelduses on kirjas, et MTP-mudel laaditakse samast GGUF-failist. See on oluline detail: kasutaja ei pea eraldi otsima väikest abimudelit, seda põhimudeliga sünkroonima ja lootma, et kogu kooslus seadistustes laiali ei jookse.
Sisuliselt asub järgmiste tokenite mustandkontuur toetatud mudeli sees või selle kõrval samas failis. Seetõttu paistab MTP massilise kohaliku kasutuse jaoks mugavam kui klassikaline kahe mudeli skeem. Laadid alla õige GGUF-i, lülitad vajalikud parameetrid sisse ja saad võimaluse kiirenduseks ilma liigse inseneriköögita.
See ei ole siiski maagiline turborežiim kõigile vanadele kaaludele. Mudel peab olema treenitud või kokku pandud MTP-peadega. Kui arhitektuuris neid ei ole, ei pane ainuüksi uus llama.cpp seda äkki kaks korda kiiremini kirjutama. Vaja on sobivaid komplekte, õigeid parameetreid ja edasist optimeerimist runtime’is.
Kui palju kiirem
Esimesed numbrid on märgatavad. PR-i benchmark’ides võtsid üheksa testülesannet Qwen3.6-ga ilma MTP-ta umbes 201 sekundit ja kiirus püsis ligikaudu 7 tokeni juures sekundis. MTP ja kuni kolme draft-tokeniga mahtusid samad ülesanded umbes 84 sekundi sisse. Mõnes stsenaariumis tõusis kiirus 16-22 tokenini sekundis.
Autor kirjutab ka, et stabiilses režiimis aktsepteeriti 72-75% ennustatud tokenitest. Just sellest sõltub võit: mida sagedamini mustandtokenid langevad kokku sellega, mida põhimudel on valmis vastu võtma, seda vähem samme tuleb teha järjestikku.
Piirangud on samuti otse välja öeldud. Tulemus sõltub mudelist, riistvarast, vastuse pikkusest, seadistustest ja paralleelsusest. PR märgib eraldi, et prompt’i töötlemine võib MTP-ga aeglustuda embedding’ute seadme ja hosti vahel liigutamise tõttu ning paralleelne dekodeerimine pole veel täielikult optimeeritud. Seega aus sõnastus ei ole „kõigil läks kolm korda kiiremaks“, vaid „sobivate mudelite jaoks tekkis reaalne tee genereerimise kahekordseks kiirendamiseks“.
Miks see oluline on
Kohalikud mudelid kaotavad pilvemudelitele sageli mitte ainult kvaliteedis, vaid ka kiiruse tunnetuses. Kasutaja võib olla valmis privaatsuse, hinna või kontrolli nimel keerukamat paigaldust taluma, kuid aeglane vastus muudab kasuliku tööriista kiiresti entusiastide mänguasjaks.
MTP tabab just seda nõrka kohta. Kui 27B või 35B mudel hakkab kohalikul riistvaral vastama pilvevestlusele lähemal tempol, muutub praktiliste stsenaariumide hulk: koodiassistent tööarvutis, privaatne dokumentide analüüs, kohalik automatsiooniagent, ettevõtte sisemine abiline ilma andmeid välisele pakkujale saatmata.
Eraldi on kõnekas, et testid käivad Qwen3.6 peal. Hiina open-weight mudelid ei paista benchmark’ides enam ammu eksootikana: Qweni, DeepSeeki ja naaberperekondi kasutatakse koodi, analüüsi, tõlke ja kohalike agentide jaoks. Kui MTP just seal hästi kinnistub, ei võida üks repo, vaid märgatav osa kohalikust ökosüsteemist.
Suur AI-võidujooks paistab tavaliselt uute mudelite väljalasetest. Päriselus on sama tähtis inference’i võidujooks: kui palju vastus maksab, kui kaua see aega võtab ja kas kõike saab käitada ilma pilve-API-ta. MTP tugi llama.cpp-s ei ole kohaliku AI lõplik võit, vaid kasulik insenerisamm selle poole, et tugev mudel oma arvutis vastaks mitte „kunagi hiljem“, vaid kohe.