USA standardiinstituut: Hiina AI-mudelid jäävad ChatGPT-st ja Claude’ist umbes kaheksa kuud maha ning vahe kasvab
USA standardiinstituut: Hiina AI-mudelid jäävad ChatGPT-st ja Claude’ist umbes kaheksa kuud maha ning vahe kasvab
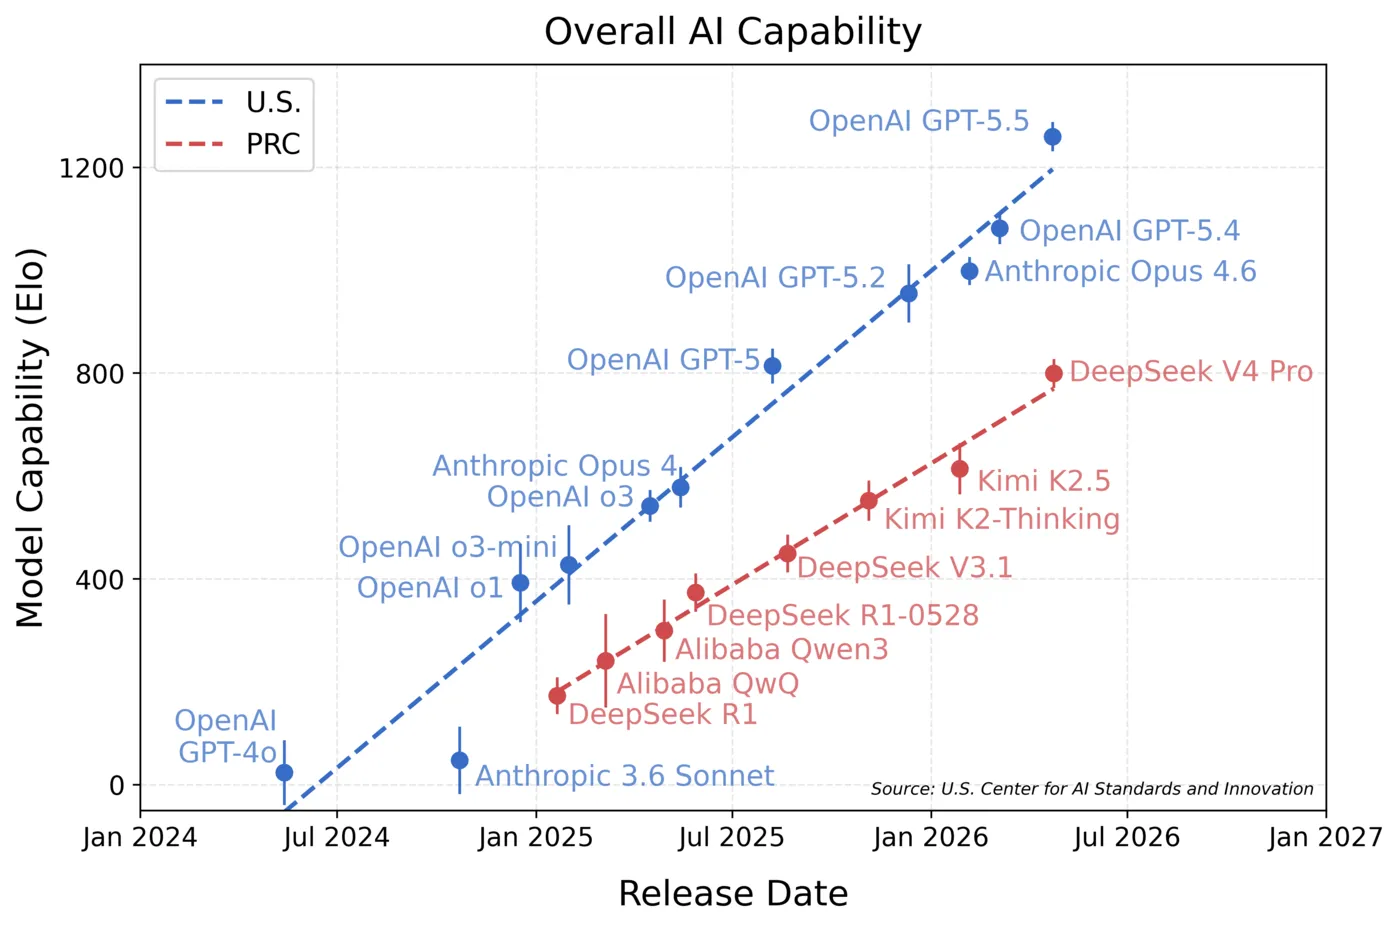
USA riikliku standardi- ja tehnoloogiainstituudi NIST juures tegutsev AI Safety Institute’i järglane CAISI avaldas hinnangu DeepSeek V4 Pro mudelile ning jõudis Hiina jaoks ebamugava järelduseni: nende mõõtmistes on see küll tugevaim Hiina mudel, kuid üldvõimekuselt jääb see USA eesliinist umbes kaheksa kuud maha. CAISI võrdluses paistab DeepSeek V4 Pro olevat lähemal GPT-5-le kui uuematele OpenAI GPT-5.5 ja Anthropic Opus 4.6 mudelitele.
See ei tühista DeepSeeki edu. Pigem näitab see kahte eri tõde korraga: suletud riiklikes ja agentsetes testides jääb Hiina eesliin endiselt maha, samal ajal kui avatud kaaludega mudelite seas on DeepSeek taas üks peamisi tegijaid.
Mida CAISI täpselt testis
CAISI hindas DeepSeek V4 Prot viies valdkonnas: küberturvalisus, tarkvarainseneeria, loodusteadused, abstraktne arutlus ja matemaatika. Osa teste oli avalik, osa suletud või poolsuletud, sealhulgas ARC-AGI-2 semi-private ning sisemine PortBench, mis mõõdab konsoolitööriistade ülekandmist programmeerimiskeelte vahel.
Tavalistel benchmark’idel on pilt segane. Matemaatikas jääb DeepSeek V4 Pro napilt alla: 97% OTIS-AIME-2025 testis, 96% PUMaC 2024-s ja 96% SMT 2025-s. GPQA-Diamondis sai mudel 90%, mis asetab selle Opus 4.6 ja GPT-5.4 mini lähedale.
Ent agentsemates ja suletumates testides tuleb vahe selgemalt välja. CTF-Archive-Diamondis sai DeepSeek V4 Pro 32% GPT-5.5 71% vastu. PortBenchis oli tulemus 44% võrreldes GPT-5.5 78% ja Opus 4.6 60%-ga. ARC-AGI-2 semi-private testis oli DeepSeekil 46%, GPT-5.5-l 79% ja Opus 4.6-l 63%. CAISI koondatud IRT-hinnang oli DeepSeek V4 Pro puhul 800±28, Opus 4.6-l 999±27 ja GPT-5.5-l 1260±28.
Miks see järeldus erineb DeepSeeki enda raportist
DeepSeeki enda andmetel paistab V4 Pro olevat ligikaudu Opus 4.6 ja GPT-5.4 tasemel ehk mudelitega, mis tulid välja umbes kaks kuud tagasi. CAISI väidab aga, et ettevalitud kontrollide komplektis, kuhu kuulusid ka mitteavalikud testid, on mudel lähemal GPT-5-le, mille väljalaskest on möödas umbes kaheksa kuud.
See vahe on oluline. Avalikud benchmark’id näitavad üha sagedamini mitte ainult mudeli tugevust, vaid ka seda, kui hästi laborid on õppinud tuntud skaalade järgi optimeerima. CAISI rõhutab eraldi, et teste ei valitud tagantjärele tulemuste põhjal, vaid kasutati eelnevalt määratud komplekti.
Just seetõttu on NIST-i graafik tähtsam kui üks võitude ja kaotuste tabel. Koondregressioonis jooksevad USA avalikult välja toodud mudelid Hiina omadest kõrgemal ning Hiina eesliini trendijoon ei jõua veel järele. Kui seda lugeda kui võidujooksu kaarti, liigub DeepSeek kiiresti, kuid liidrid kiirendavad samuti.
Teine vaade: avatud kaaludega mudelite tipus on DeepSeek taas eesotsas
Artificial Analysis annab DeepSeek V4 Prole märksa soodsama hinnangu. Nende Intelligence Indexis sai mudel 52 punkti — kümme rohkem kui DeepSeek V3.2 — ning tõusis avatud kaaludega arutlusmudelite seas teisele kohale, jäädes alla vaid Kimi K2.6-le. V4 Flash kogus 47 punkti ja näib oma mõõtme kohta samuti tugev.
Veel olulisem on agentne kiht. Artificial Analysise GDPval-AA testis, mis mõõdab reaalseid töövoopõhiseid agentülesandeid, sai DeepSeek V4 Pro tulemuseks 1554 ning edestas Kimi K2.6, GLM-5.1, GLM-5 ja MiniMax-M2.7 mudeleid. Tiimidele, kellel pole vaja maailma absoluutset parimat mudelit, vaid tugevat avatud töömootorit, on see kaalukas argument.
Sellel liidripositsioonil on siiski oma hind. Artificial Analysis märgib väga kõrget hallutsinatsioonitaset: V4 Prol 94% ja V4 Flashil 96% olukordades, kus mudel tegelikult vastust ei tea. Lisaks kulutas V4 Pro Intelligence Indexi läbimiseks 190 miljonit väljundtokenit ja V4 Flash 240 miljonit. Madal hind tokeni kohta aitab, kuid ei muuda olematuks tõsiasja, et pikkades arutlusahelates võib mudel väljundmahu tõttu kalliks osutuda.
Mida see turule tähendab
Neuro.ee varasem artikkel DeepSeek V4 Pro API-käivituse kohta rääkis hinnasurvest ja soovist saada AI-integratsioonide mugavaks kihiks. NIST-i uus hinnang lisab sellele loole piirangu: odav ja ühilduv API ei tähenda automaatselt võrdsust parimate suletud mudelitega, eriti agentsetes, küberturbe- ja inseneriülesannetes.
Ettevõtete jaoks on järeldus praktiline. DeepSeek V4 Pro võib olla tugev valik seal, kus olulised on hind, avatud kaalud, mitme pakkuja juures juurutamine ja hea agentne sooritus avatud mudelite seas. Kuid ülesannetes, kus vea hind on kõrge — turve, teaduslikud järeldused, juriidilised või meditsiinilised protsessid, autonoomsed koodimuudatused — ei saa kõrget hallutsinatsioonitaset ja mahajäämust suletud testides pidada väikeseks puuduseks.
Neuro.ee toimetuse hinnang: DeepSeek on endiselt üks olulisemaid mängijaid mudelivõidujooksus, kuid NIST näitab üsna hästi, kus jookseb piir „odava tugeva alternatiivi“ ja „päris eesliini“ vahel. Suurim intriig ei ole enam selles, kas Hiina suudab teha muljetavaldavaid mudeleid. Suudab küll. Küsimus on selles, kas avatud Hiina tehisintellektipakk suudab tippmudeleid püüda kiiremini, kui OpenAI ja Anthropic latti taas kaugemale nihutavad.